
RyanYr/pg-dapo_shuffled-0_offline-pg-dapo-qwen3-4B-Base-mbs128-n4_kl_behavior_matheval
收藏数据链接:
官方服务:
资源简介:
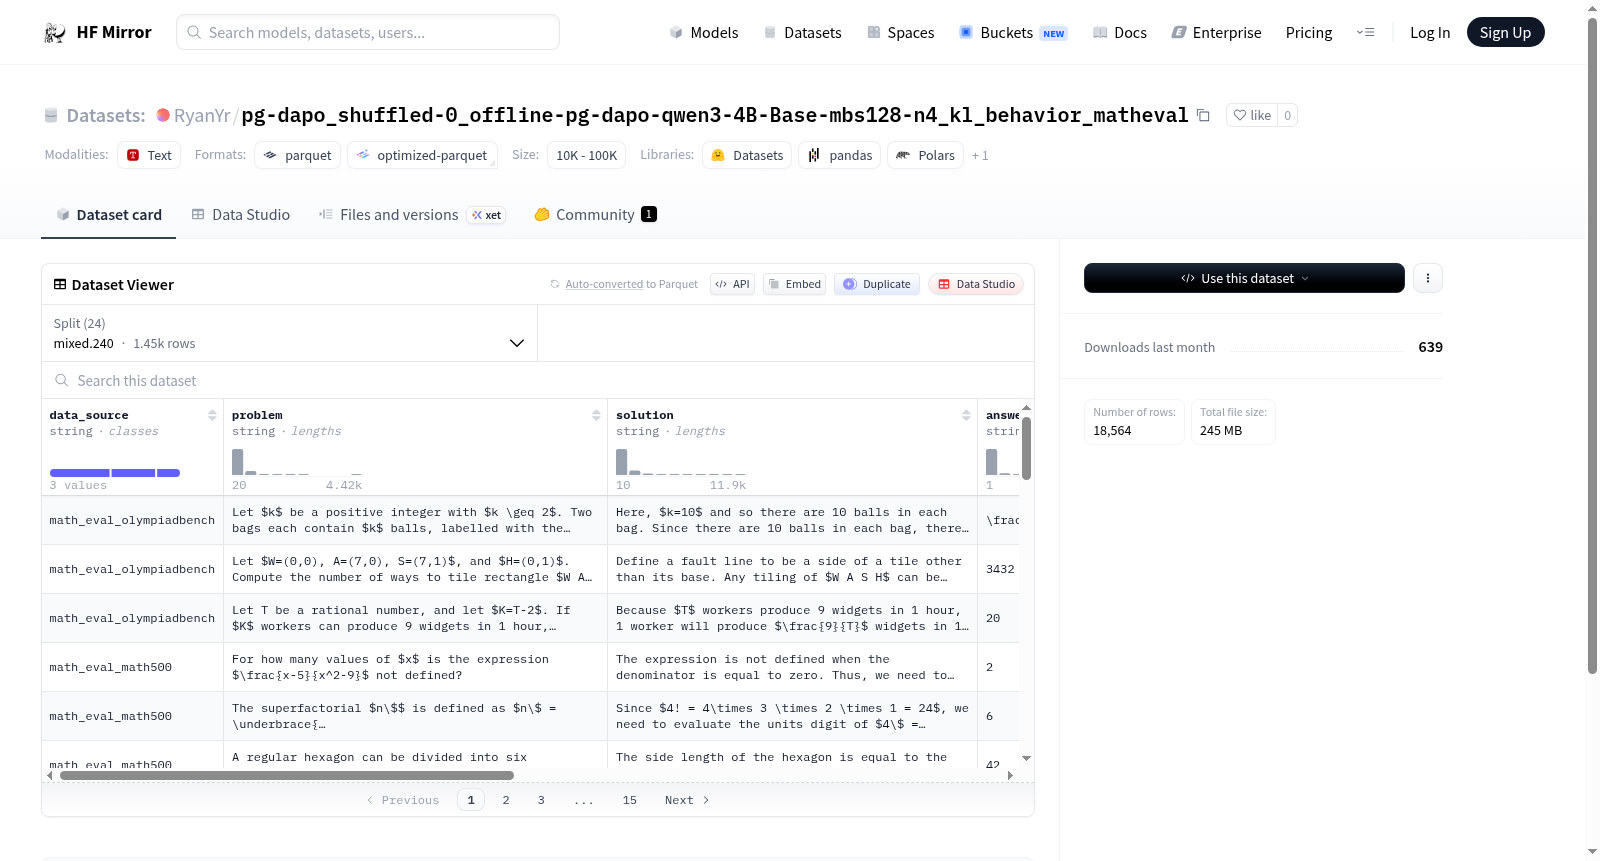
该数据集包含问题、解决方案、答案、提示、奖励模型和多个响应。数据分为多个子集,包括混合难度和困难难度,分别对应不同参数(如240,220等)。数据集可用于训练或评估对话系统或问答模型。
The dataset contains features: data_source, problem, solution, answer, prompt, reward_model, and responses. It is split into mixed and hard subsets with different numerical values (e.g., 240, 220, ... 20), likely representing different difficulty levels or parameters. This dataset is suitable for training or evaluating dialogue systems or question-answering models.
提供机构:
RyanYr搜集汇总
数据集介绍
构建方式
该数据集专为强化学习中的离线策略梯度算法设计,基于Qwen3-4B-Base模型在数学评估任务上的行为克隆与KL正则化过程生成。数据采集自模型对数学问题的多轮应答,每轮包含原始问题、标准答案及模型生成的多样化响应序列。数据集的构建以难度层级(如hard与mixed)和温度参数(从20到240不等)为双维度进行划分,共计24个分片,每个分片内收录了1447条混合难度样本与100条高难度样本,确保了训练数据的全面性与挑战性。
特点
数据集结构设计精巧,每一数据条目均包含数据来源标识、数学问题及其解与标准答案,同时详尽记录了对话式提示词、奖励模型所需的标准答案与风格标签,以及模型生成的多个候选响应。这种多维度的信息组织方式不仅支持传统的监督学习范式,更为偏好学习与奖励建模提供了丰富的结构化反馈。其显著特点在于将难度分层与温度参数系统化耦合,使得研究者能够针对不同推理复杂度与生成随机性的组合进行精细化实验。
使用方法
用户可通过HuggingFace Datasets库便捷加载此数据集,依据config参数指定所需的难度组合与温度分片,例如分别加载mixed.240与hard.240进行对比实验。数据集适用于离线强化学习场景,特别有利于DAPO等策略梯度算法的训练与评估,其中responses字段可直接作为策略模型的生成样本,reward_model字段则服务于奖励函数的构建与优化。此外,prompt字段中的多轮对话结构支持上下文增强的推理链建模,便于微调语言模型的数学推理能力。
背景与挑战
背景概述
该数据集名为pg-dapo_shuffled-0_offline-pg-dapo-qwen3-4B-Base-mbs128-n4_kl_behavior_matheval,由Qwen团队基于Qwen3-4B-Base模型构建,专注于数学评估(MathEval)领域。数据集创建于模型微调与强化学习背景下,旨在通过离线策略梯度方法(如DAPO)优化模型在数学问题上的推理能力。核心研究问题涉及如何利用带KL正则化的行为克隆与偏好学习,提升语言模型在复杂数学推理任务中的表现。该数据集包含了从易到难的多个难度层级(如mixed.20至hard.240),覆盖了1447个中等难度样本与100个高难度样本,为评估数学推理的泛化能力提供了结构化基准。其研究对推动强化学习在数学推理领域中的应用具有重要影响力。
当前挑战
该数据集所解决的领域问题包括:数学推理中模型对多步逻辑与精确计算的需求,尤其在处理长序列与高难度问题时易出现符号错误与逻辑断裂。构建过程中面临的关键挑战涉及:1) 数据质量与多样性,确保不同难度级别的样本具有区分度与代表性;2) 奖励模型的设计,需要准确区分错误与部分正确的中间步骤;3) 离线策略优化中的分布偏移问题,使得从固定数据集学习到的策略难以泛化到未见过的复杂数学问题上;4) 计算资源与训练稳定性的平衡,尤其在大规模模型微调时面临收敛困难的挑战。
常用场景
经典使用场景
在数学推理与强化学习的交叉领域中,pg-dapo_shuffled-0_offline-pg-dapo-qwen3-4B-Base-mbs128-n4_kl_behavior_matheval数据集为离线策略优化研究提供了结构化基准。其设计融合了多样化的数学问题(如mixed与hard难度分层)与完整的对话式提示(prompt)、标准答案(answer)及奖励模型信号(reward_model),尤其适合用于训练和评估基于离线策略梯度(offline PG)的强化学习算法。研究者可借助该数据集深入探究在固定行为策略下,如何通过KL正则化约束与行为克隆损失来稳定策略优化过程,从而提升模型在复杂数学证明和数值求解任务中的泛化能力。
解决学术问题
该数据集直面离线强化学习中分布偏移与过估计这一核心困境——当策略模型从静态收集的回应(responses)中学习时,极易因数据覆盖不足而产生偏差。通过提供由Qwen3-4B-Base模型生成的、带有多元难度层级(20至240分)的数学问题轨迹,并结合人工验证的ground_truth奖励与风格(style)标注,数据集为解决算法在稀疏奖励环境下的低效探索难题提供了实验平台。其影响在于推动了KL散度约束与行为正则化方法的实证对比,使学术界能够系统地评估离线策略梯度算法在逻辑推理任务上的鲁棒性,进而催生了更可靠的数学推理训练范式。
衍生相关工作
该数据集的出现催生了一系列聚焦于离线策略蒸馏与难度自适应的衍生研究。典型工作包括利用混合难度(mixed)与高难度(hard)子集进行课程学习,设计基于KL散度自调节的强化学习算法以提升模型在困难问题上的首次解答命中率;另有一些研究探索了如何结合reward_model中的style标注,将风格转换视为辅助任务,从而生成兼具严谨性与可读性的推导过程。此外,该数据集的结构也激发了多任务学习领域的实验,例如在同一模型上联合优化答案正确性奖励与行为克隆损失,催生了如行为正则化离线策略梯度(BR-OPG)等新型数学推理训练框架,为后续在代码生成、符号计算等领域的迁移应用奠定了基础。
以上内容由遇见数据集搜集并总结生成


