Turkish_STS_Emotional_Dataset
收藏资源简介:
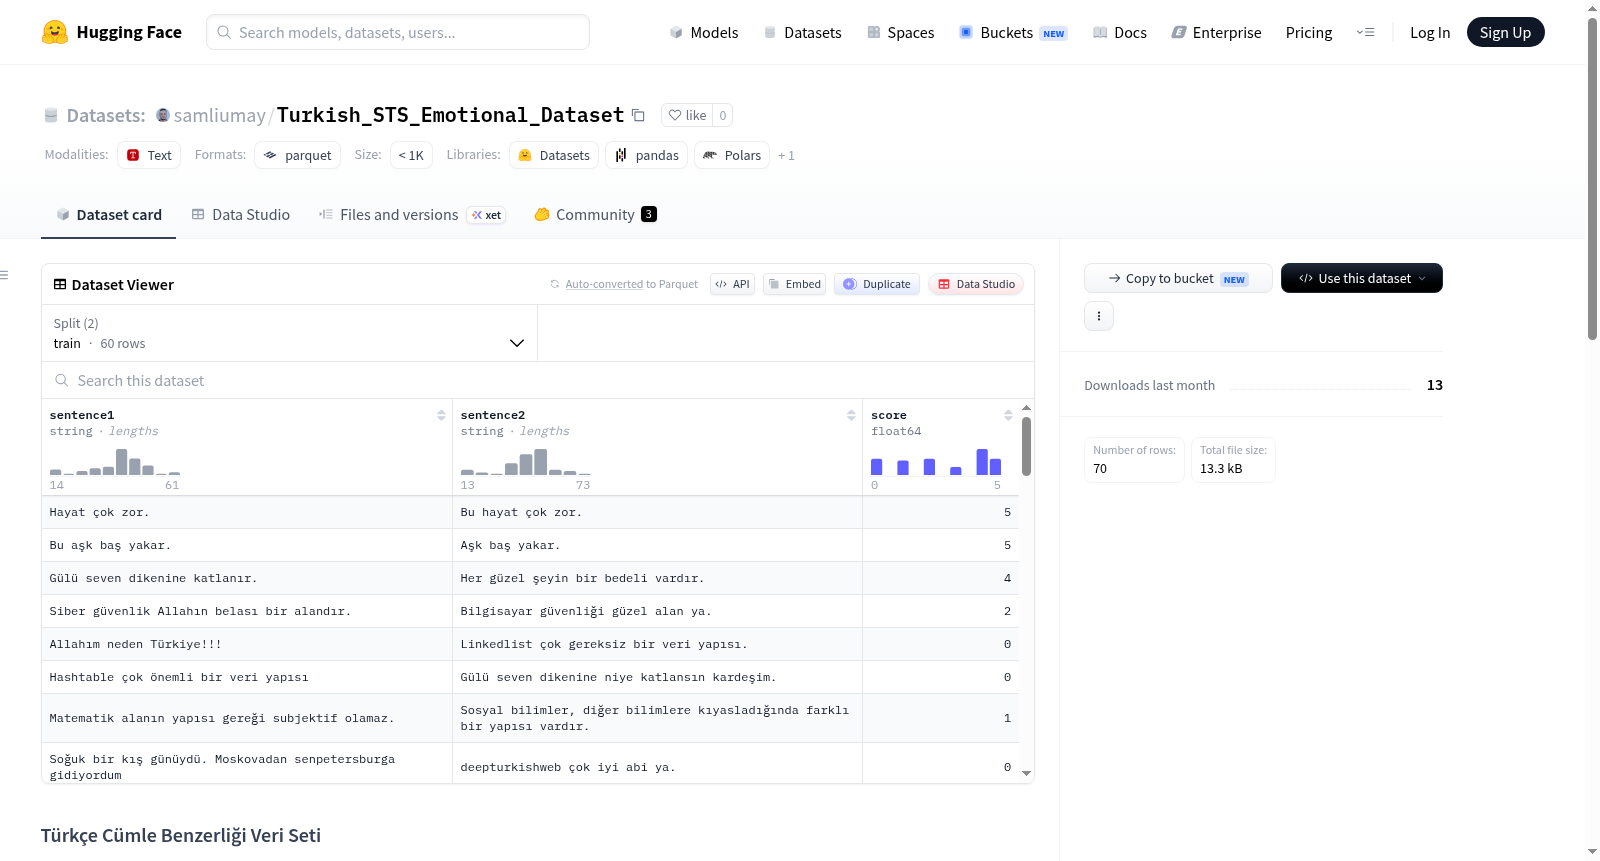
该数据集名为“Türkçe Cümle Benzerliği Veri Seti”,用于衡量两个土耳其语句子之间的语义相似度。其结构参考了 trmteb/stsb-tr 数据集。每个样本包含三个字段:sentence1(第一个句子,字符串)、sentence2(第二个句子,字符串)和 score(语义相似度得分,浮点数)。数据集共包含70个句子对,其中训练集60对,测试集10对。数据来源与标注:测试集的前5对和训练集的前20对为人工编写,其余部分由AI辅助生成。句子对的创建和数据集划分由Umay ŞAMLI完成,语义相似度评分由Şakir KOÇ进行人工标注,评分范围为0到5的整数(0:语义完全不同,1:非常低的相关性,2:部分共同元素但差异显著,3:整体意思相似但存在明显差异,4:语义高度相似,5:相同或几乎相同)。数据以Parquet格式存储,文件分别为 data/train.parquet 和 data/test.parquet。该数据集适用于土耳其语句子相似度计算、语义匹配、自然语言理解等任务。
The dataset is named Türkçe Cümle Benzerliği Veri Seti and is used to measure semantic similarity between two Turkish sentences. Its structure references the trmteb/stsb-tr dataset. Each sample contains three fields: sentence1 (first sentence, string), sentence2 (second sentence, string), and score (semantic similarity score, float). The dataset consists of 70 sentence pairs, with 60 in the training set and 10 in the test set. Data sources and annotation: The first 5 pairs of the test set and the first 20 pairs of the training set are manually written, while the rest are AI-assisted generated. The creation of sentence pairs and dataset splitting were done by Umay ŞAMLI, and semantic similarity scores were manually annotated by Şakir KOÇ, with scores ranging from 0 to 5 integers (0: semantically completely different, 1: very low relevance, 2: partially shared elements but significant differences, 3: overall meaning similar but with notable differences, 4: highly semantically similar, 5: identical or nearly identical). Data is stored in Parquet format, with files data/train.parquet and data/test.parquet. This dataset is suitable for tasks such as Turkish sentence similarity computation, semantic matching, and natural language understanding.
数据集概述
该数据集是一个用于土耳其语语义相似度测量的数据集,包含70个句子对及其相似度评分。
数据集结构
每条记录包含以下三个字段:
- sentence1 (
string):第一个句子 - sentence2 (
string):第二个句子 - score (
float64):语义相似度评分
数据划分
数据集共分为两个子集,总计70条记录:
| 子集 | 记录数 |
|---|---|
| train | 60 |
| test | 10 |
数据生成与评分
- 测试子集中的前5对句子以及训练子集中的前20对句子为人工制作,保留了原始文本未作修改;其余5对测试句子和40对训练句子由人工智能辅助生成。
- 所有70对句子均经人工评估,评分范围为0至5的整数,具体含义如下:
- 0:语义上完全不同的句子
- 1:存在非常低的语义关联
- 2:包含一些共同点,但意义有显著差异
- 3:整体语义相似,但存在明显差异
- 4:语义上相当相似
- 5:意义相同或几乎相同
文件格式
数据以Parquet格式存储,包含两个文件:
data/train.parquet:60对句子data/test.parquet:10对句子
贡献者
- Umay ŞAMLI:负责句子对的构建、训练/测试划分的生成以及数据集结构的设计。
- Şakir KOÇ:负责对70对句子进行基于0-5分制的人工语义相似度评分。