NADI2026_subtask1.1_Robust_ASR
收藏资源简介:
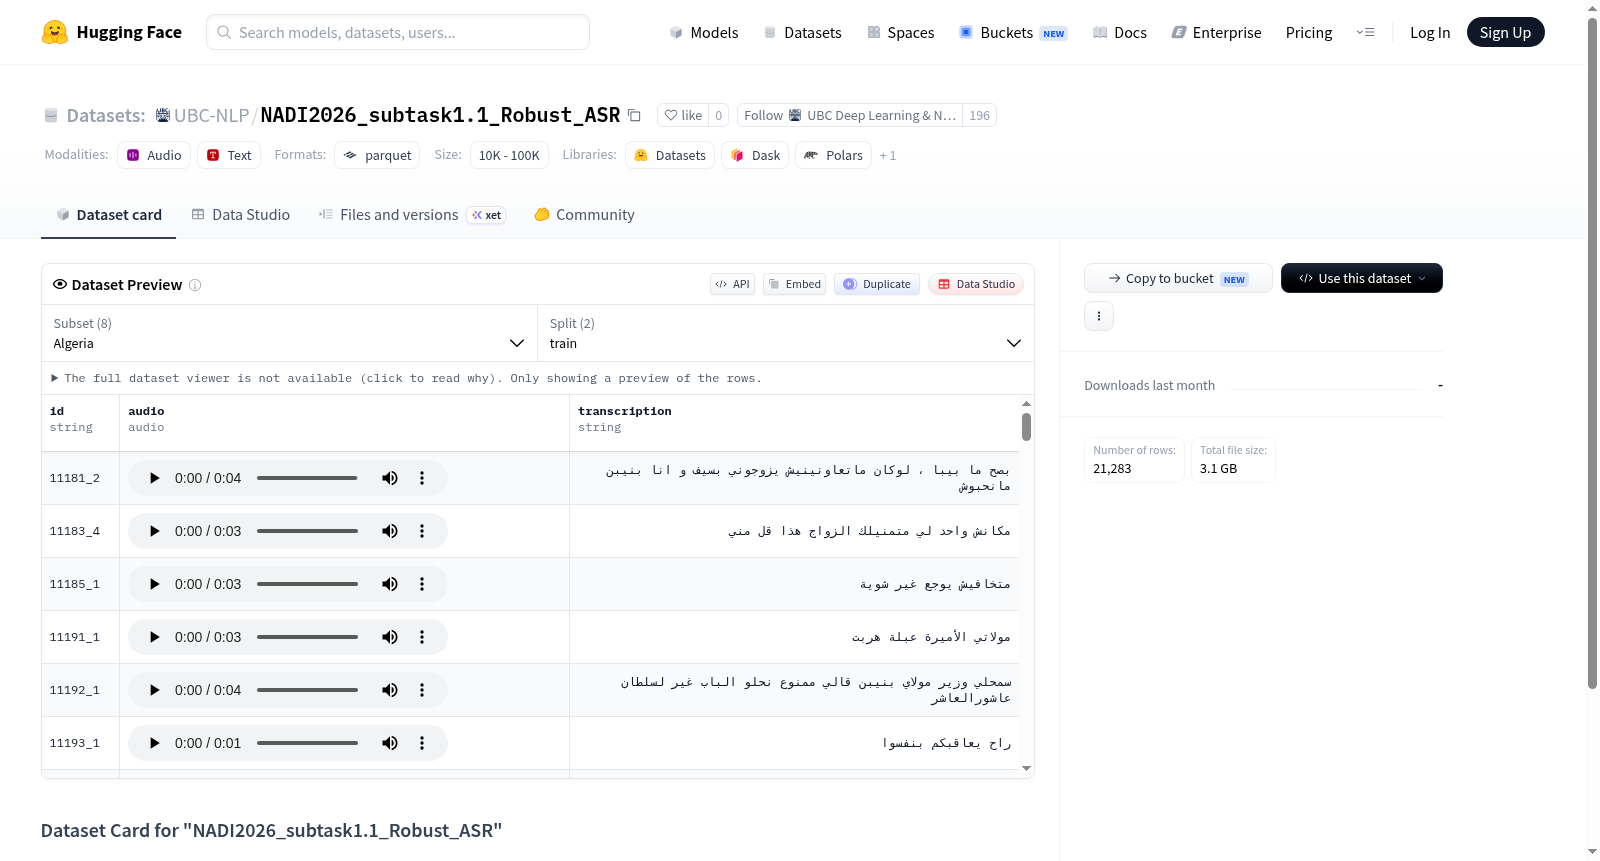
NADI2026_subtask1.1_Robust_ASR 是一个用于鲁棒自动语音识别(ASR)任务的阿拉伯语多方言语音数据集。该数据集包含八个阿拉伯语国家/地区的语音子集:阿尔及利亚、埃及、约旦、毛里塔尼亚、摩洛哥、巴勒斯坦、阿联酋和也门。每个子集均包含训练集和验证集,数据样本由音频文件及其对应的文本转录组成。音频采用16kHz采样率。数据规模因地区而异,例如,阿尔及利亚子集的训练集有1600个样本,验证集有727个样本;埃及子集的训练集和验证集各有1600个样本。该数据集旨在支持针对不同阿拉伯语方言的鲁棒语音识别模型的开发与评估。
NADI2026_subtask1.1_Robust_ASR is a robust automatic speech recognition (ASR) dataset for Arabic multi-dialect speech. It includes speech subsets from eight Arabic-speaking countries/regions: Algeria, Egypt, Jordan, Mauritania, Morocco, Palestine, the United Arab Emirates, and Yemen. Each subset contains training and validation sets, with data samples consisting of audio files and their corresponding text transcriptions. The audio is sampled at 16kHz. The data size varies by region; for example, the Algeria subset has 1600 samples in the training set and 727 in the validation set, while the Egypt subset has 1600 samples each in the training and validation sets. The dataset aims to support the development and evaluation of robust speech recognition models for different Arabic dialects.