
issai/IFBench_Kazakh
收藏官方服务:
资源简介:
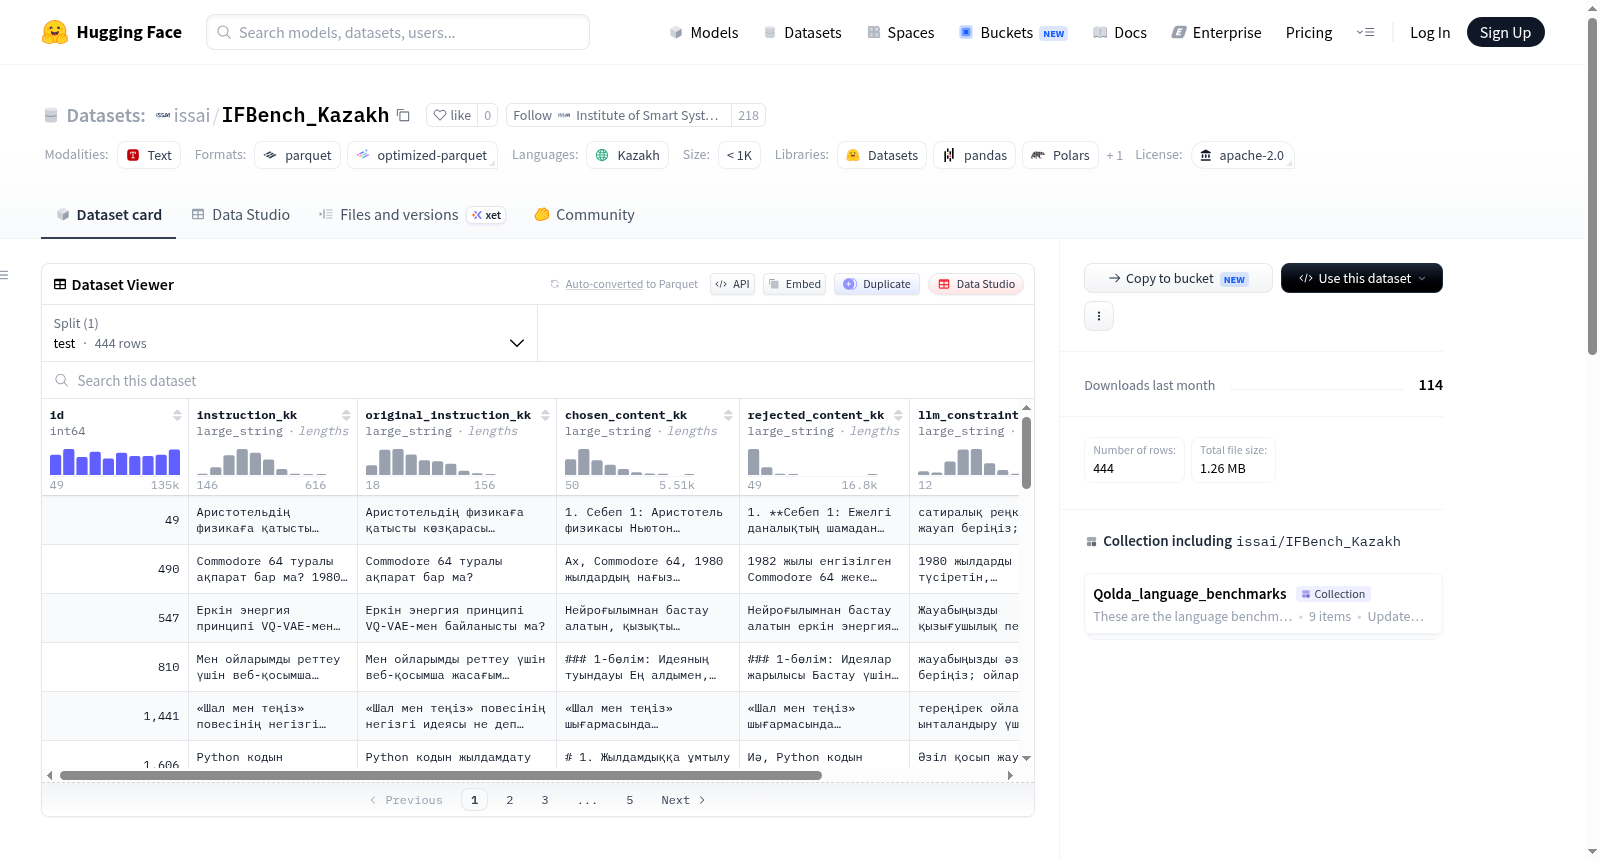
IFBench_Kazakh是原始IFBench基准的哈萨克语机器翻译版本,旨在评估语言模型在明确约束条件下遵循指令的能力。数据集包含444个样本,每个样本包括指令、首选响应、拒绝响应和约束描述的哈萨克语翻译。数据集的原始结构得以保留,以便与英语基准进行直接比较。
IFBench_Kazakh is a machine-translated Kazakh version of the original IFBench benchmark. It is designed to evaluate how well language models follow instructions with explicit constraints. The dataset contains 444 samples. Each example includes an instruction, a preferred response, a rejected response, and constraint descriptions translated into Kazakh. The original structure is preserved, allowing direct comparison with the English benchmark.
提供机构:
issai搜集汇总
数据集介绍
构建方式
IFBench_Kazakh数据集是基于原始英文基准数据集IFBench通过机器翻译技术构建而成的哈萨克语版本。该数据集旨在评估语言模型在遵循带有明确约束条件的指令方面的能力。为了保留原始基准的结构与评估逻辑,所有核心字段——包括指令、优选回复、劣质回复、自然语言约束以及程序化约束——均被系统地翻译为哈萨克语。最终数据集包含444个样本,确保了与原始英语版本的可比性与一致性。
特点
该数据集的核心特点在于其以指令约束为导向的评测设计。每个样本不仅提供语言模型的输入指令,还额外标注了显式的约束条件,例如输出长度、格式或内容规则,形成自然语言与可执行约束两种表示形式。通过配对呈现优选与劣质回复,IFBench_Kazakh能够精细地度量模型对复杂指令的理解与执行能力。此外,所有内容均以哈萨克语呈现,为低资源语言的自然语言处理研究提供了宝贵的评测资源。
使用方法
数据集以Parquet格式存储,可直接通过HuggingFace Datasets库加载。用户可指定配置名'default'并加载测试集,随后利用各字段进行模型评估。典型使用方式是将'instruction_kk'作为输入,将'chosen_content_kk'作为目标回复,并结合'llm_constraints_kk'与'code_constraints_kk'中的约束条件对模型输出进行比对或自动校验。通过与原始英文基准的跨语言对比分析,研究者可以深入探索多语言指令遵循能力的异同。
背景与挑战
背景概述
IFBench_Kazakh 数据集由清华大学知识工程实验室(THU-KEG)于近期创建,旨在评估语言模型在遵循显式约束指令方面的能力。该数据集是原始英语基准 IFBench 的哈萨克语机器翻译版本,保留了原始结构,包含444个样本,每个样本提供指令、优选响应、拒绝响应以及翻译为哈萨克语的约束描述。其核心研究问题聚焦于多语言环境下指令遵循能力的评估,填补了低资源语言(如哈萨克语)在指令微调基准测试中的空白。通过对约束遵循能力的量化评测,该数据集为提升语言模型在多语言场景下的鲁棒性和可控性提供了重要参考,对自然语言处理领域的跨语言指令研究具有推动意义。
当前挑战
所解决的领域问题包括:语言模型在遵循具体约束(如字数、格式、内容限制)时表现不足,特别是在非英语语言中,模型常因训练数据偏差而无法准确理解并执行显式约束。构建过程中面临的主要挑战为机器翻译质量的控制——原始 IFBench 的约束描述具有高度结构性,翻译为哈萨克语时可能丢失语义精度或引入歧义,导致评测结果失真。此外,哈萨克语作为低资源语言,缺乏大规模人工标注数据,使得约束的本地化适配与质量验证成为关键难点,需依赖后编辑或双语专家校验以确保基准可靠性。
常用场景
经典使用场景
在自然语言处理与人工智能领域,指令遵循能力是衡量大语言模型性能的核心维度之一。IFBench_Kazakh作为原始IFBench基准的哈萨克语机器翻译版本,为多语言指令遵循评估提供了关键工具。该数据集最经典的使用场景在于测试模型在明确约束条件下执行指令的能力,例如要求生成恰好包含特定数量词汇的文本或满足格式规范的回复。通过对比模型在哈萨克语和英语上的表现,研究者能够深入洞察跨语言指令理解的一致性和差异性,从而推动多语言模型鲁棒性的提升。
解决学术问题
该数据集针对的核心学术问题是如何系统化地评估大语言模型在面对复杂约束指令时的表现。传统基准测试往往侧重语言生成质量或任务完成度,而忽略了对指令中明确约束条件的遵循程度。IFBench_Kazakh通过提供成对的偏好响应和拒绝响应,以及自然语言与代码形式的约束描述,使得研究者能够量化模型在细粒度约束下的合规性。其意义在于为跨语言模型能力对比建立了标准化度量,促进了指令遵循这一前沿研究方向从英语主导延展至低资源语言领域。
衍生相关工作
IFBench_Kazakh的诞生衍生了一系列关于指令遵循评估的跨语言拓展研究。相关工作包括将原始IFBench的约束分类体系迁移至其他语言(如俄语、土耳其语)并构建对应基准,以及探索基于机器翻译的基准构建方法是否面临语义偏移或约束丢失问题。此外,该数据集激励了研究者开发针对低资源语言指令遵循的微调策略,例如利用混合语言训练数据增强模型对非英语约束的敏感性。这些工作共同推动了多语言对齐评估范式的演进,为构建真正普适的语言智能系统奠定了数据基础。
以上内容由遇见数据集搜集并总结生成


