
遇见数据集

CIRCL/vulnerability-attack-techniques-llm-ollama-qwen3.5-122b

收藏
Hugging Face2026-07-13 更新2026-07-22 收录
官方服务:

资源简介:

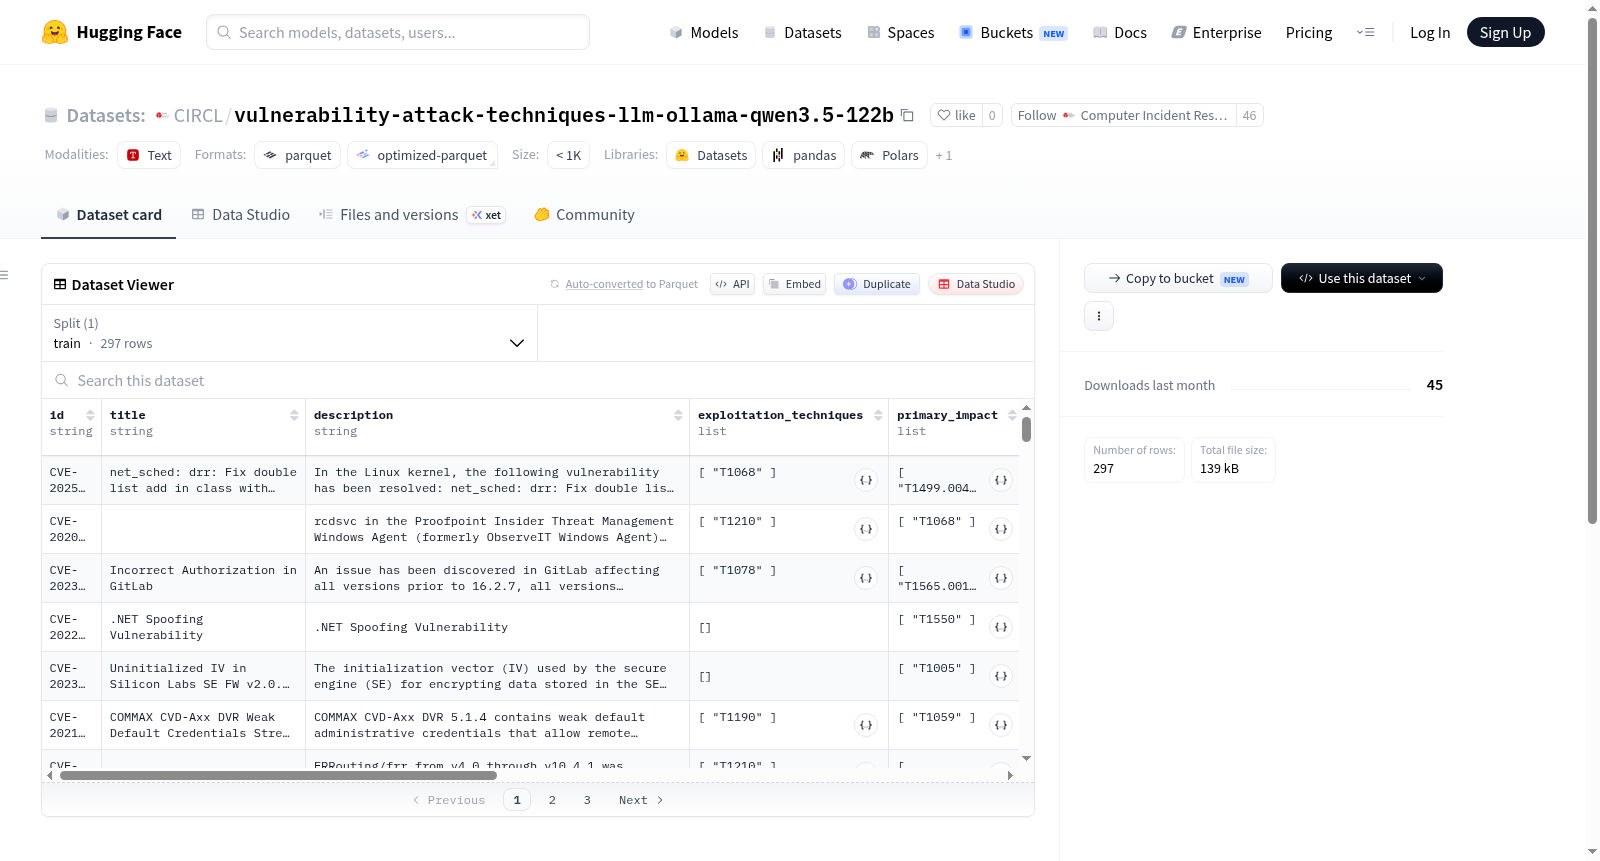
该数据集是一个通过大语言模型(ollama/qwen3.5:122b)自动生成的扩展数据集,用于增强漏洞攻击技术分析。它基于MITRE CTID的将ATT&CK映射到CVE以评估影响方法,扩展了人工标注的基准数据集(CIRCL/vulnerability-attack-techniques)。数据集包含297个CVE条目,使用MITRE ATT&CK框架版本19.1进行标注,每行的标签来源(label_sources)均为[llm],表示由大语言模型生成,并记录具体的模型信息。与人工标注数据集的验证结果显示,在121个CVE的测试集上,F1微平均分数为0.392。数据集设计用于与人工标注数据结合,以提升训练效果,通过保留label_sources字段可区分自动生成和人工标注数据。数据集特征包括漏洞ID、标题、描述、利用技术、主要影响、次要影响、技术、衍生技术、标签来源、ATT&CK版本、大语言模型模型和模型评论等。

This dataset is a machine-generated expansion labeled by the large language model (ollama/qwen3.5:122b), not analyst-curated. It follows the MITRE CTID Mapping ATT&CK to CVE for Impact methodology as an expansion of the curated gold dataset (CIRCL/vulnerability-attack-techniques). The dataset includes 297 CVEs, uses ATT&CK version 19.1, and every row has label_sources as [llm], with the llm_model column recording the exact model per row. Validation against the gold set shows an f1_micro score of 0.392 on the full 121-CVE gold test split. It is intended for training augmentation alongside the analyst-curated gold set, and the label_sources column is kept to allow recovery of gold-only data. Features include id, title, description, exploitation_techniques, primary_impact, secondary_impact, techniques, techniques_derived, label_sources, attack_version, llm_model, and llm_comment.
提供机构:
CIRCL
搜集汇总
数据集介绍
CIRCL/vulnerability-attack-techniques-llm-ollama-qwen3.5-122b 数据集图片
构建方式
该数据集在MITRE CTID“Mapping ATT&CK to CVE for Impact”方法论指导下,基于人工精选的金标准数据集CIRCL/vulnerability-attack-techniques进行扩展构建。利用本地部署的ollama/qwen3.5:122b大语言模型对297个CVE漏洞条目进行自动化标注,生成攻击技术标签。每条数据的label_sources字段均标记为“llm”,同时通过llm_model列记录所用模型版本。数据划分仅包含训练集,共297个样本,涵盖漏洞ID、标题、描述、利用技术、主要影响等结构化字段。
特点
该数据集的核心特征在于其LLM驱动的大规模自动化标注能力,将原本依赖安全分析师人工梳理的ATT&CK技术映射流程转化为机器生成范式。尽管与金标准测试集的F1_micro一致性为0.392,但其显著优势在于能够以极低成本快速扩充标注样本量,弥补人工标注数据稀缺的不足。特别设计的label_sources字段支持后续与金标准数据集混合使用,确保可灵活恢复纯人工标注子集,兼顾训练增强与标注来源追溯的精确性。
使用方法
推荐将本数据集作为数据增强手段,与CIRCL/vulnerability-attack-techniques金标准数据集联合使用。训练时可根据label_sources字段筛选纯LLM标注样本或混合样本,通过调整两类数据比例优化模型性能。数据以默认配置加载,训练集包含297条完整记录,每条包含id、title、description等基础字段及多项攻击技术标签。建议在安全威胁建模、漏洞分类等任务中,利用该数据集的规模化特点提升模型对稀有ATT&CK技术的识别能力。
背景与挑战
背景概述
该数据集名为vulnerability-attack-techniques-llm-ollama-qwen3.5-122b,由CIRCL团队于2025年创建,旨在扩展基于MITRE CTID方法论的ATT&CK到CVE的映射体系。核心研究问题在于利用大语言模型自动化标注漏洞攻击技术,以弥补人工标注的不足。该数据集包含297个CVE实例,使用ollama/qwen3.5:122b模型生成标签,并基于CIRCL/vulnerability-attack-techniques黄金数据集进行扩展,在漏洞分析领域推动了机器学习与安全情报的融合,为自动化威胁建模提供了重要数据支撑。
当前挑战
当前数据集面临的核心挑战包括:1)领域问题方面,自动化漏洞攻击技术映射的准确性不足,与黄金数据集对比的F1分数仅为0.392,表明模型在精准分类上仍存在显著偏差;2)构建过程中,全量依赖大语言模型标注导致标签可靠性存疑,缺乏人工审核机制,且数据仅覆盖单一模型输出,可迁移性受限。此外,数据集规模较小,仅297条记录,无法充分覆盖多样化攻击场景,可能影响下游训练模型的泛化能力。
常用场景
经典使用场景
在网络安全与人工智能的交叉领域,该数据集为研究大型语言模型在漏洞威胁分析中的自动标注能力提供了宝贵资源。其经典使用场景聚焦于将ATT&CK攻击框架与CVE漏洞条目进行自动化映射,通过机器生成的标签扩充已有的分析师标注数据集。研究者可借助此数据集训练和评估模型在漏洞攻击技术分类、影响评估等任务上的性能,尤其适用于探讨LLM辅助威胁情报生成的可行性与局限性。
实际应用
在实际应用中,该数据集可助力安全运营团队快速构建自动化威胁分析流水线。安全分析师可将其作为训练语料,开发能够从CVE描述中自动提取攻击技术、评估潜在破坏性的智能工具,从而加速漏洞优先级排序与应急响应。同时,数据集内置的label_sources字段允许灵活组合机器标签与专家标签,便于在人力资源有限的组织中实现威胁标注的渐进式自动化。
衍生相关工作
该数据集衍生出一系列探索LLM辅助安全知识库构建的研究工作。其基础方法论——MITRE CTID映射CVE至ATT&CK的流程——启发后续团队开发了基于提示工程优化的自动标注器,并催生了对比不同LLM(如GPT-4、Llama系列)在漏洞标注任务上表现的实证研究。此外,验证协议中采用的微平均F1评估框架已成为评估此类映射任务的标准度量,推动形成更严谨的自动化威胁情报质量评价体系。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

