
elsaEU/ELSA_D3
收藏官方服务:
资源简介:
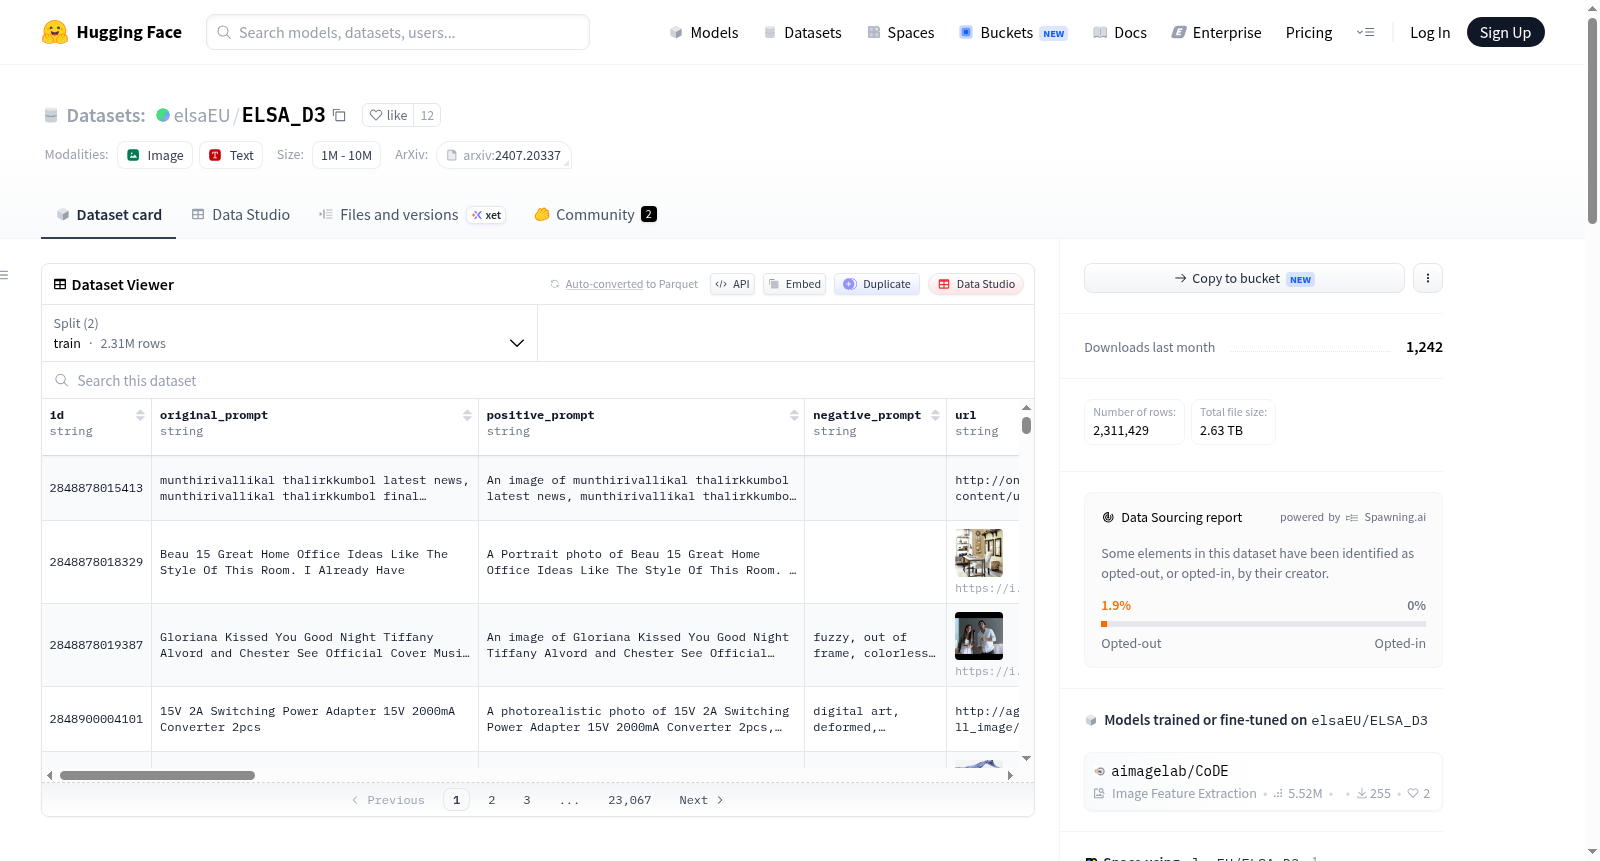
ELSA多媒体数据集是一个大规模的深度伪造图像集合,使用扩散模型生成。该数据集是欧盟ELSA项目的一部分,旨在开发和测试检测和缓解深度伪造图像传播的有效解决方案。深度伪造图像具有高度真实性和欺骗性,对隐私、安全和数字媒体的信任构成重大风险。该数据集可用于训练强大且准确的模型,以识别和标记深度伪造图像的实例。数据集包含多个版本,每个版本使用不同的扩散模型生成图像,并包含丰富的元数据信息。
ELSA多媒体数据集是一个大规模的深度伪造图像集合,使用扩散模型生成。该数据集是欧盟ELSA项目的一部分,旨在开发和测试检测和缓解深度伪造图像传播的有效解决方案。深度伪造图像具有高度真实性和欺骗性,对隐私、安全和数字媒体的信任构成重大风险。该数据集可用于训练强大且准确的模型,以识别和标记深度伪造图像的实例。数据集包含多个版本,每个版本使用不同的扩散模型生成图像,并包含丰富的元数据信息。
提供机构:
elsaEU原始信息汇总
数据集概述
数据集结构
配置
- 默认配置:
- 训练集:路径包括
data/train-*和data/val-* - 验证集:路径为
data/validation-*
- 训练集:路径包括
特征
- id:字符串类型
- original_prompt:字符串类型
- positive_prompt:字符串类型
- negative_prompt:字符串类型
- url:字符串类型
- model_gen0:字符串类型
- model_gen1:字符串类型
- model_gen2:字符串类型
- model_gen3:字符串类型
- width_gen0:int64类型
- width_gen1:int64类型
- width_gen2:int64类型
- width_gen3:int64类型
- height_gen0:int64类型
- height_gen1:int64类型
- height_gen2:int64类型
- height_gen3:int64类型
- num_inference_steps_gen0:int64类型
- num_inference_steps_gen1:int64类型
- num_inference_steps_gen2:int64类型
- num_inference_steps_gen3:int64类型
- filepath_gen0:字符串类型
- filepath_gen1:字符串类型
- filepath_gen2:字符串类型
- filepath_gen3:字符串类型
- image_gen0:图像类型
- image_gen1:图像类型
- image_gen2:图像类型
- image_gen3:图像类型
数据集分割
- 训练集:
- 字节数:2626848010531.5
- 样本数:2306629
- 验证集:
- 字节数:5318900038.0
- 样本数:4800
数据集大小
- 下载大小:2568003790242
- 数据集大小:2632166910569.5
搜集汇总
数据集介绍
构建方式
ELSA_D3数据集作为ELSA项目中多媒体用例的核心组成部分,旨在应对深度伪造图像对数字媒体信任体系构成的严峻挑战。该数据集基于LAION数据集中的海量图文对,针对每一条原始文本描述(original_prompt),利用四种不同的扩散模型(model_gen0至model_gen3)分别生成对应图像,从而构建出多样化的伪造样本。每条样本均保留了原始提示、正向与负向提示词、图像尺寸、推理步数等关键生成参数,并关联了真实图像的URL,形成了结构严谨、信息完备的对比数据对。数据集以Parquet格式存储,每个文件包含近千张图像及其元数据JSON,训练集包含约230万条样本,验证集包含4800条样本。
特点
该数据集的核心特点在于其规模宏大与多维度的伪造图像覆盖。总计超过230万条训练样本,每一条原始文本均对应由四种不同扩散模型生成的图像,极大地丰富了伪造手法的多样性。数据集不仅包含了图像本身,还详细记录了生成过程中的全部参数,如模型名称、推理步数、图像宽高比等,为深度伪造检测研究提供了可追溯、可复现的实验基础。此外,数据集中保留了真实图像URL,使得研究者能够在真实与伪造图像之间进行直接对比,从而更精准地训练和评估检测模型的泛化能力与鲁棒性。
使用方法
使用者可通过HuggingFace Datasets库便捷地加载该数据集,推荐采用流式读取模式(streaming=True)以降低本地存储压力,实现高效的迭代训练。加载后,每条数据包含一个唯一ID、原始与正负提示词、四种模型生成的图像及其元数据。研究者可根据任务需求,灵活选择特定生成模型的图像子集,或利用完整的四组生成图像进行多模型联合分析。该数据集特别适用于训练深度伪造图像检测模型、研究不同扩散模型生成痕迹的差异性,以及评估检测算法在多种生成策略下的表现,为多媒体内容安全领域提供坚实的数据支撑。
背景与挑战
背景概述
在数字媒体迅猛发展的当下,扩散模型等生成式人工智能技术已能创造出以假乱真的深度伪造图像,对隐私安全、社会信任乃至政治稳定构成了严峻威胁。为应对这一挑战,欧盟ELSA项目于近期构建了名为ELSA_D3的多媒体专用数据集,由UNIMORE(摩德纳大学图像实验室)主导研发。该数据集聚焦于深度伪造图像的检测与缓解这一核心研究问题,旨在为学界与工业界提供大规模、多样化的训练资源。其影响力体现在,通过收录超过230万张由四种不同扩散模型生成的图像,并涵盖多种压缩格式与宽高比,为开发鲁棒且准确的伪造检测模型奠定了坚实基础,推动了数字取证领域的边界拓展。
当前挑战
该数据集所解决的领域问题核心在于深度伪造图像的精准识别,这要求模型不仅能区分真实与伪造,还需应对生成技术迭代带来的新变体,如不同扩散模型架构、推理步数与压缩伪影造成的视觉差异。构建过程中,ELSA_D3面临多重挑战:首先,需从海量LAION数据中筛选并配对原始提示词,确保生成图像与真实图像在语义上对齐;其次,协调四种不同生成模型(如Stable Diffusion变体)的输出,统一存储格式与元数据结构,涉及超过2.5TB数据的处理与流式加载优化;最后,平衡训练集与验证集的规模(230万对4800样本),在保证数据多样性的同时避免过拟合风险,对数据划分策略提出了严苛要求。
常用场景
经典使用场景
在多媒体取证与数字媒体安全领域,ELSA_D3数据集被广泛用于训练和评估面向扩散模型生成图像的深度伪造检测系统。该数据集包含超过230万张由四种不同扩散模型生成的图像,并提供了原始提示词、正负向引导文本、推理步数等元数据,为研究多源生成图像的共性伪造痕迹提供了标准化的训练与验证基准。研究者通常利用其大规模多模型生成样本,构建能够泛化至未知生成模型的鲁棒检测器,从而推动深度伪造检测技术从单一模型识别向跨模型泛化能力演进。
实际应用
在实际应用中,ELSA_D3数据集支撑着社交媒体平台、新闻机构与司法鉴定部门部署自动化深度伪造筛查系统。基于该数据集训练的检测模型能够高效识别由扩散模型生成的虚假人像、场景与产品图片,有效遏制利用AI生成内容进行的虚假信息传播、身份冒用与版权欺诈行为。例如,内容审核平台可将其部署为前置过滤模块,在用户上传阶段实时标记疑似伪造图像,大幅降低人工审核成本,同时提升对新兴扩散模型生成内容的响应速度与识别准确率。
衍生相关工作
围绕ELSA_D3数据集,学术界衍生出多项经典工作:包括基于频域特征的多生成模型指纹提取方法、利用扩散模型逆过程噪声残差进行溯源检测的框架,以及结合对比学习与数据增强的跨域泛化检测架构。此外,该数据集催生了面向生成图像属性解耦的可解释性研究,例如通过分析推理步数与生成图像伪影分布的关联,揭示了不同扩散模型的内在生成机制差异。这些衍生工作不仅深化了对扩散模型生成过程的理解,也为后续构建更具可解释性与鲁棒性的检测系统奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成


