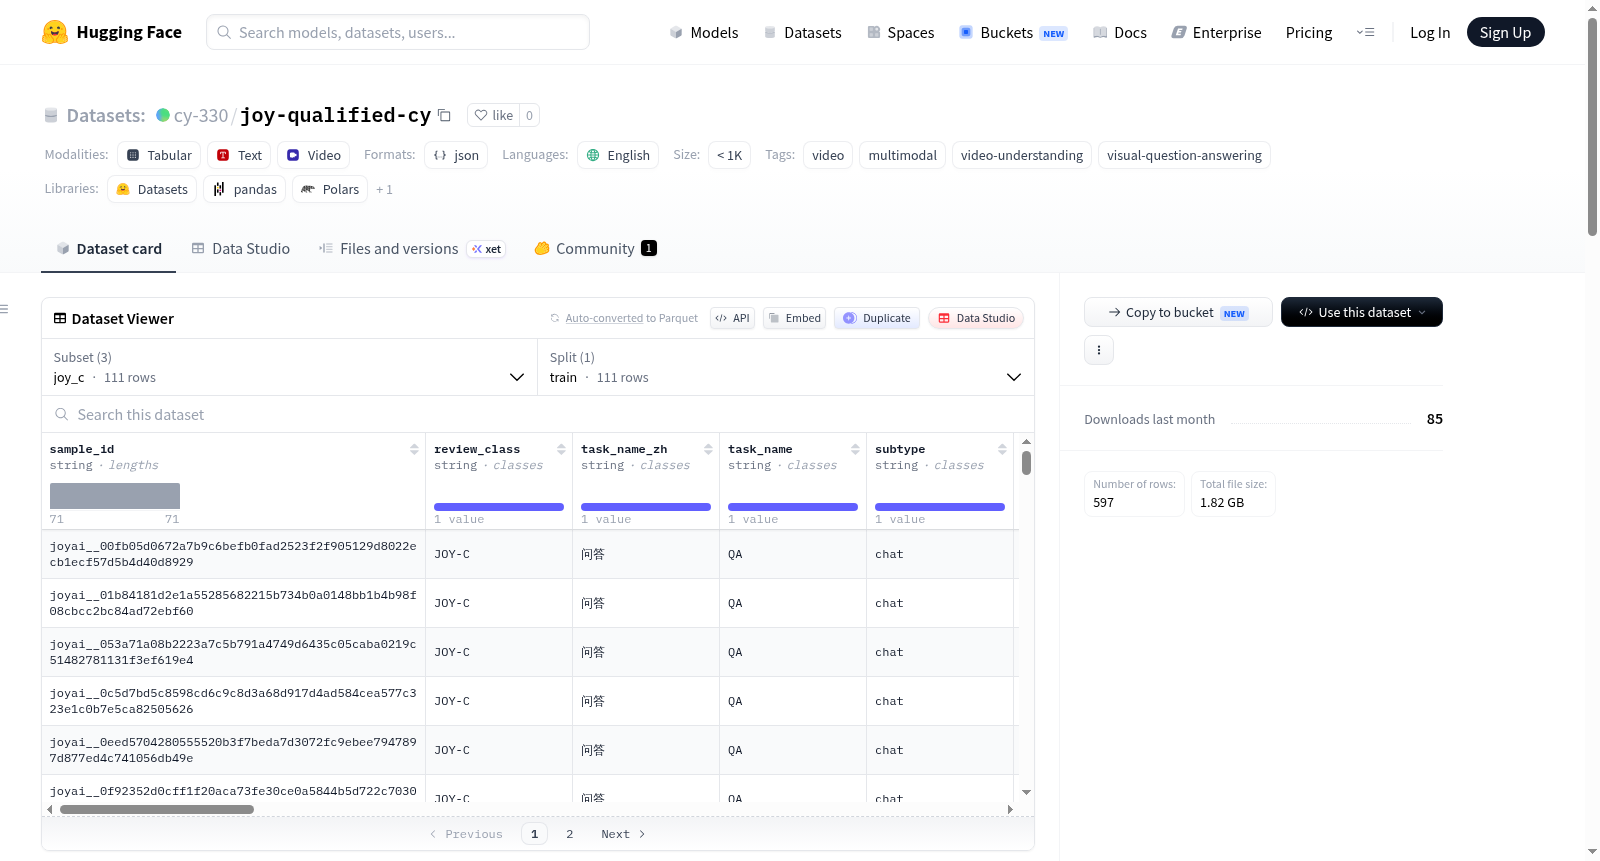
joy-qualified-cy
收藏资源简介:
该数据集是 JOY 审查平台中审查者 `cy` 标记为“合格”的样本快照,生成于 2026-09-04T20:16:02+00:00。数据集包含 597 个样本(共计 1.69 GiB 的 MP4 视频),涵盖三个任务类别:JOY-C(问答,QA,111 个样本)、JOY-E(事件定位,Grounding,382 个样本)和 JOY-N(叙述,Narration,104 个样本)。数据以 JSONL 格式存储元数据,并配有对应视频文件。所有自然语言文本均为英文,其中 `question_text` 和 `help_points[].content` 字段由原始中文翻译而来,保留了原对话式语域(如长指令、体育评论风格),用于测试指令提取、触发时机、弃权行为和输出格式遵从性。字段 `task_name_zh` 保留原始中文标签(“问答”、“定位”、“解说”),`task_name` 为英文标签。数据集包含对原始注释的少量修正:修复了六条被截断的 JOY-E 问题,移除了一条 JOY-N 样本(问题与注释不匹配),并处理了一条 JOY-N 中的中英拼接片段。数据集中的“合格”状态为审查者特定平台状态,不保证注释完全无误,可能包含模型辅助审查决策。用户需自行检查原始视频来源的许可条款,数据集不施加新的统一许可。
This dataset is a snapshot of samples labeled as qualified by reviewer cy in the JOY review platform, generated on 2026-09-04T20:16:02+00:00. It contains 597 samples (totaling 1.69 GiB of MP4 videos) across three task categories: JOY-C (Question Answering, QA, 111 samples), JOY-E (Event Grounding, 382 samples), and JOY-N (Narration, 104 samples). Data is stored in JSONL format for metadata, accompanied by corresponding video files. All natural language text is in English, with the `question_text` and `help_points[].content` fields translated from original Chinese, retaining the original conversational register (e.g., long instructions, sports commentary style), designed to test instruction extraction, trigger timing, abstention behavior, and output format compliance. The field `task_name_zh` retains the original Chinese labels ("问答", "定位", "解说"), and `task_name` contains English labels. The dataset includes minor corrections to original annotations: fixing six truncated JOY-E questions, removing one JOY-N sample (question-annotation mismatch), and handling one JOY-N instance with mixed Chinese-English segments. The qualified status is platform-specific for the reviewer and does not guarantee annotation correctness; it may involve model-assisted review decisions. Users should check the license terms of original video sources; the dataset imposes no new unified license.
数据集概述
该数据集为 JOY 审查平台上标注为 qualified(合格)样本的快照,由审查员 cy 筛选,导出时间为 2026-09-04T20:16:02+00:00,共包含 597 个样本,对应 1.69 GiB 的 MP4 视频。
数据集配置与任务类型
数据集包含三个子配置,分别对应不同的视频理解任务:
| 配置名 | 任务类型 | task_name |
样本数 |
|---|---|---|---|
joy_c |
视频问答 | QA |
111 |
joy_e |
事件定位 | Grounding |
382 |
joy_n |
视频解说 | Narration |
104 |
文件结构与内容
- 元数据文件:
data/joy_c.jsonl、data/joy_e.jsonl、data/joy_n.jsonl,每行包含用户问题、问题时间、所有标注帮助点及其最佳时间、来源元数据、相对视频路径、字节大小、SHA-256 哈希及平台审查快照信息。 - 视频目录:
videos/JOY-C/、videos/JOY-E/、videos/JOY-N/,存放对应的 MP4 文件。 - 清单文件:
MANIFEST.json,记录数量、大小、哈希、来源和导出时间戳。
语言与文本处理
- 所有自然语言文本均为 英文,其中
question_text和help_points[].content字段已由中文翻译为英文。 - 翻译过程保留了原文的对话语气(如
joy_e中的长指令与口语化表达、joy_n中的体育赛事解说风格),以保持对指令提取、触发时机、弃权行为和输出格式遵循度的测试意图。 task_name_zh保留原始中文标签(问答/定位/解说),task_name为英文标签(QA/Grounding/Narration)。- 其他字段(如
help_points[].index和help_points[].best_time)与原始导出逐字节一致。
数据修正说明
与原始导出相比,数据进行了以下三项修正:
- 删除了 6 个
joy_e问题 中未完整的尾部指令(在句子边界处截断),其余约束和帮助点保持不变。 - 移除了 1 个
joy_n样本,因其问题与对应的帮助点所描述的视频内容不一致(问题关于“跑步或传球序列”,而帮助点标注的是女子足球广播开场),因此joy_n实际样本数为 104。 - 修正了一个
joy_n帮助点中英文片段混入中文的情况,该问题在翻译过程中自动解决。
审查与局限性
- “qualified” 是平台特定审查状态,不代表所有注释均无错误,数据可能包含模型辅助审查的决策。
- 不包含被拒绝、未审查、人工复审或错误记录。
许可证
- 数据集未设置统一的整体许可证,每个样本保留其来源平台的
license字段值。用户在再分发或商业使用前,需自行核查原始来源条款。