
遇见数据集

medarc/gtex-10M-balanced-tiles

收藏
Hugging Face2026-06-25 更新2026-07-22 收录
官方服务:

资源简介:

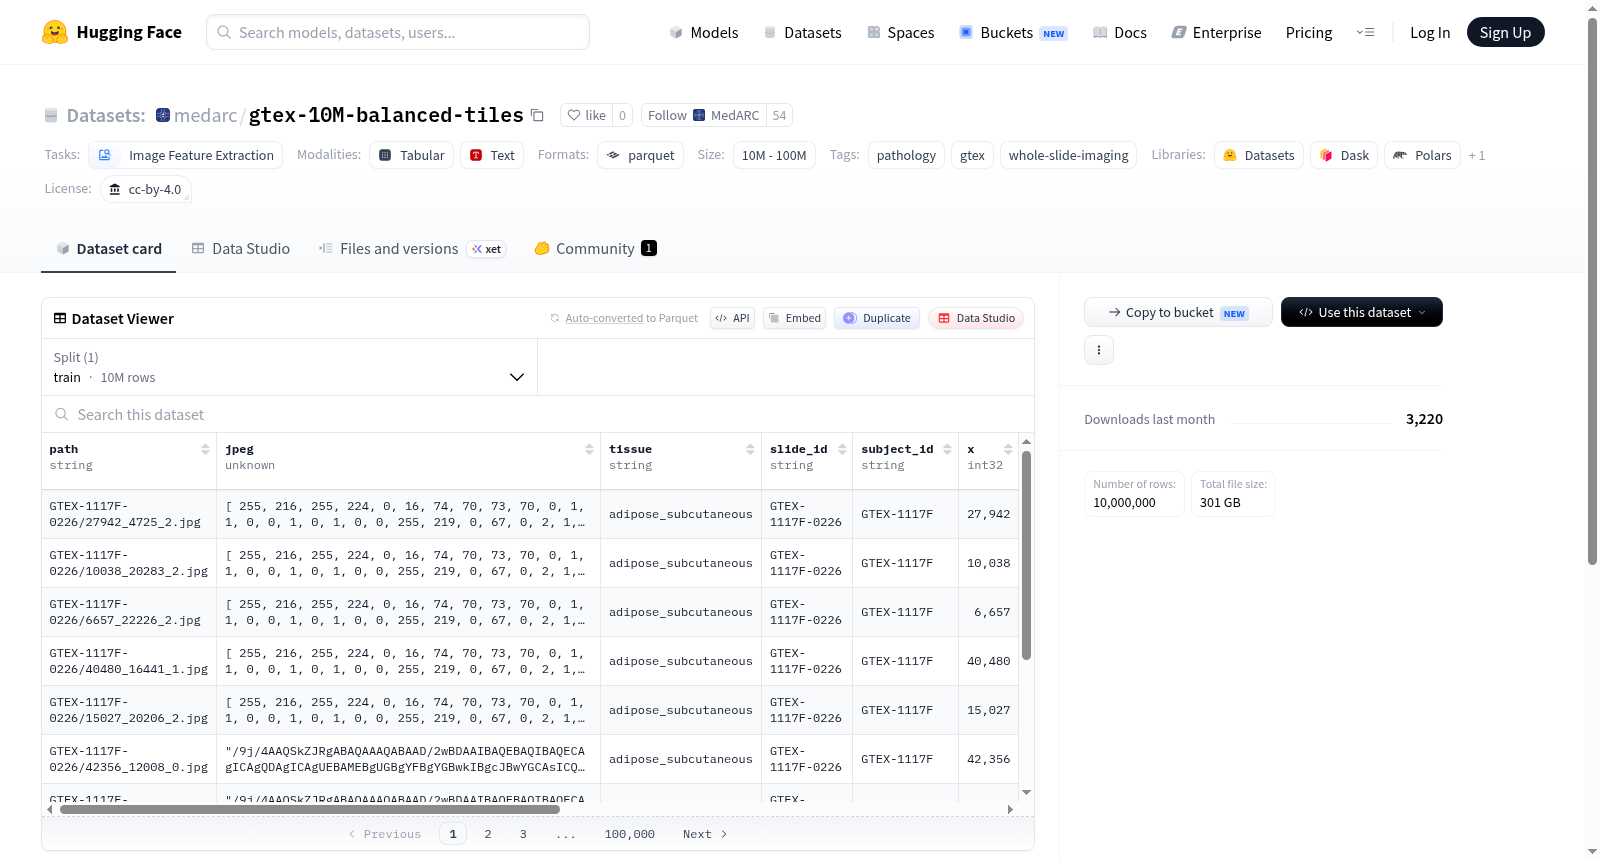
该数据集包含1000万个JPEG编码的224x224病理切片,来自GTEx SVS幻灯片,平衡分布在40个组织前缀上,每个前缀250,000个切片。源对象小于80,000,000字节的已被忽略,因为GTEx前缀包含不支持的小型SVS对象。切片从虚拟OpenSlide级别0、1和2中采样,因此有效视野变化,而输出的JPEG大小保持固定。每个parquet行包含与nanopath风格切片加载兼容的path和jpeg列,以及tissue、slide_id、subject_id、x、y、level、source_px、downsample、s3_uri和tissue_fraction元数据。

This dataset contains 10,000,000 JPEG-encoded 224x224 pathology tiles from GTEx SVS slides in `s3://path-datasets/gtex/svs_by_tissue`, balanced at 250,000 tiles for each of the 40 tissue prefixes. Source objects under 80,000,000 bytes are ignored because the GTEx prefix contains tiny unsupported SVS objects. Tiles are sampled from virtual OpenSlide levels 0, 1, and 2, so the effective field of view varies while the emitted JPEG size stays fixed. Each parquet row has `path` and `jpeg` columns compatible with nanopath-style tile loading, plus `tissue`, `slide_id`, `subject_id`, `x`, `y`, `level`, `source_px`, `downsample`, `s3_uri`, and `tissue_fraction` metadata.
提供机构:
medarc
搜集汇总
数据集介绍
medarc/gtex-10M-balanced-tiles 数据集图片
构建方式
该数据集源自GTEx项目的全切片图像(SVS格式),存储于Amazon S3的指定存储桶中。构建过程首先剔除了大小低于80,000,000字节的源对象,以避免其中包含的不支持小型SVS文件。随后,针对每种组织类型(共40种),各均匀采样250,000个224×224像素的图像块,最终形成包含一千万个图块的数据集。图块分别取自OpenSlide虚拟金字塔层级0、1和2,从而在保持JPEG编码尺寸固定的前提下,有效覆盖多样化的视野范围。
特点
数据集的显著特点在于其高度平衡的组织类型分布,每个组织前缀恰好包含25万个图块,消除了类别不均衡问题。此外,丰富的元数据字段如组织类型、切片与受试者标识、坐标位置、采样层级、源像素尺寸、下采样因子、S3统一资源标识符以及组织占比,为病理图像分析提供了细致的背景信息。所有数据均采用兼容nanopath库加载方式的Parquet格式存储,便于高效读取与集成。
使用方法
使用者可通过Parquet文件直接加载数据,每条记录包含路径与JPEG编码的二进制列,便于在Python环境中利用nanopath或类似工具进行图块的解码与处理。建议按组织类型字段进行分组或过滤,以适用于特定组织病理学任务的模型训练或特征提取。由于数据集已预提取并平衡,可直接用于基于深度学习的图像特征学习任务,无需额外采样步骤,显著降低了预处理复杂度。
背景与挑战
背景概述
GTEx 10M Balanced Tiles数据集由研究人员于2023年左右创建,旨在推动计算病理学中基于整张切片图像的特征提取研究。该数据集源自Genotype-Tissue Expression(GTEx)项目,由多个学术机构合作构建,核心研究问题在于如何从大规模、多样化的组织病理切片中获取平衡且具有代表性的图像块,以支持跨组织类型的病理模型训练。通过提供1000万张来自40种不同组织前缀的224x224像素病理图块,每类组织严格平衡至25万张,该数据集显著提升了病理图像分析的多样性与公平性,为后续的组织分类、疾病标志物发现及多模态融合研究奠定了重要基础,在精准医学与计算病理学领域具有广泛影响力。
当前挑战
该数据集所解决的领域挑战主要在于病理图像类别分布不均衡问题,在真实临床数据中,不同组织类型的样本数量往往差异悬殊,导致模型偏向高频类别而忽视罕见组织,而该数据集通过精确的每类250,000张图块的平衡采样,有效缓解了这一偏差。构建过程中面临的挑战包括:处理GTEx数据源中大量尺寸小于80,000,000字节的不完整SVS对象,这些微小文件无法支持标准化切片分析,需在采样前进行剔除;多层级采样的复杂性要求从虚拟OpenSlide的0、1、2三个层级均匀抽取图块,同时保持输出JPEG尺寸固定,使得有效视野随层级变化而变化,增加了采样算法的设计难度。
常用场景
经典使用场景
在计算病理学领域,大规模、高质量的组织病理图像数据集对于训练深度学习模型至关重要。GTEx-10M-Balanced-Tiles数据集提供了来自40种不同组织的1000万张标准化病理图块,每类组织精确均衡地包含25万张图块,为多组织病理图像分析提供了理想的数据基础。该数据集广泛应用于组织病理学中的图像特征提取任务,尤其适合训练具有泛化能力的自监督学习模型,如对比学习框架中的特征编码器。研究者可利用这些来自不同组织、不同放大倍率(虚拟OpenSlide层级0至2)的图块,进行多分辨率特征学习,从而捕获组织微观形态的丰富表征,为下游分析奠定坚实基础。
实际应用
在实际医疗场景中,该数据集对于辅助病理诊断系统的开发具有重要价值。基于其均衡多组织图块训练的模型,可广泛应用于数字病理学工作流中的组织分型、肿瘤区域检测以及疾病严重程度评估等任务。例如,临床病理学家可利用训练得到的特征提取器,快速从全切片图像中标记出可疑病变区域,大幅减少手动阅片的工作量。该数据集生成的图块还兼容nanopath等标准病理数据处理框架,便于集成至现有临床信息系统。此外,其在药物研发领域的应用亦不可忽视——通过分析病理图块中的组织微环境特征,可加速药物疗效评估和生物标志物的发现过程,推动精准医疗的实践落地。
衍生相关工作
基于GTEx-10M-Balanced-Tiles数据集,学术界已衍生出多项具有影响力的研究工作。其中最突出的方向是利用该数据集作为预训练数据源,构建面向病理图像的通用基础模型(如REMEDIS和CONCH等架构)。这些模型在大规模图块上进行自监督预训练后,通过微调即可在下游任务——例如乳腺癌淋巴结转移检测、前列腺癌Gleason分级及肺腺癌亚型分类——中取得最先进的性能表现。此外,该数据集还催生了图级别与切片级别的多实例学习(MIL)方法创新,促进了将局部的图块级特征聚合为全局切片级诊断结果的技术演进。这些衍生工作不仅验证了数据集的高质量和广泛适用性,也持续推动着计算病理学领域向更智能、更自动化的方向迈进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

