
遇见数据集

VmaxRL/bugpilot-bugintro-lm-modify-gpt55-repaired-34-cleaned-1k-strict-20260526T212012Z

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

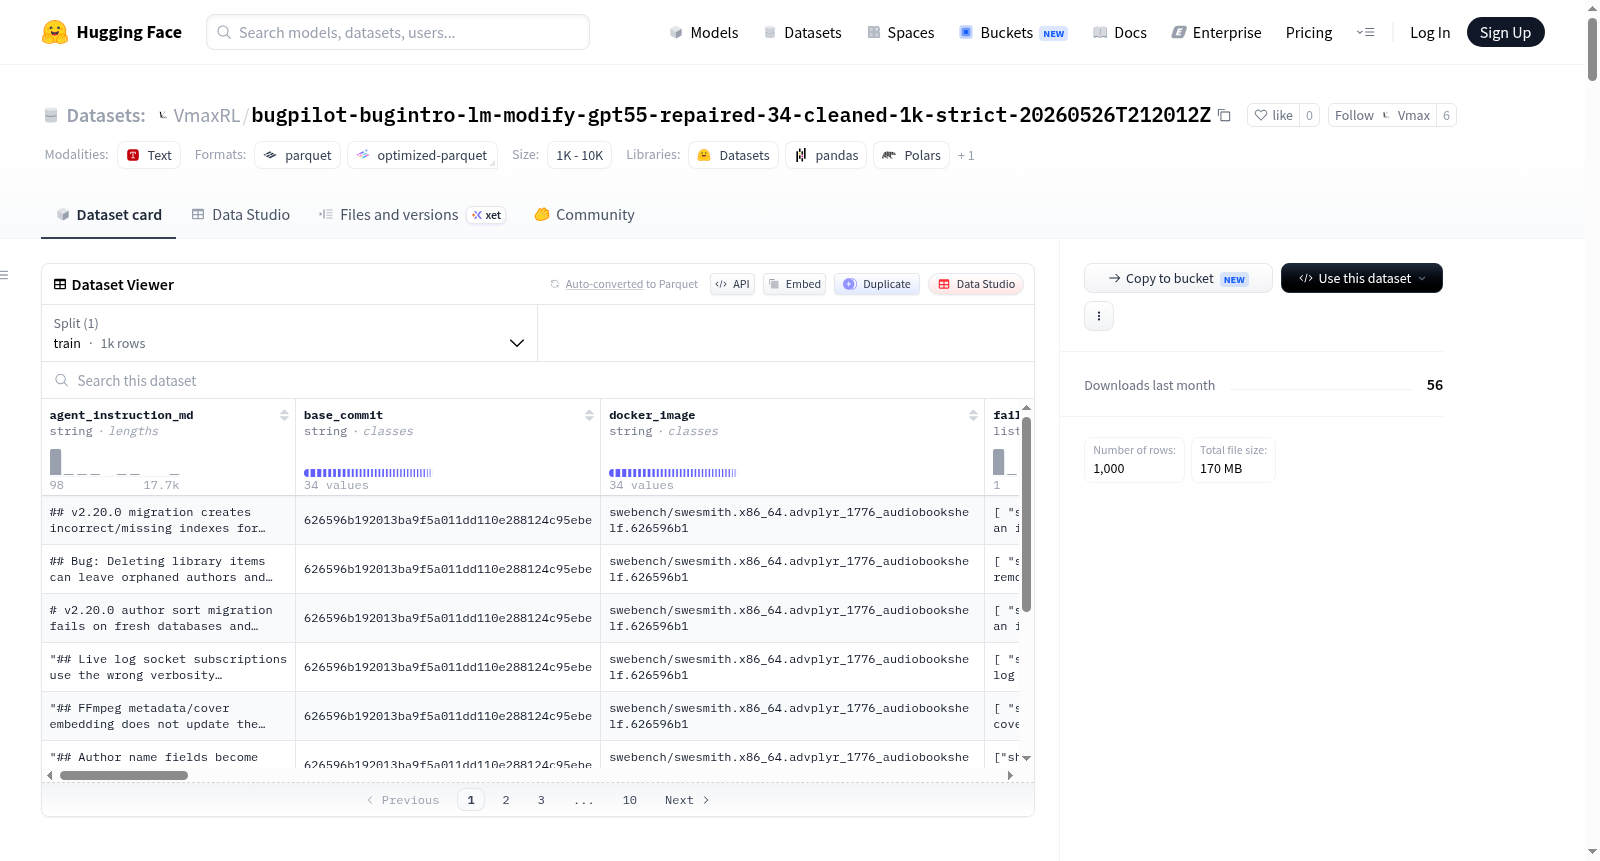
该数据集是一个用于软件工程语言模型修改任务的严格数据集,包含1000个样本,涵盖Go、JavaScript、Python和TypeScript四种编程语言。数据来源于34个开源仓库,涉及全栈Web产品、基础设施系统集成、富客户端UI、后端服务平台等多种软件类别。数据集通过SWE-smith工具和Azure GPT-5.5-1模型生成,并经过验证、清理、组装和去重处理,确保数据质量和唯一性。数据集特征包括代理指令、基础提交、Docker镜像、测试列表(失败到通过和通过到通过)、框架、生成器ID、黄金补丁、介绍补丁、问题陈述、仓库信息、需求、设置命令、测试命令、元数据(如测试计数、数据集ID、源仓库等)等,适用于软件缺陷修复和代码修改的机器学习训练与评估。

This dataset is a strict dataset for software engineering language model modification tasks, containing 1000 samples across four programming languages: Go, JavaScript, Python, and TypeScript. The data originates from 34 open-source repositories, covering various software categories such as full-stack web products, infrastructure systems integration, rich client UI, and backend service platforms. The dataset is generated using the SWE-smith tool and the Azure GPT-5.5-1 model, and undergoes validation, cleaning, assembly, and deduplication to ensure data quality and uniqueness. Features include agent instructions, base commit, Docker image, test lists (fail-to-pass and pass-to-pass), framework, generator ID, gold patch, introduction patch, problem statement, repository information, requirements, setup command, test command, metadata (e.g., test counts, dataset ID, source repository, etc.), and is suitable for machine learning training and evaluation in software bug fixing and code modification.
提供机构:
VmaxRL
搜集汇总
数据集介绍
VmaxRL/bugpilot-bugintro-lm-modify-gpt55-repaired-34-cleaned-1k-strict-20260526T212012Z 数据集图片
构建方式
该数据集通过精心设计的流水线构建而成,依托SWE-smith框架中的lm_modify方法,以Azure托管的GPT-5.5模型为生成引擎,从34个经过严格筛选的开源仓库中提取代码实体作为候选,以单候选单缺陷的生成策略迭代产出程序修复样本。生成过程中采用多轮渐进式补集策略,依据目标清单与可靠测试宇宙的交集精确分配每仓库的行数配额,并通过Docker容器化运行时进行自动验证和清理,最终利用SHA-256哈希对补丁进行严格去重,确保每个数据实例的补丁唯一且完整。
特点
本数据集以高度结构化、纯净可靠为核心理念,总计包含1000个训练样本,横跨Go、JavaScript、Python与TypeScript四大主流编程语言,覆盖全栈Web应用、后台服务平台、富客户端界面及基础设施集成等典型软件类别。每条记录不仅包含缺陷描述、引入补丁、验证测试集等核心要素,还嵌入详尽的元数据字段,如测试命令、Docker镜像、清理统计与来源追溯标识,从而为软件工程中的自动化缺陷修复研究提供兼具规模与细粒度的训练资源。
使用方法
研究者可直接从HuggingFace平台加载该数据集,采用`train`分割及其预定义的字段如`agent_instruction_md`、`problem_statement_md`、`gold_patch`与`fail_to_pass`列表,用于训练或评测基于语言模型的程序修复系统。使用时需注意依赖环境包括Python 3.13及以上、Docker容器运行时以及可靠的测试宇宙数据集,通过提供的`base_commit`和`docker_image`确保实验的可重现性,并参照`swebench_pro_pre_test_cmd`等字段规范执行自动化验证流程。
背景与挑战
背景概述
该数据集由VmaxRL团队于2026年5月创建,核心研究问题聚焦于利用大语言模型(LLM)自动生成软件缺陷修复任务,以评估和提升代码智能体的修复能力。数据集基于SWE-Turing框架,通过GPT-5.5模型对34个开源仓库进行靶向代码修改,生成1000条高质量的缺陷引入与修复样本。其设计严格遵循可靠测试宇宙的验证标准,并采用多层清洗与去重流程,确保了数据的高可靠性和可复现性。该数据集在软件工程与人工智能交叉领域具有重要影响力,为自动化程序修复、代码理解及智能代理的评估提供了标准化基准,推动了从静态代码分析向动态、可执行的缺陷修复任务的转变。
当前挑战
该数据集旨在解决自动化程序修复中的两大挑战。其一,领域核心挑战在于如何生成具有真实语义且可验证的缺陷,使修复任务能准确反映实际开发中的复杂逻辑,避免简单语法错误或过度简化。数据集通过LM Modify方法在源代码中引入精确的语义偏离,并依赖多轮严格验证确保缺陷的可修复性。其二,构建过程中面临样本多样性与规模平衡的挑战,需在34个不同语言与领域的仓库中精准分配1000条任务,同时通过同语言、同类别的替代策略弥补生成短板的缺口,最终经过八轮迭代、去重与严格规则过滤,在保证数据纯净度的前提下实现零冗余的完美装配。
常用场景
经典使用场景
在软件工程与程序修复研究领域,该数据集主要用于训练和评估基于大语言模型的自动化程序修复与缺陷引入智能体系统。其经典使用方式是将每个样本作为独立的软件缺陷修复任务,其中包含问题描述、基准提交、错误引入变更、黄金补丁以及验证测试用例。研究者可利用该数据集构建端到端的修补流水线,引导语言模型根据问题陈述与代码上下文生成候选补丁,并通过提供的测试用例验证修补的正确性,从而衡量模型在真实仓库上的缺陷定位与修复能力。
解决学术问题
该数据集直接回应了自动程序修复领域中高质量、跨语言、细粒度缺陷样本匮乏的学术困境。通过构建涵盖Go、JavaScript、Python、TypeScript四类语言的34个活跃开源仓库的1000个严格验证样本,它有效解决了现有基准集规模有限、补丁冲突、测试不充分等问题。其严格去重与可靠测试宇宙筛选机制确保了样本的独立性和可复现性,为公平比较不同修复方法、评估补丁合成模型的泛化能力以及研究缺陷引入模式与代码结构之间的因果关系提供了可靠的实验基石。
衍生相关工作
该数据集的构建衍生了一系列关于补丁去重、可靠测试宇宙构建以及跨仓库缺陷迁移学习的经典工作。其严格装配流程催生了基于SHA-256的补丁指纹去重技术,为后续大规模缺陷数据集的清洁整理树立了范本。同时,通过同语言、同类别的替代样本填充策略,推动了跨仓库缺陷模式对齐与迁移修复研究,激发了诸如细粒度缺陷定位、错误引入变更分析与语言模型适应性调优等方向的发展,成为自动化程序修复领域迭代演进的重要数据驱动力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

