OfficeComprehensionBenchmark
收藏资源简介:
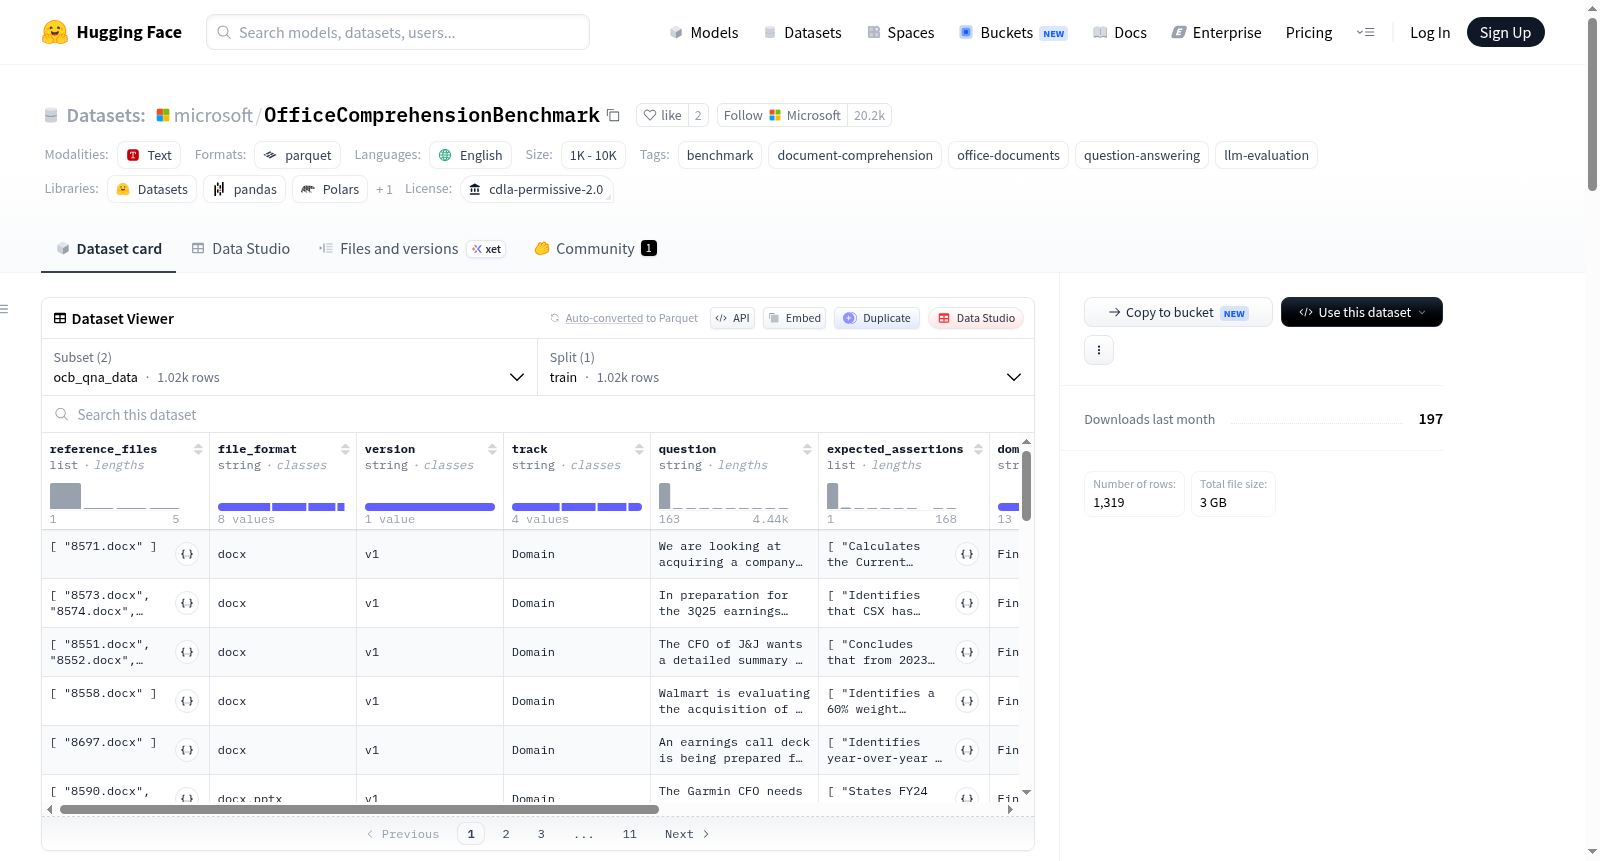
OfficeComprehensionBenchmark (OCB) 是一个用于评估对Microsoft Office文件(Word、Excel、PowerPoint)的文档理解和基于文档的推理能力的基准测试数据集。它包含两个主要轨道:1) 文件保真度问答(File Fidelity Q&A),用于衡量对文档结构元素(如文本、表格、图表、公式、格式、嵌入对象)的感知能力;2) 领域问答(Domain Q&A),用于衡量对12个不同行业真实商业文档的专家级推理能力。数据规模方面,文件保真度轨道包含244个文件和922个查询,领域问答轨道包含124个文件和120个查询,共计8,450个原子断言。数据集采用混合分发模型:部分参考文件(其源许可允许在CDLA-Permissive-2.0下重新分发)直接托管在Hugging Face上,同时包含所有问题、参考答案和断言评分标准;另一部分参考文件(其源许可不允许重新分发)通过URL清单引用,用户需通过配套工具从原始公开来源获取。由于许可兼容性问题,三个源自Kaggle的Excel文件未包含在公开版本中。该数据集仅用于评估目的(如基准测试、模型比较、消融研究),不适用于训练。主要许可协议为CDLA-Permissive-2.0,不同来源的子组件可能遵循其他许可(如美国政府作品/公共领域、CC0 1.0、MIT等)。
OfficeComprehensionBenchmark (OCB) is a benchmark for evaluating document understanding and document-based reasoning capabilities for Microsoft Office files (Word, Excel, PowerPoint). It includes two main tracks: 1) File Fidelity Q&A, which measures perception of document structural elements (text, tables, charts, formulas, formatting, embedded objects); 2) Domain Q&A, which measures expert-level reasoning on real-world business documents from 12 different industries. In terms of data scale, the File Fidelity track contains 244 files and 922 queries, while the Domain Q&A track contains 124 files and 120 queries, totaling 8,450 atomic assertions. The dataset uses a hybrid distribution model: some reference files (whose source licenses permit redistribution under CDLA-Permissive-2.0) are hosted directly on Hugging Face, along with all questions, reference answers, and assertion scoring criteria; other reference files (whose source licenses do not permit redistribution) are referenced via URL manifests, requiring users to fetch them from original public sources using accompanying tools. Due to license compatibility issues, three Excel files sourced from Kaggle are not included in the public version. The dataset is intended only for evaluation purposes (e.g., benchmarking, model comparison, ablation studies) and not for training. The primary license is CDLA-Permissive-2.0, with subcomponents from different sources potentially following other licenses (e.g., U.S. Government Works/Public Domain, CC0 1.0, MIT, etc.).
OfficeComprehensionBenchmark (OCB) 数据集概述
- 数据集名称: OfficeComprehensionBenchmark (OCB)
- 发布机构: Microsoft
- 许可证: CDLA-Permissive-2.0(社区数据许可协议 - 许可版 2.0)
- 语言: 英语
- 数据集大小: 1,000 < 样本数 < 10,000
- 数据集类型: 基准测试
- 标签: 基准测试、文档理解、Office文档、问答、大语言模型评估
数据集规模:
- 文件保真度问答轨道: 244 个文件,922 个查询
- 领域问答轨道: 124 个文件,120 个查询,8,450 个原子断言,覆盖 12 个行业
数据集构成
该数据集包含两个主要配置:
- ocb_qna_data:包含问答数据(训练集),文件格式为 Parquet。
- ocb_source_urls:包含源文件 URL 清单(训练集),文件格式为 Parquet。
数据集内容与结构
OCB 是一个用于评估对 Microsoft Office 文件(Word、Excel、PowerPoint)进行文档理解和基于事实推理能力的基准测试,包含两个评估轨道:
- 文件保真度问答轨道:衡量对文档构件(文本、表格、图表、公式、格式、嵌入对象)的结构和视觉感知能力。
- 领域问答轨道:衡量对 12 个行业真实商业文档的专业级推理能力。
数据分布模式
采用混合分发模式:
- 直接托管于 Hugging Face:许可证允许在 CDLA-Permissive-2.0 下重新分发的参考文件,以及所有问题、参考答案和断言评分规则。
- 通过 URL 清单引用:许可证不允许重新分发的参考文件,清单随数据集提供,用户需通过配套 GitHub 仓库从原始公共来源下载并转换(如从 PDF 转换为 .docx, .xlsx, .pptx 等 Office 原生格式)。
许可信息
- OCB 原创内容(问题、参考答案、原子断言、专家撰写的参考文件):CDLA-Permissive-2.0。
- 来自美国政府开放数据门户的托管参考文件:美国政府作品/公共领域,或允许重新分发的开放数据条款。
- 来自 Kaggle 的托管参考文件:仅重新分发 CC0 1.0 或 MIT 许可的文件,属性与通知义务保留在 NOTICES.md 文件中。
- URL 引用的文件:保留其原始许可证,OCB 不对这些文件主张许可。
预期用途
- 已验证的用例:评估模型在结构化与半结构化 Office 文件上的基于事实的问答准确性;比较模型在跨格式推理(如 Word + Excel 输入)上的表现;评估文档结构与视觉感知的保真度;进行基于检索与基于 Office 文档的管道消融研究。
- 不推荐用途:用作训练数据;对 .docx / .xlsx / .pptx 及其变体以外的文件格式进行评估;仅基于 OCB 得分在监管领域(医疗、法律、金融建议)做出高风险部署决策。
补充信息
- 配套代码仓库:GitHub 上的 microsoft/OfficeComprehensionBench 仓库提供评估提示、裁判脚本、文件下载工具和 PDF 转 Office 格式脚本。
- 2023年5月7日更新:由于许可不兼容,三个原本包含于评估集的 Excel 文件及其关联的文件保真度查询已从本次公开发布中移除。用户如需复现完整评估,可从 Kaggle 直接获取这些源数据。
维护与引用
- 维护方:Microsoft
- 维护承诺:发布后至少维护 3 年。问题、修正及勘误请求通过数据集仓库的讨论页面跟踪。
- 引用格式:参见
citation部分。