
gRa1ne/decorrelated-chess
收藏官方服务:
资源简介:
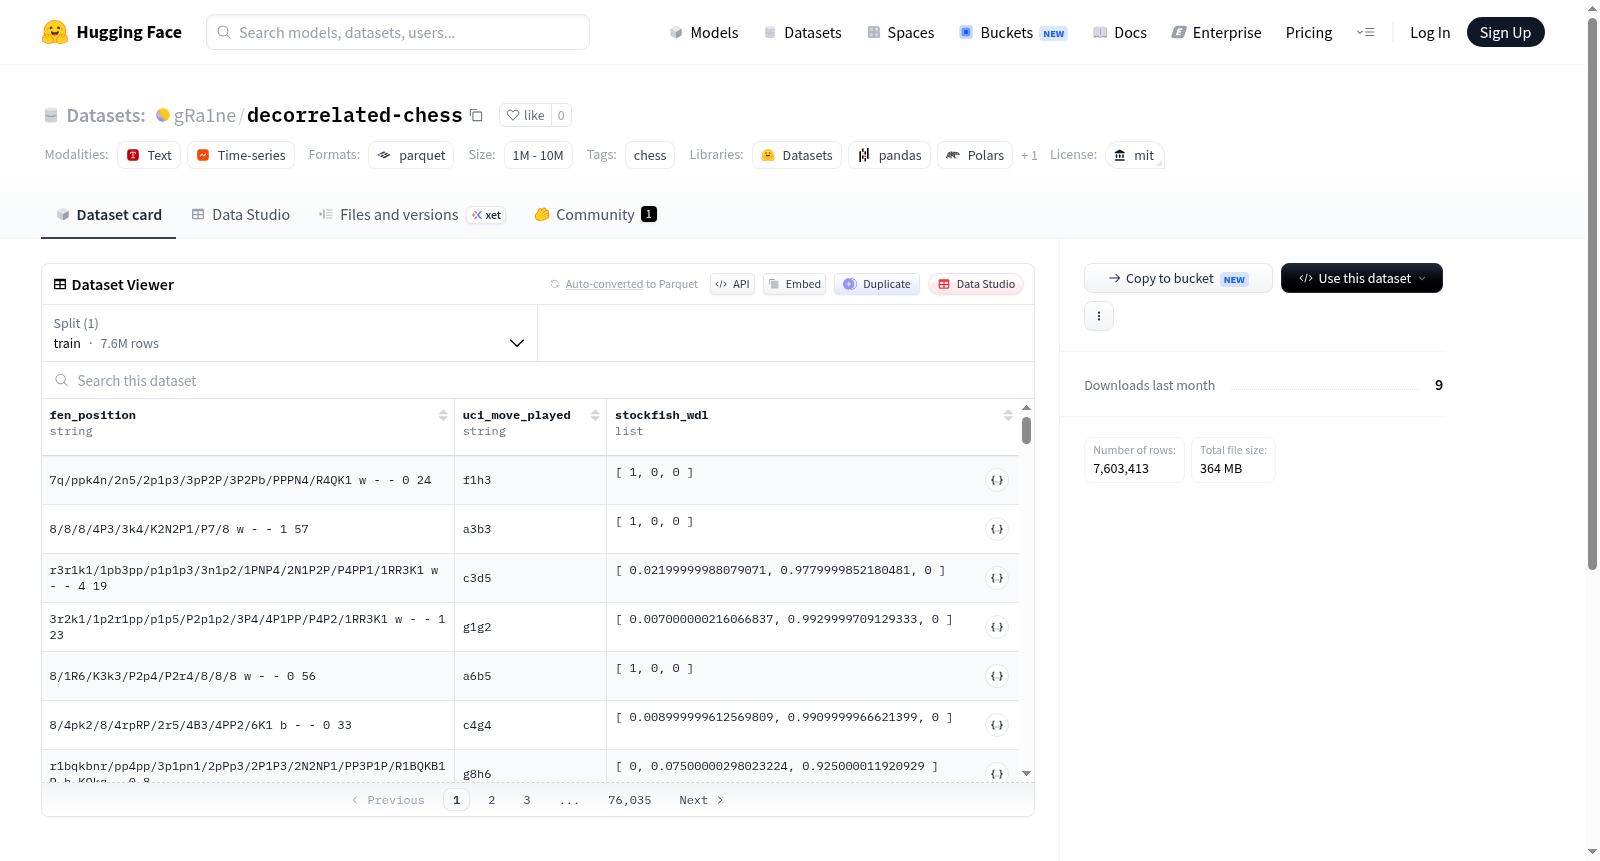
这是一个最小化策略和价值网络国际象棋数据集,旨在为小型/中型国际象棋模型的深度学习策略/价值网络训练提供空间高效的数据集。数据集来源于lichess精英数据库,通过从每场游戏中随机抽取3个样本(排除前6步和最后一步)构建,以确保位置不相关。每行数据包含FEN位置、玩家所走棋步的UCI格式标签,以及白方视角的WDL分类(0表示赢,1表示平,2表示输)。
This is a Minimal Policy + Value Net Chess Dataset, intended as a space-efficient dataset for simple deep learning policy/value network training of small/medium size chess models. It is derived from the lichess elite database, and consists of uncorrelated chess positions built by taking 3 random samples from each game, excluding the first 6 and last move. Each row contains the fen position, a move label in uci format that was taken by the player, and the white point of view wdl classification (0=win, 1=draw, 2=loss).
提供机构:
gRa1ne搜集汇总
数据集介绍
构建方式
该数据集源自Lichess精英数据库,专为小型至中等规模国际象棋模型的简易深度学习和策略/价值网络训练而设计。为确保位置之间的独立性,构建过程中对每盘棋局进行了去相关处理,具体而言,从每局棋中随机抽取三个局面样本,并排除开局前六步及最后一步,从而有效避免相邻局面带来的数据冗余。每个数据条目包含基于FEN格式的棋盘局面、对弈者实际落子以UCI格式记录的走法标识,以及基于白方视角的胜负平分类标签(0代表胜利,1代表和棋,2代表失败)。
特点
本数据集的核心特点在于其空间高效性与位置去相关性。通过从每局棋中仅随机抽取三个样本,极大压缩了数据规模,同时保留了关键游戏状态与决策信息。标签体系简洁明了,仅包含胜负平三类结果,便于直接用于价值网络与策略网络的联合训练。此外,排除棋局开头与结尾的走法,确保了训练样本聚焦于中盘复杂局面,增强了模型对典型博弈场景的泛化能力。
使用方法
该数据集适用于深度学习框架中的监督学习任务。使用时,可直接将FEN字符串作为模型输入特征,通过标准编码方式(如基于棋盘字符的嵌入或位置编码)转化为张量。UCI格式的走法标签可用于训练策略网络,通过多分类交叉熵损失优化走法预测;而WDL分类标签则用于价值网络训练,采用交叉熵或均方误差损失估计局面评估。推荐将数据按比例划分为训练集与验证集,以监控模型过拟合情况,并利用小批量梯度下降进行高效迭代。
背景与挑战
背景概述
在人工智能与棋类博弈的交叉领域,棋盘游戏的策略学习一直是强化学习与监督学习的重要试验田。国际象棋作为最具代表性的完全信息博弈之一,其状态空间的复杂性与策略多样性为深度神经网络提供了极具挑战性的训练场景。decorated-chess数据集由依托Lichess精英数据库构建而成,旨在为中小规模象棋模型的策略与价值网络训练提供一种空间高效的解决方案。该数据集通过从每局对弈中排除前6步和最后一步后,随机抽取3个位置,有效降低了样本间的时间相关性,从而获得了去相关的棋局状态集合。这一设计不仅提升了数据独立性,还为研究者探索更简洁、更具代表性的象棋数据集提供了新思路,在国际象棋AI策略学习领域具有潜在的影响力。
当前挑战
该数据集所解决的领域核心挑战在于国际象棋状态空间中样本高度相关的问题,传统时序采样导致模型过度拟合近期走法,缺乏泛化能力。通过去相关采样策略,数据集旨在缓解这一偏差,使得模型能够学习到更具策略独立性的局面特征。此外,构建过程中面临两项技术挑战:一是如何在保证数据充分代表性的前提下,确定合理的采样间隔与排除步数,避免丢失关键局面信息;二是需要平衡数据集的规模与多样性,以适配中小规模模型的训练计算资源,同时确保UCI格式走法标签和WDL分类标签的准确性,从而为策略学习与价值评估提供可靠监督信号。
常用场景
经典使用场景
在国际象棋人工智能研究领域,decorrelated-chess数据集以其独特的去相关性和空间高效性,成为训练中小型策略-价值网络模型的经典基准。该数据集从Lichess精英数据库中抽取每局棋的3个随机位置(排除前6步和最后一步),有效降低了相邻局面之间的相关性,为模型提供了多样化的学习样本。研究人员通常利用此数据集进行端到端的监督学习,从给定棋盘的FEN局面预测最佳走法(UCI格式)并评估白方胜负平的概率,从而搭建起从局面理解到决策输出的神经通路。
解决学术问题
此数据集巧妙地解决了传统棋类数据集中局面高度时序相关、易导致过拟合的学术难题。通过随机采样的去相关策略,它使模型能够聚焦于棋位本身的特征而非棋局进程的冗余信息,进而在弱监督条件下学习更鲁棒的局面评估函数。该数据集的推出,为策略梯度与价值函数协同训练提供了标准化训练语料,推动了以数据驱动的棋类AI从全盘模仿向泛化推理的进化,显著降低了中小型模型在不依赖大规模自对弈条件下的研发门槛。
衍生相关工作
围绕该数据集,学界衍生出一系列优化工作:例如采用注意力机制增强的特征提取网络,以捕获棋盘上非局域的战术关系;又如基于该数据分布设计的数据增强方法(如对称反射、弃子变换),有效提升了模型对小样本局面的泛化性。在知识蒸馏方向,部分工作利用此数据集训练紧凑型学生网络,模仿更大规模Transformer教师模型的策略分布,实现了高压缩比下的性能保持。这些衍生研究共同织就了从数据驱动到架构创新的技术图谱,巩固了decorrelated-chess作为棋类深度学习入门与对比实验标准数据集的地位。
以上内容由遇见数据集搜集并总结生成


