evipedia-reviews
收藏资源简介:
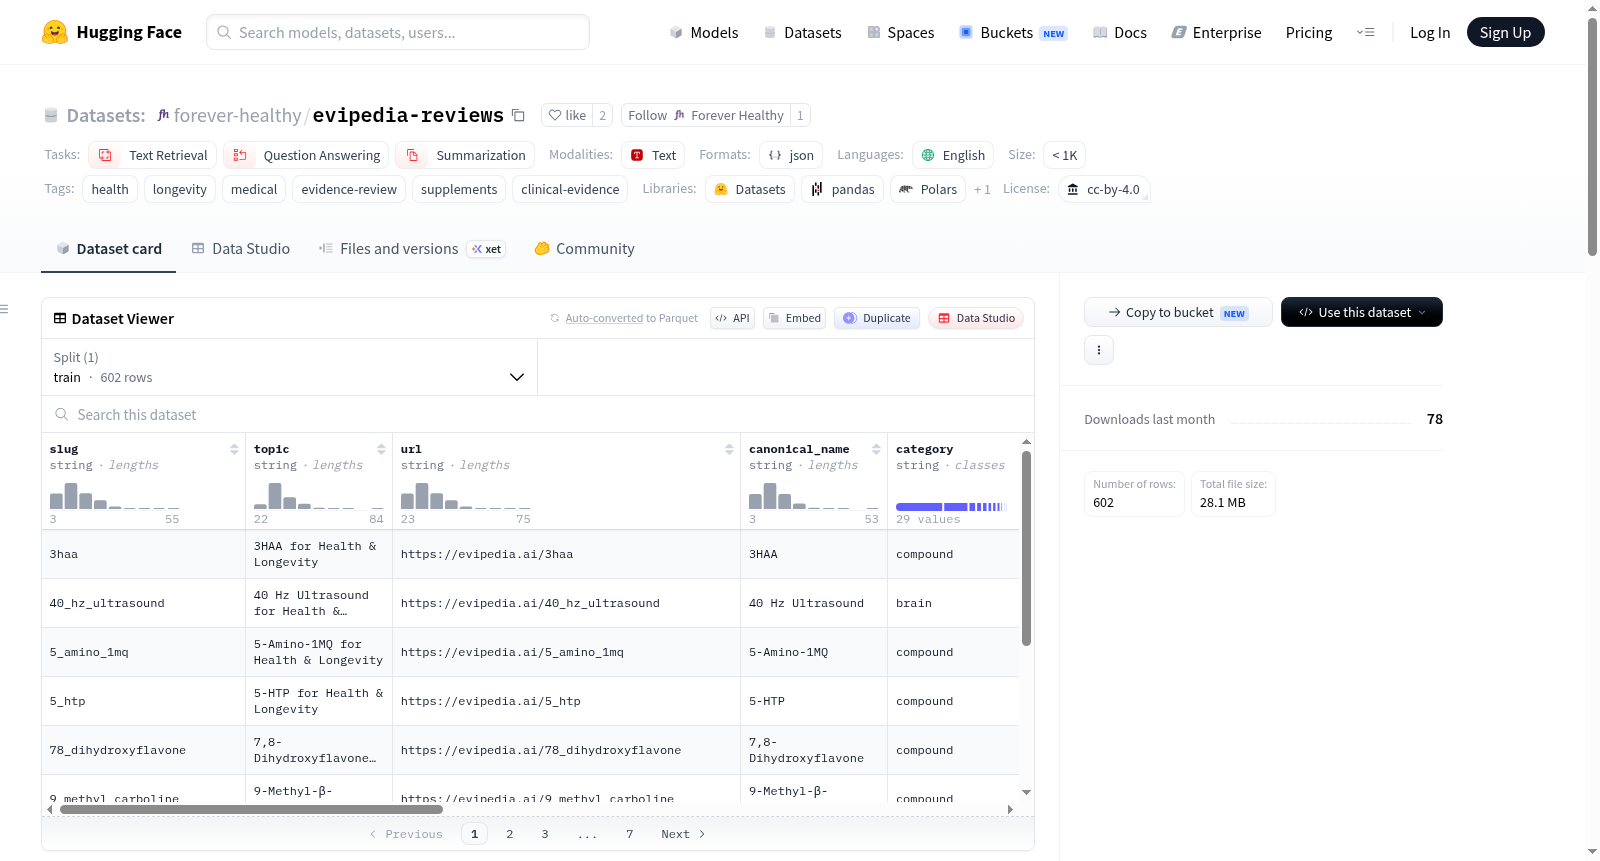
Evipedia Evidence Reviews数据集是evipedia.ai网站(一个持续更新的健康与寿命干预措施证据综述百科全书)的完整公开目录。它以JSON Lines格式组织,每条记录对应网站上的一个实时证据综述,包含综述的元数据和完整的Markdown正文内容,数据集规模小于1,000条记录。记录字段包括:slug(简短标识符,如rapamycin)、topic(综述标题)、url(规范URL)、canonical_name(干预措施名称,如Rapamycin)、category(类别,如medication、compound、diet等)、alternate_names(别名/品牌名数组)、datePublished/dateModified/lastReviewed(发布日期/修改日期/最后审核日期,ISO格式)、conclusion(纯文本结论)、citation(主要参考文献数组,包含name、url和可选的pmid字段)以及markdown(完整的证据综述Markdown正文)。该数据集适用于检索增强生成、健康干预证据的语义搜索、文本摘要,以及基于证据的医学文本微调/评估。数据来源于evipedia.ai网站构建时生成,并通过实时文件同步更新(平均每4-6周更新一次)。数据集遵循CC BY 4.0许可,允许自由重用(包括AI训练和生成),但需注明来源evipedia.ai并尽可能链接回原始综述。需要注意的是,Evipedia的综述为AI生成并经过审核,属于教育性证据综合,不构成医疗建议。
The Evipedia Evidence Reviews dataset is the complete public catalog of the evipedia.ai website, an encyclopedia of continuously updated evidence reviews for health and longevity interventions. It is organized in JSON Lines format, with each record corresponding to a live evidence review on the website, containing metadata and the full Markdown body content. The dataset has fewer than 1,000 records. Each record includes fields such as slug (short identifier, e.g., rapamycin), topic (review title), url (canonical URL), canonical_name (intervention name, e.g., Rapamycin), category (e.g., medication, compound, diet), alternate_names (array of aliases/brand names), datePublished/dateModified/lastReviewed (publication/modification/last review dates in ISO format), conclusion (plain text conclusion), citation (array of primary references with name, url, and optional pmid), and markdown (full evidence review Markdown body). It is suitable for retrieval-augmented generation, semantic search of health intervention evidence, text summarization, and evidence-based medical text fine-tuning/evaluation. The data originates from the evipedia.ai website construction and is updated via live file synchronization (averaging every 4-6 weeks). The dataset is licensed under CC BY 4.0, allowing free reuse (including AI training and generation) with attribution to evipedia.ai and linking back to the original review when possible. Note that Evipedia reviews are AI-generated and reviewed, serving as educational evidence synthesis and not medical advice.
Evipedia Evidence Reviews 数据集概述
基本信息
- 数据集名称:Evipedia Evidence Reviews
- 许可证:CC BY 4.0
- 语言:英文
- 数据规模:少于 1,000 条记录
- 数据集来源:https://evipedia.ai
- 发布方:Forever Healthy
任务类型
- 文本检索
- 问答
- 摘要生成
数据内容
每条记录对应一篇健康与长寿干预措施的循证评论,包含完整的 Markdown 正文及其元数据。
字段说明
| 字段 | 类型 | 描述 |
|---|---|---|
slug |
字符串 | 短标识符 / 永久链接的最后路径段 |
topic |
字符串 | 评论标题 |
url |
字符串 | 在 evipedia.ai 上的规范评论 URL |
canonical_name |
字符串 | 干预措施名称 |
category |
字符串 | Evipedia 分类(如 medication、compound、diet) |
alternate_names |
字符串数组 | 同义词 / 品牌名 |
datePublished / dateModified / lastReviewed |
字符串(ISO 日期) | 评论发布日期、修改日期、最后审核日期 |
conclusion |
字符串 | 评论的纯文本结论 |
citation |
对象数组 | 参考文献 — 包含 name、url、pmid? |
markdown |
字符串 | 完整的 Markdown 格式循证评论正文 |
数据格式
JSON Lines 格式,每行一个 JSON 对象。
数据生成方式
在网站构建时从实时循证评论生成,通过 /evipedia-corpus.jsonl 提供。
应用场景
- 检索增强生成
- 健康干预措施的语义搜索
- 摘要生成
- 基于证据的医疗文本微调/评估
更新频率
源评论平均每 4-6 周更新一次,数据集同步更新。
引用与使用
可自由使用(CC BY 4.0),需标注来源 evipedia.ai 并在可行时链接回评论的永久链接。
局限性
Evipedia 的评论由 AI 生成并经过审核,属于教育性证据综合,不构成医疗建议。详情见官网限制与免责声明页面。