
遇见数据集

MINT-SJTU/STI-Bench

收藏
Hugging Face2026-01-12 更新2025-04-26 收录
官方服务:

资源简介:

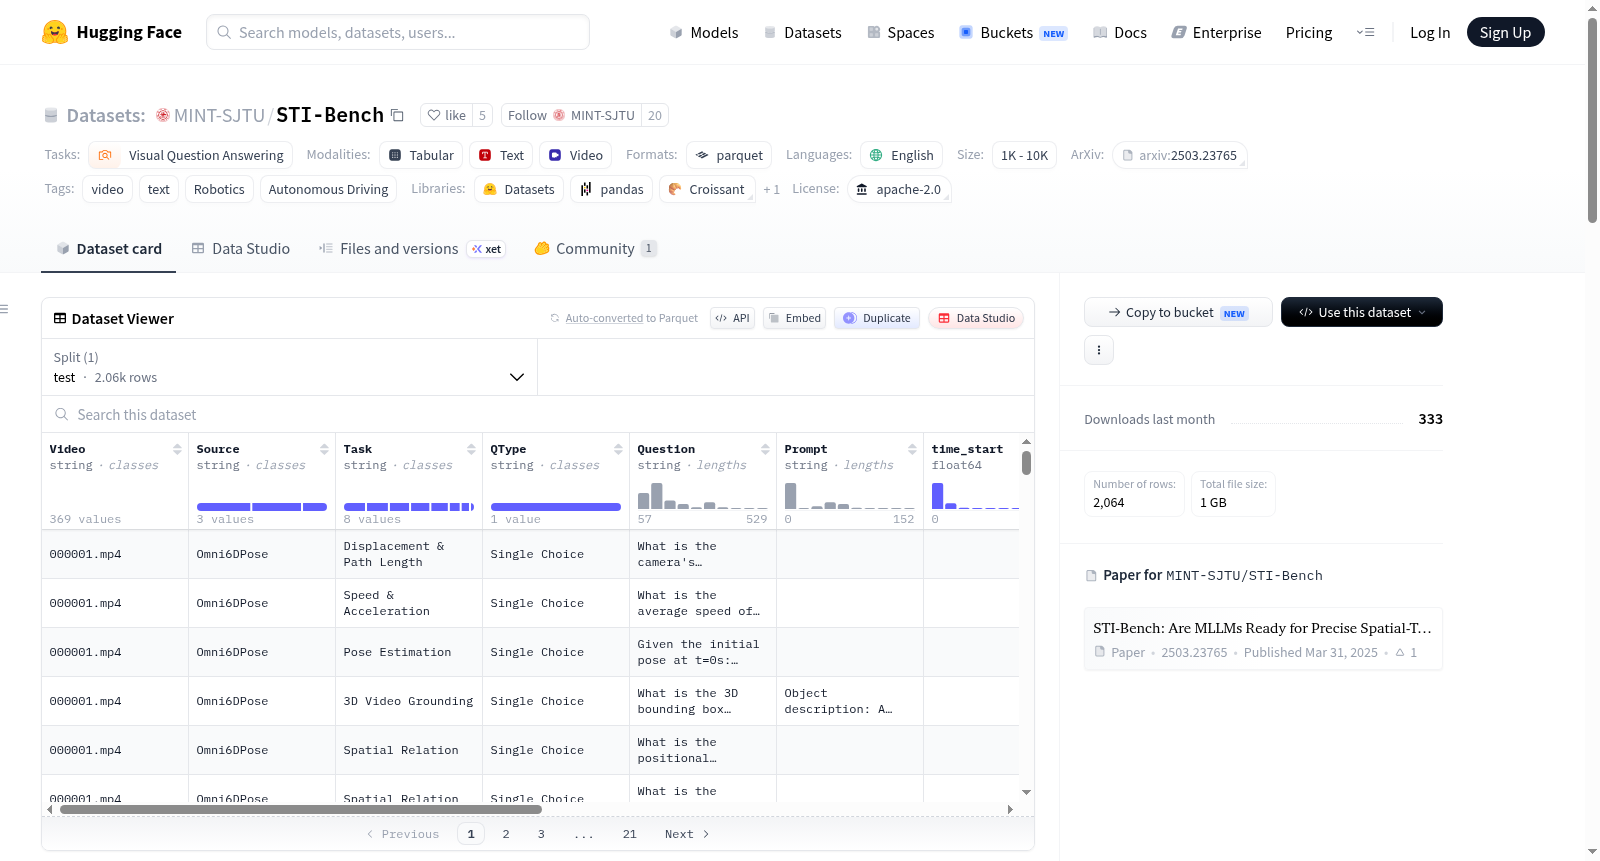
STI-Bench是一个用于评估多模态大型语言模型(MLLMs)对现实世界视频数据中空间时间概念理解能力的基准数据集。该数据集包含超过2000个问题-答案对,涵盖300个视频,这些视频来源于Omni6DPose、ScanNet和Waymo等数据集,包含了桌面设置、室内场景和室外场景等真实世界环境。STI-Bench旨在挑战模型在静态和动态空间时间任务上的能力,包括3D视频定位、自我中心定位、姿态估计、尺寸测量、位移和路径长度估计、速度和加速度预测、空间关系识别和轨迹描述等任务。

STI-Bench is a benchmark dataset for evaluating the ability of Multimodal Large Language Models (MLLMs) to understand spatial-temporal concepts through real-world video data. The dataset contains more than 2,000 question-answer pairs across 300 videos, sourced from datasets like Omni6DPose, ScanNet, and Waymo, covering real-world environments such as desktop settings, indoor scenes, and outdoor scenarios. STI-Bench is designed to challenge models on both static and dynamic spatial-temporal tasks, including 3D Video Grounding, Ego-Centric Orientation, Pose Estimation, Dimensional Measurement, Displacement & Path Length, Speed & Acceleration, Spatial Relation, and Trajectory Description tasks.
提供机构:
MINT-SJTU
搜集汇总
数据集介绍
MINT-SJTU/STI-Bench 数据集图片
构建方式
STI-Bench 数据集由上海交通大学 MINT 团队构建,旨在评估多模态大语言模型在时空理解方面的能力。该数据集从 Omni6DPose、ScanNet 和 Waymo 等真实世界数据源中精选了超过 300 个视频,覆盖桌面、室内和室外等多种场景。每个视频均配有多道选择题,共计 2064 个问题-答案对,问题类型涵盖 3D 视频定位、自我中心朝向估计、姿态估计、尺寸测量、位移与路径长度、速度与加速度、空间关系及轨迹描述等八大任务。数据集的构建流程严谨,每个样本包含视频来源、任务类型、问题文本、提示信息、时间戳、候选选项、正确答案及其详细描述等字段,为模型评估提供了结构化的标准化基准。
特点
STI-Bench 的显著特点在于其聚焦于精细的时空智能评估,挑战模型对视频中物体外观、姿态、位移和运动的估计、预测与理解能力。数据集涵盖静态与动态双重维度,既要求模型理解空间关系与物体尺寸,也需预测运动轨迹与速度等时序信息。所有问题均基于真实世界视频,避免了合成数据的偏差,且每个问题均提供精确的数值答案或选项,支持客观的准确率评估。此外,数据集规模适中(1K-10K),便于快速迭代测试,同时其多源场景设计确保了评估的泛化性。
使用方法
使用 STI-Bench 时,研究者可通过 Hugging Face 或 GitHub 仓库获取数据集与评估代码。推荐使用 git-lfs 工具克隆数据,然后加载 JSON 格式的样本文件。每个样本包含视频路径、问题、候选答案及正确选项,模型需基于视频片段(由 time_start 和 time_end 指定)进行推理并输出答案。评估基于多选问题的精确匹配计算准确率,官方提供了开箱即用的评估脚本,并兼容 EASI 等开源评估工具。研究者可直接将模型预测结果与 Answer 字段比对,从而量化模型在时空理解任务上的表现。
背景与挑战
背景概述
时空智能是迈向通用人工智能的关键一环,尤其是在机器人导航、自动驾驶等对动态环境感知要求严苛的领域,多模态大语言模型(MLLMs)是否具备精确的时空推理能力,已成为学术界与工业界共同关注的焦点。由上海交通大学MINT实验室于2025年提出的STI-Bench(Spatial-Temporal Intelligence Benchmark),正是为了系统性地评估MLLMs在真实世界视频数据中对物体外观、位姿、位移及运动等时空概念的感知与预测能力。该基准测试包含超过2000个问答对,覆盖桌面、室内及户外等多种场景,数据源自Omni6DPose、ScanNet与Waymo等权威数据集,旨在填补现有视觉问答基准在精细时空理解评估上的空白。STI-Bench的发布为衡量模型在动态三维环境中的智能水平提供了标准化工具,其影响力已通过ICCV 2025论文、多家媒体及开源社区获得广泛认可。
当前挑战
STI-Bench所面临的挑战首先体现在领域问题的复杂性上:与传统的图像分类或静态视觉问答不同,时空智能要求模型同时理解三维几何、时间动态与运动物理,例如从视频中精确估计物体速度、加速度或相机旋转角度,这对MLLMs的感知精度与推理深度构成了严峻考验。其次,在基准构建过程中,研究团队需克服多源数据融合的难题——将来自不同传感器、视角与场景的Omni6DPose、ScanNet与Waymo视频统一标注格式,并设计涵盖3D视频定位、自我中心朝向等八类细粒度任务的问答对,确保每个问题都有唯一正确答案且避免歧义。此外,视频片段的时间起止标注、候选答案的合理性以及跨场景的泛化性,均为数据质量控制带来了显著挑战。
常用场景
经典使用场景
STI-Bench作为面向多模态大语言模型(MLLMs)的时空智能基准,其经典使用场景在于系统性地评估模型对真实世界视频中物体外观、位姿、位移与运动等时空概念的精确理解能力。该数据集涵盖3D视频定位、自我中心朝向估计、位姿估计、尺寸测量、位移与路径长度计算、速度与加速度预测、空间关系推理以及轨迹描述等八大核心任务,通过超过2000道选择题对模型的静态与动态时空推理能力进行细粒度评测。其设计巧妙融合了桌面、室内与户外等多种真实场景,迫使模型在复杂视觉环境中展现对连续时间维度与三维空间结构的联合建模能力,从而成为衡量MLLMs是否具备迈向通用空间智能的关键试金石。
实际应用
在实际应用层面,STI-Bench所评测的时空智能能力直接关联于机器人自主导航、自动驾驶决策、增强现实交互及视频监控分析等前沿领域。例如,机器人需要精确估计自身位姿与周围物体的位移以实现抓取操作,自动驾驶系统需实时预测其他交通参与者的速度与轨迹,这些场景均要求模型具备类似人类的空间直觉与时间推理。该基准通过模拟真实世界的动态复杂环境,为工业界评估和筛选多模态模型提供了可靠的性能标尺,有助于加速具备精准时空理解能力的AI系统从实验室走向实际部署,从而提升智能体在动态物理世界中的安全性与鲁棒性。
衍生相关工作
STI-Bench的发布已催生了一系列衍生研究工作,包括探究视频基础模型在时空推理上的表现边界、开发针对性的时空知识注入训练策略,以及构建更高效的视频问答评估框架。例如,EASI工具链的集成使得研究者能够快速复现评测流程,而后续工作则借鉴其任务设计思路,进一步细化了面向自动驾驶场景的时空基准或融合了多传感器数据的评测方案。此外,该数据集还激发了关于MLLMs时空表征可解释性的探讨,促使学者们分析模型在回答诸如‘物体位移’或‘速度变化’等问题时内部注意力机制的动态演化,从而推动了可解释人工智能在视频理解领域的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

