
RUMBA (Russian User Memory Benchmark)
收藏资源简介:
RUMBA是由DAIMLD机构创建的首个专注于俄语长时对话记忆评估的基准数据集,旨在解决现有基准在俄语领域缺失及对记忆交互行为覆盖不足的问题。该数据集包含85个带时间戳的用户-助手对话,共计1,543个标注问答对,对话平均长度约34万字符,数据来源于人工编写的多样化用户交互场景,并融入了俄语社会文化特征。其创建过程涉及多阶段设计,由26名贡献者参与,通过精细的语义、数量和时间性三维分类法构建。该数据集主要应用于评估语言模型在长期对话中的记忆存储、更新、推理及遗忘等能力,为开发可靠的俄语对话系统提供诊断工具。
RUMBA is the first benchmark dataset focused on evaluating long-form conversational memory in Russian, created by the DAIMLD institution. It aims to address the gaps in existing benchmarks for the Russian language domain and their insufficient coverage of memory interaction behaviors. This dataset includes 85 timestamped user-assistant conversations, totaling 1,543 annotated question-answer pairs, with an average conversation length of approximately 340,000 characters. The data is derived from diverse manually authored user interaction scenarios and incorporates Russian socio-cultural characteristics. Its development involves a multi-stage design process with 26 contributors, and it is constructed using a refined three-dimensional taxonomy covering semantics, quantity, and temporality. This dataset is primarily used to evaluate the capabilities of language models in long-term conversations, including memory storage, updating, reasoning, and forgetting, providing a diagnostic tool for developing reliable Russian conversational systems.
数据集概述
数据集名称: RUMBA (Russian User Memory Benchmark)
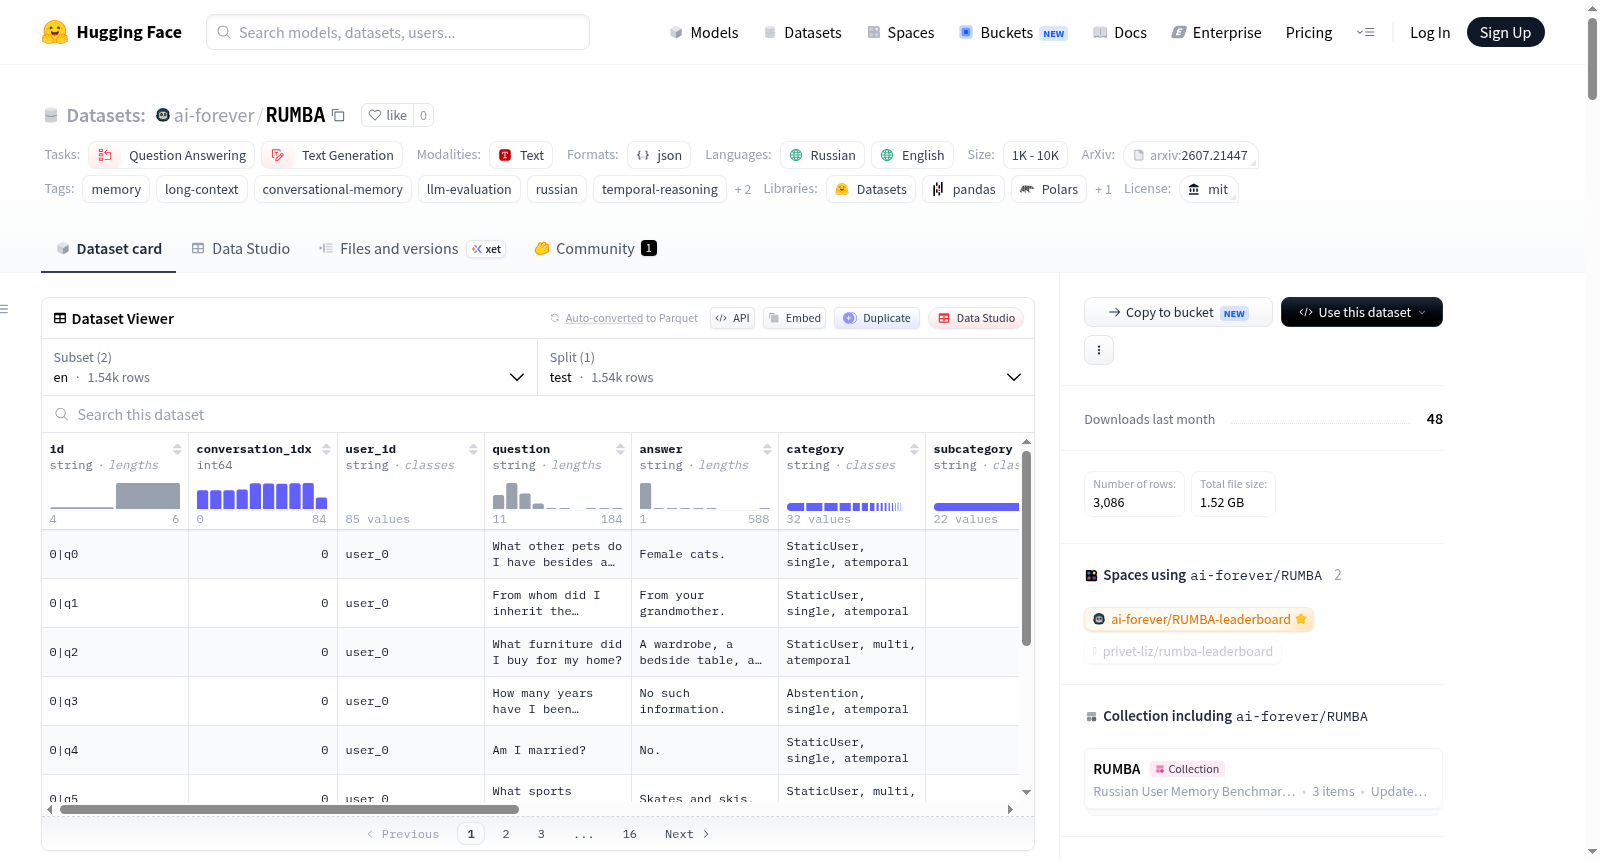
数据集地址: https://huggingface.co/datasets/ai-forever/RUMBA
1. 核心目标与设计
RUMBA 是一个长期对话记忆基准测试,用于评估语言模型和记忆系统如何回答关于长跨度、多轮对话的问题。它测试系统是否能够检索、整合并推理分布在长时间对话历史中的证据。
该数据集主要用于评估,而非模型训练。可用于比较:
- 全上下文长上下文模型
- 检索增强生成系统
- 显式长期记忆框架
2. 数据集规模
| 指标 | 数值 |
|---|---|
| 对话数量 | 85 个(含独特用户) |
| 对话轮次 | 4,031 次 |
| 话语总数 | 36,558 条 |
| 问答对 | 1,543 个(已标注) |
| 语言版本 | 俄语 (ru) 和英语 (en),结构与问题结构匹配 |
3. 数据集结构
使用扁平 JSONL 格式存储,每行为一个独立的问答示例,包含回答该问题所需的完整对话历史。
核心字段:
-
对话与会话字段:
conversation_idx: 源对话的数字标识符user_id: 合成用户标识符conversation: 完整的、多轮对话历史,每个会话包含:session_idx: 会话索引session_datetime: 会话时间戳conversation: 话语列表(每个包含role和message字段)
-
问题与标注字段:
id: 唯一标识符(格式:<conversation_idx>|q<question_idx>)question: 从用户视角提出的基准问题question_date: 提问时间戳(用于解读相对日期、时间推理)answer: 参考答案category: 三个维度的标注(语义类型、会话范围、时间性),例如DateExtraction, single, temporalsubcategory/subsubcategory: 类别特定子类型(可选)text_temporal_expression: 证据中的时间表达类型标签(explicit_te、implicit_te、no_te)evidence: 支持回答问题所需的证据会话索引列表
类别维度详解:
- 语义类型:包括提取型(如
StaticUser、UpdatingInfo、DateExtraction)、推理型(如SocialRelationship、Arithmetic、TemporalCommonsense)、以及弃权型(Abstention)。 - 会话范围:
single(证据在一个会话内)或multi(需要跨会话组合证据)。 - 时间性:
atemporal(无需时间信息)或temporal(需时间定位)。
4. 任务与评估
- 支持任务:长期对话记忆评估、长上下文问答、检索增强记忆系统、跨多轮对话的时间推理。
- 评估指标:F1 分数、RUMBA 专用指标(
rumba_metric)。 - 使用方式:可通过 LightEval 任务配置或 HuggingFace
datasets库加载。
5. 加载方式
使用 LightEval:
python memorybench_qa = LightevalTaskConfig( name="rumba", prompt_function=memorybench_prompt, hf_repo="ai-forever/RUMBA", hf_subset="ru", # or "en" hf_avail_splits=["test"], evaluation_splits=["test"], metrics=[Metrics.f1_score, Metrics.rumba_metric], stop_sequence=[" "], )
使用 HuggingFace datasets:
python from datasets import load_dataset
ds_ru = load_dataset("ai-forever/RUMBA", "ru", split="test") ds_en = load_dataset("ai-forever/RUMBA", "en", split="test")
本地加载 JSONL:
python from datasets import load_dataset
ds_ru = load_dataset("json", data_files="rumba-ru.jsonl", split="train") ds_en = load_dataset("json", data_files="rumba-en.jsonl", split="train")
6. 语言与许可
- 语言:俄语(主要版本)和英语(用于跨语言比较)
- 许可:MIT 许可证
- 标签:memory、long-context、conversational-memory、llm-evaluation、russian、temporal-reasoning、question-answering、retrieval-augmented-generation
7. 引用信息
bibtex @misc{shevtsova2026rumbarussianusermemory, title={RUMBA: Russian User Memory Benchmark}, author={Elizaveta Shevtsova and Inna Glebkina and Mark Baushenko and Pavel Gulyaev and Alena Fenogenova}, year={2026}, eprint={2607.21447}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2607.21447}, }
- 1RUMBA: Russian User Memory BenchmarkDAIMLD · 2026年



