VidHal
收藏资源简介:
VidHal是一个用于评估和分析视觉语言模型(VLMs)中视频幻觉的基准数据集。它包含了一系列涵盖五个关键时间维度的多样化视频:动作、属性、对象、事件顺序和方向。为了促进对视频幻觉的细粒度评估,引入了新的任务——字幕排序,以及多项选择题回答。
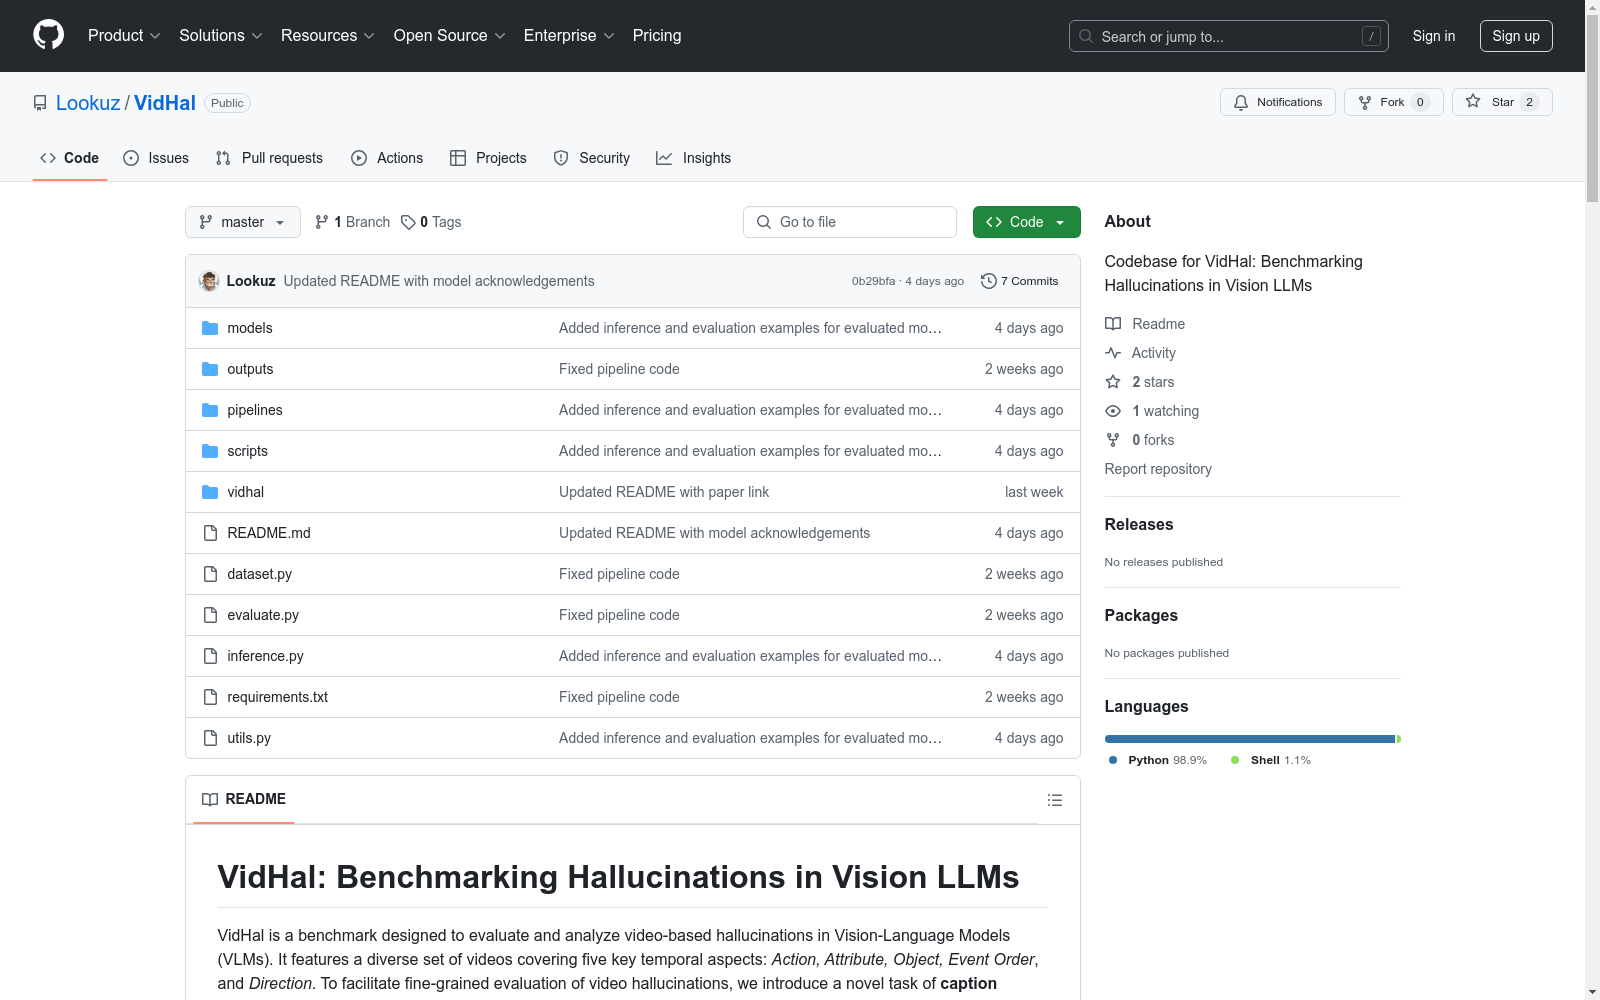
VidHal is a benchmark dataset for evaluating and analyzing video hallucinations in vision-language models (VLMs). It contains a series of diverse videos covering five key temporal dimensions: action, attribute, object, event order, and direction. To facilitate fine-grained evaluation of video hallucinations, two novel tasks are introduced: caption ranking and multiple-choice question answering.
VidHal: Benchmarking Hallucinations in Vision LLMs
概述
VidHal 是一个用于评估和分析视觉语言模型(VLMs)中基于视频的幻觉现象的基准测试。该基准涵盖了五个关键的时间维度:动作、属性、对象、事件顺序和方向。为了进行细粒度的幻觉评估,引入了新的任务——字幕排序,以及多项选择题回答。
数据集下载
- 标注和预定义的随机选项顺序位于
vidhal文件夹下。 - 基准测试数据集视频可以从以下链接下载:视频下载链接,下载后应解压到
vidhal/videos目录。
环境设置
提供了 requirements.txt 文件,包含运行评估代码所需的基本库和工具。使用 pip 安装这些依赖项以及模型所需的依赖项。
模型评估
推理
- 推理代码位于
pipelines/inference目录下。 - 提供了用于生成模型预测的骨架代码,包括论文中使用的所有评估任务的提示,以及运行推理的接口。
- 可以通过重写
pipelines/inference/base.py中的代码来适应您的模型需求。
评估
- 生成预测后,可以通过运行
evaluate.py来评估这些响应。 - 提供了命令行脚本,用于运行
evaluate.py。
模型
提供了用于评估 VideoChat2、VideoLLaMA2、mPLUG-Owl3 和 LLaVA-NeXT-Video 模型的代码。
评估结果
提供了多个最先进的视频 VLMs 在 VidHal 基准测试中的结果。
| VLM | MCQA | Naive Caption Ordering | Relative Caption Ordering |
|---|---|---|---|
| VideoChat2 (Vicuna) | 0.410 | 0.490 | 0.573 |
| VideoChat2 (Mistral) | 0.524 | 0.348 | 0.579 |
| VideoChat2 (Phi3) | 0.468 | 0.552 | 0.522 |
| mPLUG-Owl3 | 0.596 | 0.641 | 0.707 |
| LLaVA-NeXT-Video (7B) | 0.509 | 0.518 | 0.620 |
| LLaVA-NeXT-Video (32B) | 0.663 | 0.641 | 0.747 |
| VideoLLaMA2 (7B) | 0.541 | 0.564 | 0.622 |
| VideoLLaMA2 (72B) | 0.647 | 0.787 | 0.760 |
| GPT-4o | 0.772 | 0.840 | 0.826 |
| Gemini-1.5 Flash | 0.657 | 0.738 | 0.745 |
| Gemini-1.5 Pro | 0.671 | 0.765 | 0.753 |
引用
如果发现我们的工作对您的研究有价值或有用,请考虑引用。
@article{choong2024vidhal, title={VidHal: Benchmarking Temporal Hallucinations in Vision LLMs}, author={Wey Yeh Choong and Yangyang Guo and Mohan Kankanhalli}, journal={arXiv preprint arXiv:2411.16771}, year={2024} }