
遇见数据集

iclr-wm-backup-public

收藏
Hugging Face2026-08-06 更新2026-08-07 收录
官方服务:

资源简介:

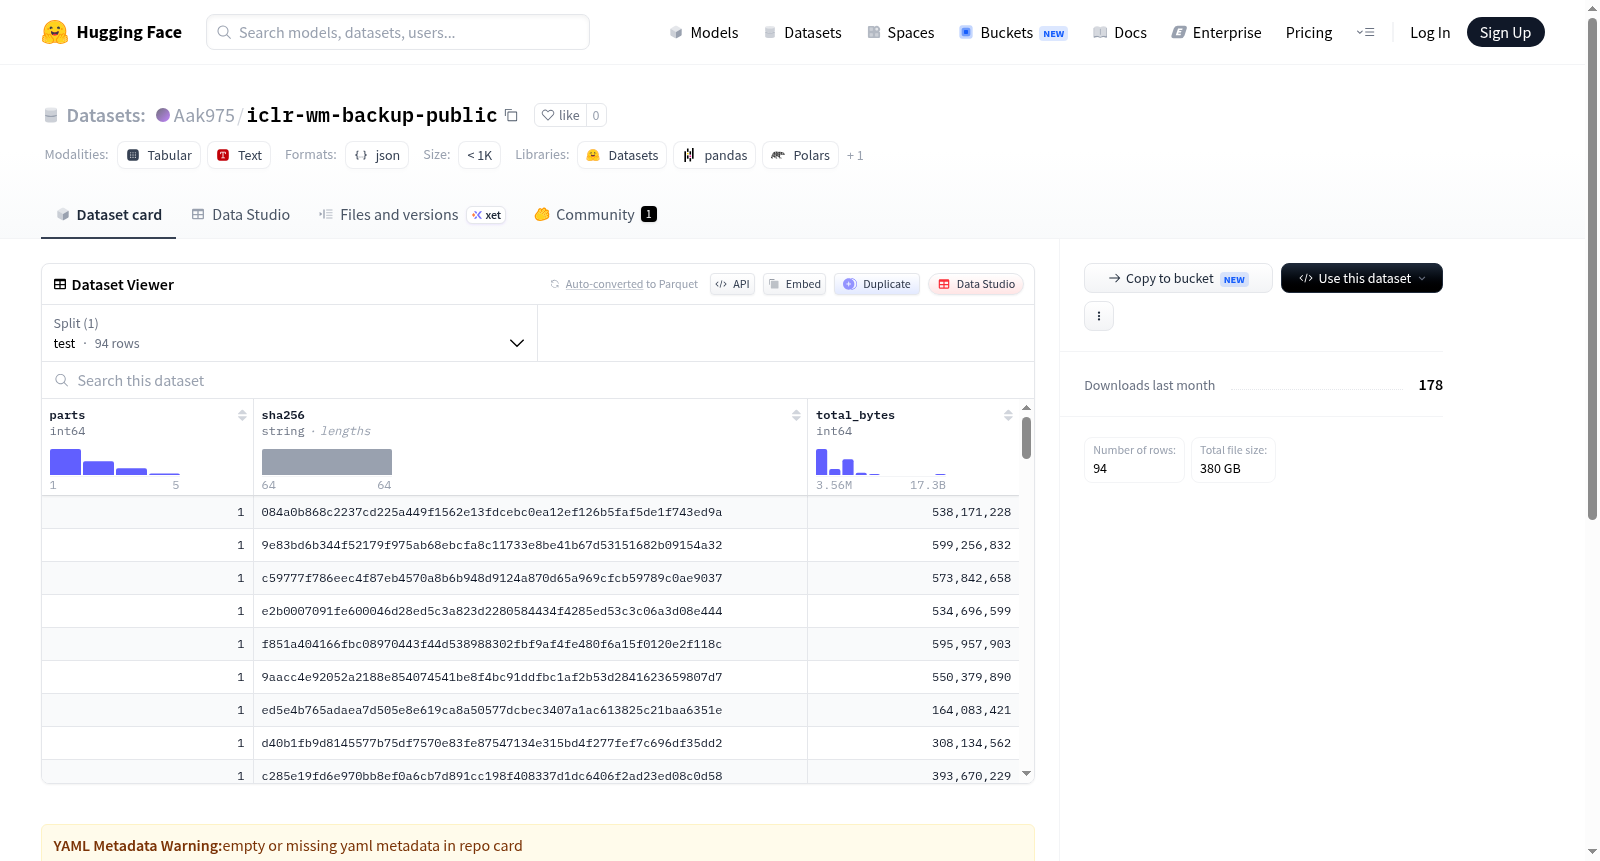
该数据集是ICLR水印基准测试实验的公共部分,作为备份仓库的溢出存储。它包含实验中可共享的水印图像和经过攻击处理的图像数据。数据以归档文件形式组织,每个归档由多个part文件和一个MANIFEST.json文件组成,MANIFEST.json记录了部件数量、整个流的SHA256哈希值和总字节数。该部分不包含任何密钥或论文草稿。数据集适用于水印检测、攻击鲁棒性评估等研究任务。

This dataset is the public part of the ICLR watermark benchmark experiment, used as overflow storage for a backup repository. It contains shareable watermark images and attack-processed image data from the experiment. The data is organized in archive files, each consisting of multiple part files and a MANIFEST.json file, which records the number of parts, the SHA256 hash of the entire stream, and the total byte count. This part does not contain any keys or drafts of the paper. The dataset is suitable for research tasks such as watermark detection, attack robustness evaluation, etc.

创建时间:
2026-08-01
原始信息汇总

数据集概述:ICLR Watermark Benchmark — backup overflow (public part)

该数据集是 ICLR 水印基准测试(Watermark Benchmark)备份的公开部分,与私有仓库 Aak975/iclr-wm-backup 共同构成一个完整的备份。由于私有仓库达到存储配额,本公开部分被创建以分担存储压力。

内容与结构

  • 数据内容:仅包含水印基准测试实验中可公开分享的图像数据(水印化/被攻击后的图像),不包含任何密钥或论文草稿。
  • 文件布局:采用 archives/<子目录>/part-0000 ... part-NNNN, MANIFEST.json 的目录结构,每个归档文件均附带校验清单。
  • 恢复方式:通过 cat part-* | zstd -d | tar -x 命令可恢复单个归档;MANIFEST.json 文件记录了分片数量(parts)、整体流 SHA256 哈希值(sha256)和总字节数(total_bytes)。

使用说明

  • 完整的恢复步骤需参考私有仓库中的 docs/RESTORE.md 文档,其恢复脚本会自动读取两个仓库(公开部分与私有部分)的数据。
  • 本公开部分与私有仓库保持相同的布局,两份数据互补,文件均唯一存在于其中一个仓库中。
搜集汇总
数据集介绍
iclr-wm-backup-public 数据集图片
构建方式
该数据集作为ICLR水印基准测试的公共备份溢出部分,与私有仓库共同构成一个完整的备份体系。其构建方式遵循严格的分区存储原则,所有文件按子目录归档,并配备MANIFEST.json清单文件以记录分片数量、整体SHA256哈希及总字节数,确保数据完整性与可校验性。公共部分仅包含实验中生成的可共享图像数据,如水印处理及攻击后的图像,密钥与论文草稿等敏感信息则被排除在外。
特点
该数据集的核心特点在于其结构化的备份策略与数据筛选机制。通过将备份拆分为公共与私有两部分,既保障了数据的安全性,又实现了资源共享的灵活性。公共部分聚焦于图像数据,便于研究人员在不触碰敏感信息的前提下,访问水印基准实验的可视化成果。同时,标准化的归档与校验流程,确保数据在跨仓库合并时的一致性,为大规模实验数据的可复现性与可追溯性提供了坚实支撑。
使用方法
该数据集的使用方法依赖于其归档的恢复流程。用户需借助私有仓库中的恢复脚本,该脚本会自动读取公共与私有两个仓库的数据。具体操作时,用户可按照README指示,通过cat命令将分片文件合并,再经zstd解压与tar解包,即可还原单个归档。整个过程以MANIFEST.json为索引,确保恢复的完整性与准确性。这种设计既简化了操作,又通过自动化的脚本整合,降低了用户手动处理的复杂度,提升了数据获取的效率与可靠性。
背景与挑战
背景概述
该数据集源自ICLR论文相关的水印基准测试项目,由研究团队为评估图像水印技术在对抗攻击下的鲁棒性而构建。创建时间可追溯至论文撰写期间,主要研究人员或机构未在公开部分明确,但可通过HuggingFace页面推断为Aak975等。其核心研究问题聚焦于量化水印算法在遭受各种攻击后的可恢复性及安全性,旨在为生成式图像水印领域提供标准化评测基准。该数据集作为公开备份的溢出部分,仅包含可共享的含水印及被攻击图像,有效支撑了研究的可复现性,对推动水印技术评测的透明性和标准化具有积极影响。
当前挑战
该数据集面临多重挑战:领域内,水印评测需平衡鲁棒性、不可见性与安全性,对抗攻击如压缩、裁剪、噪声等会显著影响水印提取,现有基准往往缺乏覆盖全面攻击类型的标准化数据集,导致研究结果难以横向对比。构建过程中,由于原始仓库存储配额达到上限,数据被迫分割为私有与公开两部分,带来了数据完整性与恢复的复杂性,每个文件均需通过MANIFEST.json校验和分块存储,确保跨库拼接后的数据一致性;同时,公开部分仅限可共享图像,严格排除密钥和草稿,这要求在不泄露敏感信息的前提下维持数据集的可复用性,增加了组织与权限管理的难度。
常用场景
经典使用场景
该数据集作为ICLR水印基准测试的公共备份部分,主要服务于数字图像水印领域的研究者,用于评估水印算法在遭受各类攻击后的鲁棒性。其核心使用场景包括:加载含水印图像及经过攻击处理的图像,以重现基准测试中的实验流程;通过比对原始图像与攻击后图像,量化水印的不可见性和抗攻击能力。研究者可依据数据集中的档案文件结构,结合提供的恢复脚本,实现数据集的完整还原,从而进行标准化、可复现的水印性能对比实验。
实际应用
在实际应用中,该数据集可用于评测和优化数字内容版权保护系统。例如,媒体平台可依据此数据集测试其水印技术在图像遭受压缩、裁剪、旋转等常见操作后的存活率,以选择合适的水印嵌入策略。此外,该数据集也为司法取证中的图像来源追踪提供了测试基准,助力验证水印在真实世界攻击下的有效性。
衍生相关工作
该数据集衍生的相关工作包括:基于该基准开发更鲁棒的水印算法,如利用深度学习自适应嵌入水印以对抗未知攻击;构建水印攻击的对抗性样本生成器,以模拟更严苛的篡改场景;以及设计水印性能的自动化评估工具,如指标计算和可视化平台。这些工作进一步拓展了水印研究的边界,促进了可逆水印、盲检测等方向的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


