quantum-finance-risk-benchmark
收藏资源简介:
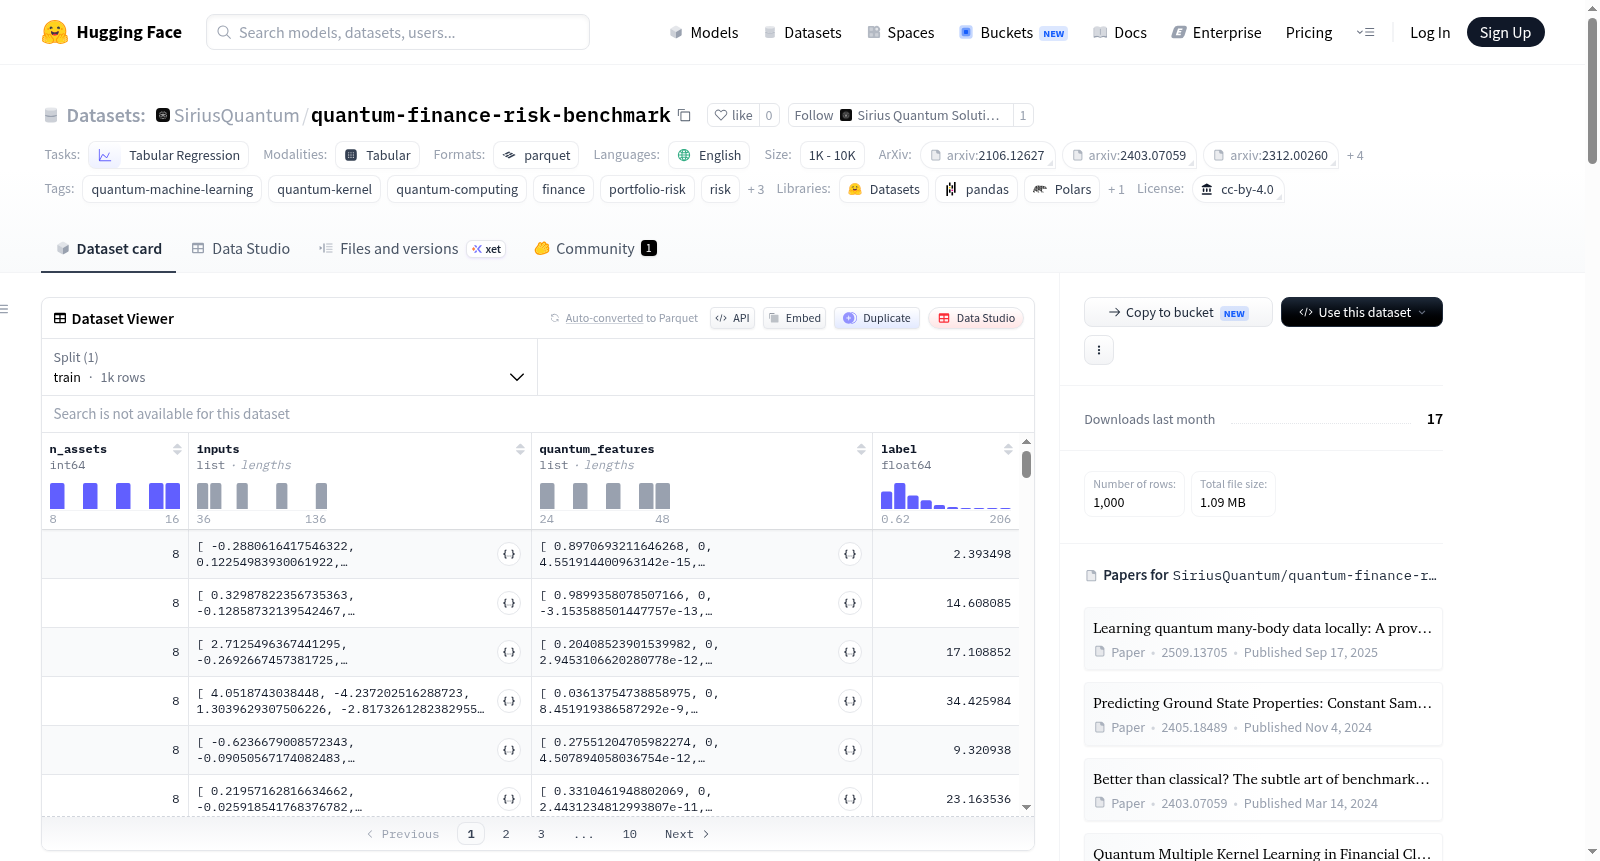
该数据集是一个用于学习系统性投资组合风险结构的合成基准数据集,旨在比较量子表示与经典核方法在样本效率上的表现。随着投资组合规模从8项资产增长到16项资产,经典核的性能会退化至接近随机水平(0.99),而量子表示则能持续学习(0.69),从而形成一个随投资组合规模扩大而加剧的持久性样本效率差距。数据集中的每个样本代表一个由单因子相关结构(资产载荷)和每项资产波动率定义的市场状态,编码为相关资产的伊辛哈密顿量。`quantum_features`字段是其基态的单量子比特期望值(量子表示);`label`字段是精确的系统性协同运动可观测量`Σ_{i<j} C_ij ⟨Z_i Z_j⟩`。数据集结构包含四个字段:`n_assets`(投资组合大小,取值为8、10、12、14、16)、`inputs`(上三角相关耦合`C_ij`和每项资产波动率`h_i`)、`quantum_features`(1-RDM期望值`⟨X_i⟩,⟨Y_i⟩,⟨Z_i⟩`,长度为`3·n_assets`)和`label`(系统性协同运动值)。数据集共包含1000行数据,每个投资组合规模对应200行。该数据集适用于研究量子机器学习、量子核、投资组合风险管理、样本复杂性以及经典阴影等任务。需要强调的是,数据是合成的,基于金融结构化的哈密顿量,因此这是一个针对风险形态任务的表示基准,而非关于市场、定价或交易的主张。数据集还包含了在实际量子硬件(IBM Marrakesh和IQM Garnet)上对特征测量路径的验证结果,单量子比特特征的重建误差约为2-5%。数据集使用CC-BY-4.0许可证。
数据集概述
- 名称:Quantum vs Classical Kernels on Portfolio-Risk Structure (Synthetic Benchmark)
- 许可证:CC-BY-4.0
- 语言:英语
- 任务类别:表格回归
- 大小:1,000 行(1K < n < 10K)
- 配置:默认配置(
data.parquet)
数据集描述
该合成基准数据集用于从量子表示中学习系统性投资组合风险结构。随着投资组合规模从8个资产增长到16个资产,经典核的表现退化至随机水平(0.99),而量子表示仍保持学习能力(0.69),两者之间的样本效率差距持续扩大。
每个样本是一个编码为量子态的相关资产风险体制,并配有精确的系统性风险标签;量子表示是基态的单量子比特测量结果。数据是合成的(金融结构哈密顿量),因此这是一个基于风险形状任务的表示基准,不涉及市场、定价或交易声明。
数据集结构
| 字段 | 类型 | 描述 |
|---|---|---|
n_assets |
int |
投资组合规模(8, 10, 12, 14, 16) |
inputs |
list[float] |
上三角相关性耦合 C_ij(因子载荷)和每资产波动率 h_i |
quantum_features |
list[float] |
单粒子约化密度矩阵期望值 ⟨X_i⟩,⟨Y_i⟩,⟨Z_i⟩,长度为 3·n_assets |
label |
float |
系统性协同运动 Σ_{i<j} C_ij ⟨Z_i Z_j⟩(精确值) |
- 共1,000行:每个投资组合规模200行。
样本复杂度与扩展性结果
测试误差按每个核的随机标签水平归一化(1.0 = 无学习),结果从 verification.json 重新计算。
| 资产数量 | 量子核 | 经典核 |
|---|---|---|
| 8 | 0.45 | 0.54 |
| 12 | 0.60 | 0.82 |
| 16 | 0.69 | 0.99 |
- 在16个资产时,经典核处于随机水平(0.99,已停止学习),而量子表示仍在学习(0.69)。
- 量子误差也随规模增加而上升:任务随投资组合增长而变难,优势在于持续的差距,而非平坦的曲线。
硬件特征测量验证
特征为单量子比特测量,可在真实量子处理器上读取。验证结果如下:
| 测量状态 | 量子比特数 | 精确参考 | IQM Garnet (20q) | IBM Marrakesh (156q) |
|---|---|---|---|---|
| `Ry(θ) | 0⟩` | 1 | [0.866, 0.000, -0.500] |
[0.858, 0.012, -0.481](~2%) |
| 浅层纠缠电路 | 4 | 12个期望值(精确,部分迹) | 平均9.7%,最大25% | 平均2.2%,最大6.1% |
- 单量子比特特征在两家供应商上重建精度约为2–5%。
- 对于4量子比特纠缠态,IBM Marrakesh保持约2%,而IQM Garnet上升至约10%均值。
加载方式
python from datasets import load_dataset
ds = load_dataset("SiriusQuantum/quantum-finance-risk-benchmark")["train"] X = ds["quantum_features"] # 量子表示 y = ds["label"] # 系统性风险可观测值
对比在 X 和 ds["inputs"] 上的经典模型;通过 ds["n_assets"] 进行筛选以查看扩展性
可复现性
recipe.json记录了引擎提交版本、随机种子、生成器和字段定义;每一行均可确定性复现。verification.json包含从数据重新计算得到的样本复杂度结果。
范围与限制
- 数据为合成数据(金融结构哈密顿量),非真实市场数据,这是一个基于风险任务的量子表示基准。
- 优势体现在样本复杂度,而非运行时加速,且仅在最多16个资产上得到验证。
- 单因子相关模型随投资组合增长趋向平均场(乘积态),优势在较大规模下是否持续或仅为有限尺寸效应尚待研究。
- 在真实表格金融数据(信用评分、支付欺诈)上,经典核具有竞争力。
- 硬件结果仅验证了特征测量路径(至4量子比特纠缠态),非在硬件上测量的完整学习曲线。