cp2021-semantic-search-app
收藏资源简介:
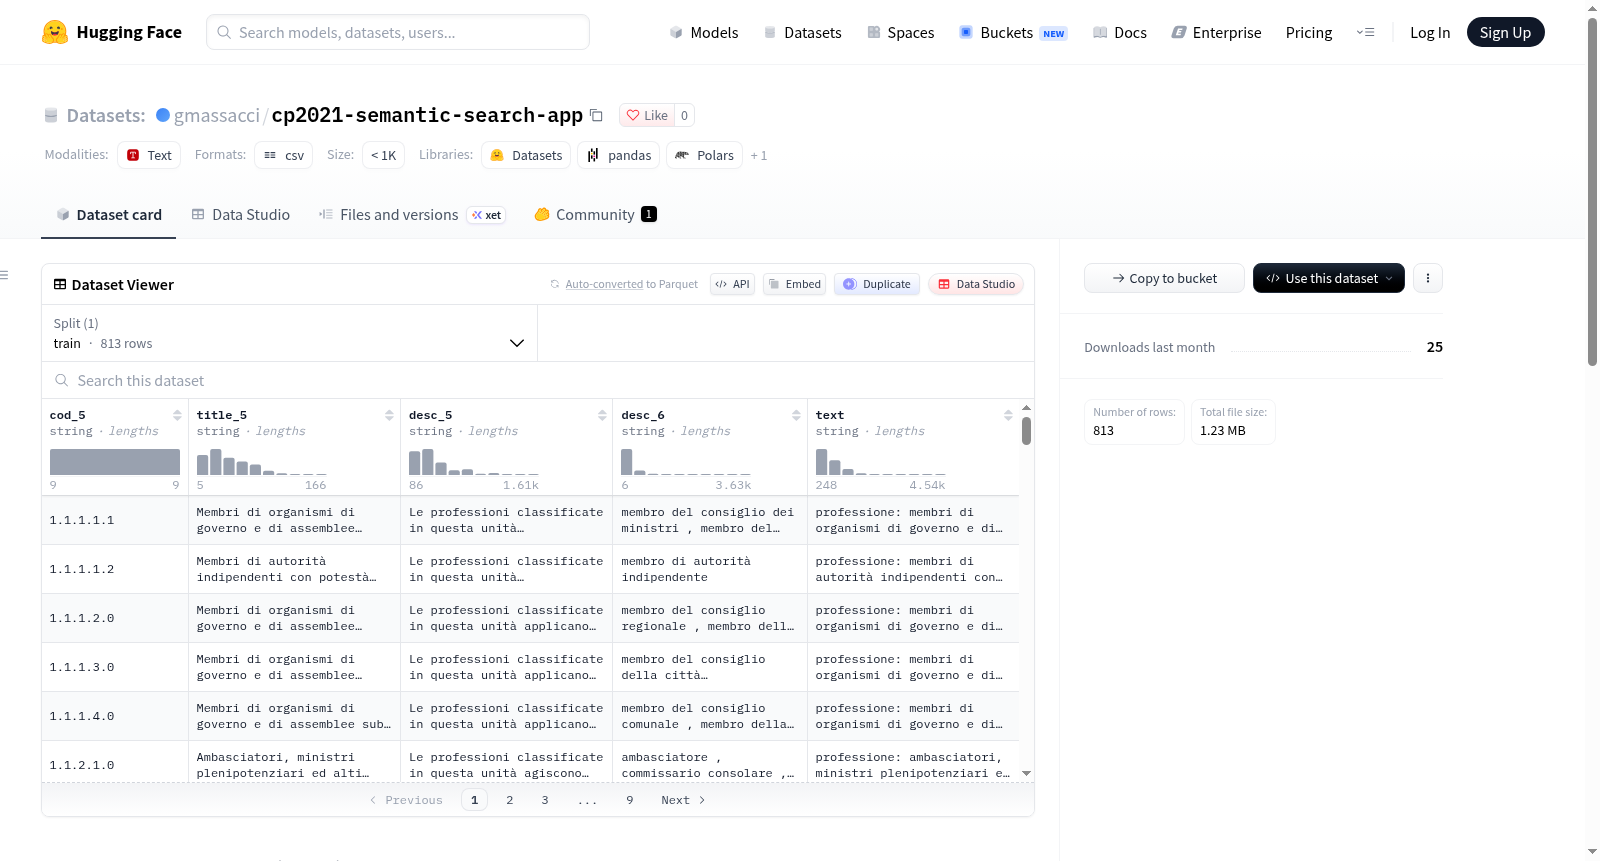
该数据集包含意大利 CP2021 职业分类体系下的 813 个 5 位代码及其对应的描述符文本。每个代码对应一个职业类别,描述符为简短的自然语言文本。该数据集主要用于将自由文本语义映射到最接近的 CP2021 5 位代码,可应用于职业编码、文本分类、语义相似度计算等任务。数据以 CSV 格式存储,每一行包含一个代码和其描述符,无额外标签。数据集由 Codifica semantica CP2021 应用提供,该应用使用 BAAI/bge-m3 模型和余弦相似度实现文本到代码的匹配。
The dataset contains 813 five-digit codes from the Italian CP2021 occupation classification system with their corresponding descriptor texts. Each code represents an occupation category, and the descriptor is a short natural language text. The dataset is primarily used for semantic mapping of free text to the closest CP2021 five-digit code, applicable to tasks such as occupation coding, text classification, and semantic similarity computation. Data is stored in CSV format, each row contains a code and its descriptor, without extra labels. The dataset is provided by the Codifica semantica CP2021 application, which uses the BAAI/bge-m3 model and cosine similarity to achieve text-to-code matching.
Codifica semantica CP2021 (5 digit)
概述
- 应用类型:语义编码应用
- 功能:将自由文本分配最接近的5位CP2021代码
- 核心技术:使用
BAAI/bge-m3模型的嵌入和余弦相似度 - SDK:Gradio
工作原理
data/cp2021_5_6digit_descriptors.csv包含813个5位CP2021描述符- 首次启动时,
app.py计算描述符的嵌入并保存到data/cp2021_embeddings.npy(在CPU上需要几分钟) - 后续启动时,嵌入从文件重新读取:应用仅计算用户输入文本的嵌入,并按余弦相似度对代码排序
- 预计算嵌入的替代方法:运行
python build_knowledge_base.py
本地启动
bash pip install -r requirements.txt python app.py
Space内容
app.py parameters.py build_knowledge_base.py requirements.txt README.md data/cp2021_5_6digit_descriptors.csv
参数配置
- 所有参数(模型、路径、结果数量、界面文本)均在
parameters.py中定义
元数据
- 标题:Codifica semantica CP2021
- 表情符号:🧭
- 颜色渐变:从蓝色到靛蓝
- 固定:否