
lafrancef/ssd-math-v1p1-e06m-fixed-batch-16
收藏官方服务:
资源简介:
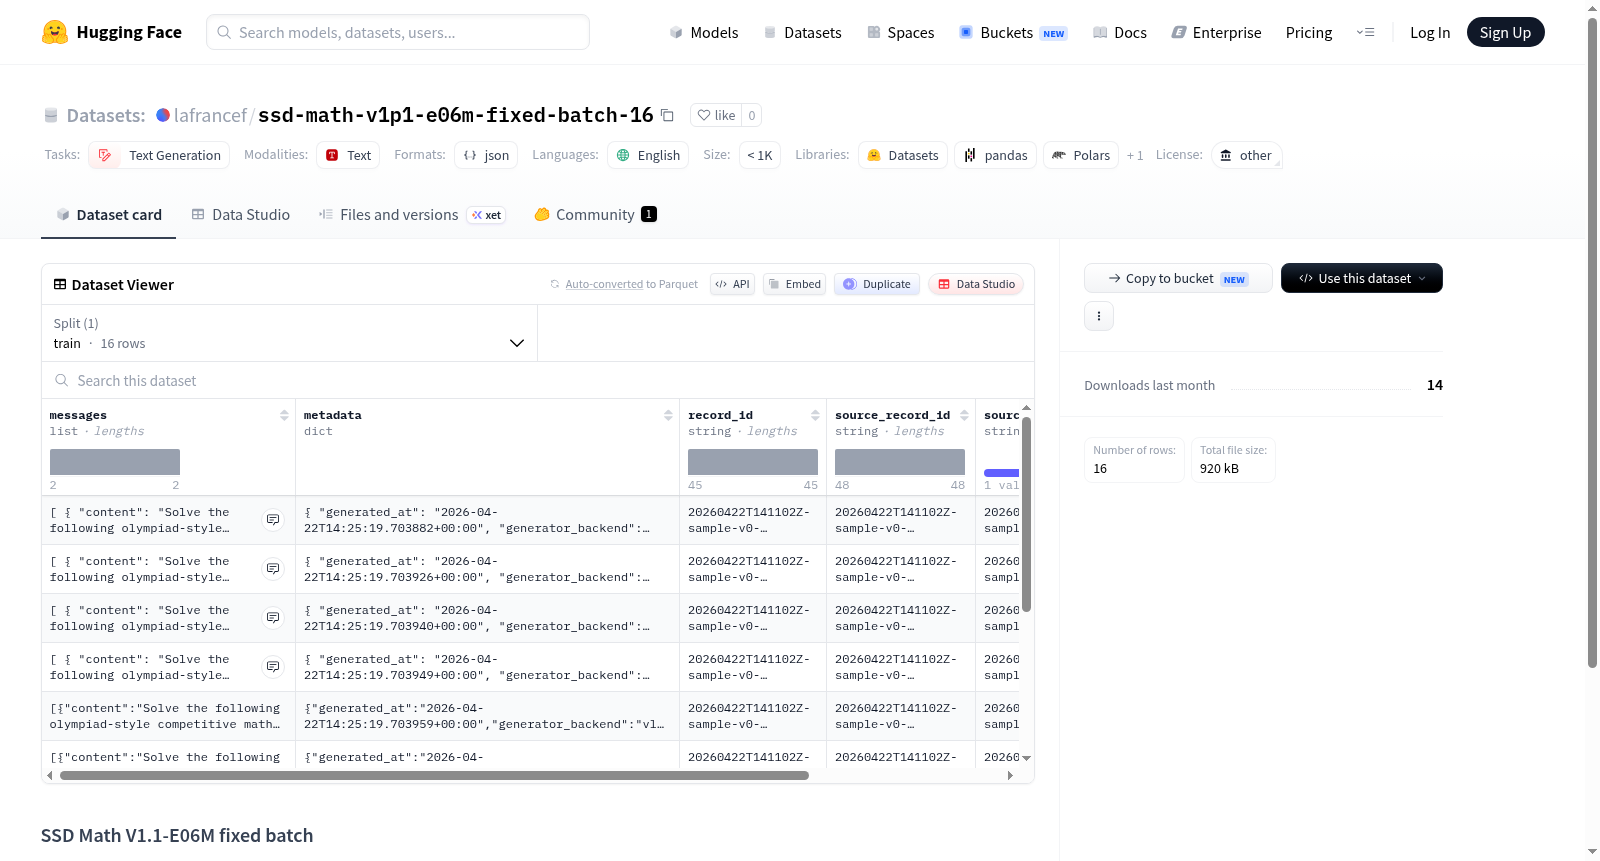
SSD Math V1.1-E06M固定批次数据集是一个包含16条记录的微小SFT JSONL测试集,用于V1.1-E06M 4B模型的单批次学习率诊断。这些记录是从本地v0过拟合测试集`artifacts/overfit/v0_unique_batch_16.jsonl`中生成的数学推理轨迹。
Tiny 16-record SFT JSONL fixture used for the V1.1-E06M 4B single-batch LR diagnostic. The records are generated math-reasoning traces from the local v0 overfit fixture `artifacts/overfit/v0_unique_batch_16.jsonl`.
提供机构:
lafrancef搜集汇总
数据集介绍
构建方式
本数据集名为ssd-math-v1p1-e06m-fixed-batch-16,属于数学推理领域的微调数据(SFT)片段。其构建基于对局部v0过拟合夹具文件`artifacts/overfit/v0_unique_batch_16.jsonl`中记录的数学推理轨迹进行提取与清洗,最终形成包含16条JSONL格式记录的小型数据集,旨在服务于V1.1-E06M 4B单批次学习率诊断实验。
特点
数据集的核心特点在于其高度集约与针对性。仅含16条记录,作为单批次学习率诊断的固定夹具,确保了实验条件的可控性与可重复性。数据来源为模型自生成的高质量数学推理轨迹,天然契合文本生成任务场景,且以英文形式呈现,便于后续直接用于微调或超参数调优。
使用方法
该数据集主要通过HuggingFace的`datasets`库或直接读取JSONL文件的方式加载。用户可将之作为文本生成任务的微调数据,尤其适用于学习率搜索或小规模诊断实验。使用时需注意其批量大小固定为16,且需配合对应基座模型与超参数设置,以保证实验结果的有效性。
背景与挑战
背景概述
在大型语言模型(LLM)的微调与对齐研究中,小规模、高精度的数据集常被用于超参数诊断与训练稳定性验证。ssd-math-v1p1-e06m-fixed-batch-16是一个发布于近期、由研究团队在V1.1-E06M 4B模型单批次学习率诊断实验中构建的微型数据集。该数据集包含16条由本地过拟合固定批次生成的数学推理轨迹,旨在为小批量训练场景下的学习率敏感性测试提供标准化测试夹具。其核心研究问题聚焦于极小数据规模下模型推理能力的保持与超参数调优的有效性,对LLM训练效率优化、过拟合控制及可复现性研究具有重要参考价值。
当前挑战
该数据集所解决的领域挑战在于,大型语言模型在微调阶段常面临训练不稳定、超参数敏感及小样本泛化能力不足等问题。ssd-math-v1p1-e06m-fixed-batch-16通过提供固定批次、低噪声的数学推理样本,使研究者能精确分析学习率对单批次梯度更新效果的影响,从而隔离训练稳定性干扰因素。在构建过程中,主要挑战包括:确保生成的推理轨迹能忠实反映模型原始能力且避免数据泄露;在仅有16条记录的条件下平衡任务的难度与多样性;以及使该固定批次夹具能有效映射到更大规模训练场景的诊断需求,避免小样本引入的偏差误导超参数选择。
常用场景
经典使用场景
在数学推理与自然语言生成领域,ssd-math-v1p1-e06m-fixed-batch-16数据集作为一份精巧的监督式微调(SFT)样本,常被用于语言模型在数学推理任务上的单批次学习率诊断实验。其仅包含16条记录的小规模特性,使其成为验证模型过拟合行为、调试训练管线以及探索超参数敏感性的理想根基性资源。研究者借助这一简洁而高质的数学推理轨迹数据,能够高效甄别模型在极低数据量下的适应能力与记忆倾向。
实际应用
在实际工程应用中,该数据集主要用于语言模型推理能力的快速原型验证与训练流程的稳健性测试。开发团队可借助这16条数学推理样本,在极短时间内完成模型训练管线的冒烟测试,识别学习率设置、优化器选择或批次组织方式中的潜在缺陷。这种轻量级的诊断策略不仅大幅降低了调试周期,还为后续大规模数学推理数据集的训练提供了可靠的先行实验条件,尤为适用于资源受限的研发环境或快速迭代场景。
衍生相关工作
围绕该数据集衍生了若干聚焦于数学推理过拟合诊断与学习率调度策略的经典工作。例如,研究者基于此固定批次数据,系统探究了单批次训练下不同学习率对模型记忆与泛化权衡的影响,进而提出了针对数学推理任务的动态学习率校正方案。此外,在模型鲁棒性评估领域,该数据集被用作基准测试套件,比较了不同正则化技术在极小样本情形下对推理轨迹保真度的保留效果,催生了一批关于小样本训练稳定性的方法论创新与实验范式改进。
以上内容由遇见数据集搜集并总结生成


