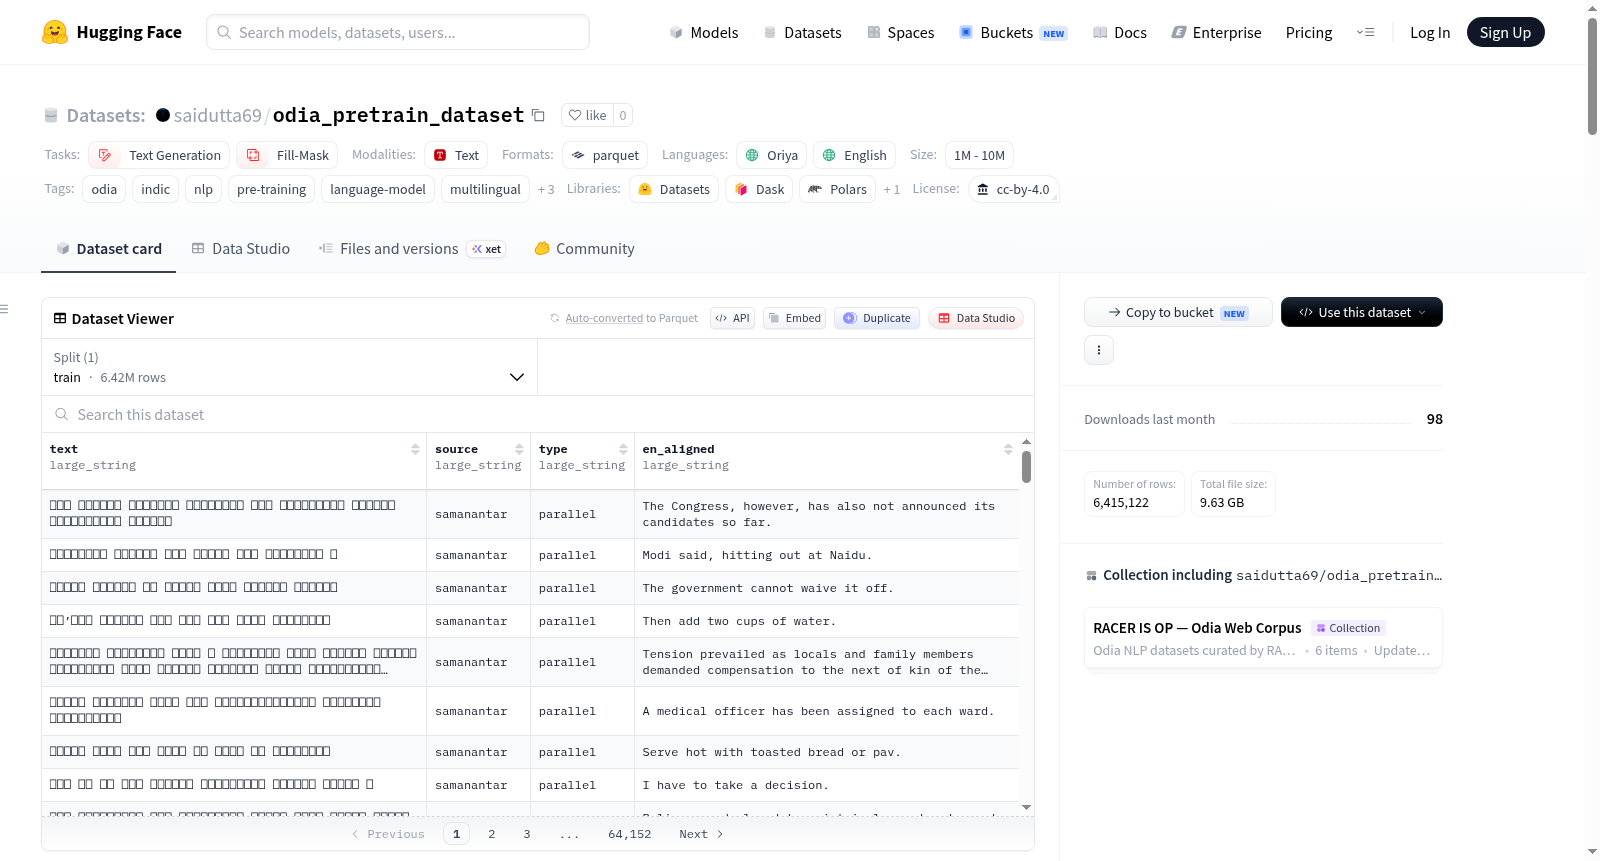
odia_pretrain_dataset
收藏资源简介:
奥里亚语预训练数据集是一个为低资源语言奥里亚语(Odia)构建的大规模、开源文本数据集。该数据集的创建源于对现有奥里亚语数据集访问受限的抗议,作者从零开始,通过整合互联网上所有可公开获取的奥里亚语语料,重建了一个规模更大、更多样化的替代品。数据集总计包含超过975万行文本,汇集了来自25个以上不同来源的数据,包括IndicNLP语料库、网络新闻爬取(Odia Web Corpus v5)、DailyHunt新闻(Varta)、Samanantar平行句对、BigScience XP3多语言数据、Culturax清洗后的网络爬虫、问答数据、指令数据(Alpaca、Dolly、GPTeacher)、维基百科、歌词等多种类型。数据经过严格的质量控制,包括去重(移除超过80万行重复项)、HTML标签清理、短文本过滤等,确保98.5%的样本中奥里亚语内容占比超过50%,整体质量评分为99.5/100。数据集采用CC-BY-4.0许可协议,允许商业和研究使用,旨在为奥里亚语自然语言处理模型的预训练(如文本生成、掩码语言建模)提供无障碍、高质量的资源,以促进该语言在AI领域的发展。
The Odia pretraining dataset is a large-scale, open-source text dataset constructed for the low-resource language Odia. Its creation stems from protests against restricted access to existing Odia datasets, with the authors rebuilding a larger and more diverse alternative from scratch by aggregating all publicly available Odia corpora from the internet. The dataset totals over 9.75 million lines of text, compiled from more than 25 different sources, including IndicNLP corpus, web news crawls (Odia Web Corpus v5), DailyHunt news (Varta), Samanantar parallel sentence pairs, BigScience XP3 multilingual data, Culturax cleaned web crawls, question-answer data, instruction data (Alpaca, Dolly, GPTeacher), Wikipedia, lyrics, and other types. The data undergoes rigorous quality control, including deduplication (removing over 800,000 duplicate lines), HTML tag cleaning, short text filtering, etc., ensuring that over 98.5% of samples contain more than 50% Odia content, with an overall quality score of 99.5/100. The dataset is licensed under CC-BY-4.0, permitting commercial and research use, and aims to provide accessible, high-quality resources for pretraining Odia natural language processing models (e.g., text generation, masked language modeling) to promote the languages development in the AI field.
数据集概览
- 数据集名称:Odia Pre-training Dataset
- 全称:Odia Pre-training Dataset (The One That Didnt Need Gating)
- 语言:奥里亚语(or)、英语(en)
- 许可证:CC-BY-4.0(可商用)
- 数据量:9,755,460 行
- 数据来源:超过 25 个独立来源
- 主要标签:odia、indic、nlp、pre-training、language-model、multilingual、cc-by-4.0、open-access、no-gating-required
- 任务类别:text-generation(文本生成)、fill-mask(掩码填充)
- 存储库:datasets 库
数据来源与构成
| 数据来源 | 行数 | 说明 |
|---|---|---|
| indic_nlp_corp | 3,122,796 | IndicNLP 语料库(主干部分) |
| odia_web_corpus_v5 | 3,340,338 | 自采网络数据(新闻、指令等) |
| varta | 1,014,936 | DailyHunt 奥里亚新闻文章 |
| samanantar | 992,064 | 奥里亚-英语平行句对 |
| xp3 | 486,529 | BigScience 多语言平行数据 |
| culturax | 150,318 | 清洗后的网络爬取数据 |
| odia_qa | 84,920 | 奥里亚问答数据 |
| oscar_odia | 50,092 | OSCAR 奥里语子集 |
| alpaca_odia | 49,076 | 奥里亚指令数据 |
| eng_to_odia | 20,828 | 翻译对 |
| wikipedia | 17,210 | 奥里亚维基百科 |
| dolly_odia | 14,959 | 奥里亚 Dolly 数据 |
| gpt_teacher | 18,184 | GPTeacher 奥里亚数据 |
| odia_news | 5,993 | Common Crawl 新闻 |
| odia_lyrics | 156 | 奥里亚歌词 |
| 其他 10 个来源 | 约 100,000 | 社区贡献 |
数据质量
- 空文本:0 行
- 奥里亚内容占比均值:80.6%
- 奥里亚占比 >50% 的行:98.5%
- 重复数据去除:去除 805,532 行
- HTML 标签清理:已完成
- 短文本过滤(<15 字符):已完成
- 质量评分:99.5/100
数据模式
| 字段 | 类型 | 描述 |
|---|---|---|
| text | string | 奥里亚文本内容 |
| source | string | 数据来源标识 |
| type | string | 数据类型:单语、平行、指令、问答等 |
| en_aligned | string | 英文翻译(仅平行数据存在) |
快速使用示例
python from datasets import load_dataset
直接加载,无需申请访问权限
dataset = load_dataset("saidutta69/odia_pretrain_dataset", split="train")
按来源过滤
news = dataset.filter(lambda x: x["source"] in ("varta", "odia_web_corpus_v5")) instructions = dataset.filter(lambda x: x["type"] == "instruction") parallel = dataset.filter(lambda x: x["source"] == "samanantar")
按来源统计数量
from collections import Counter sources = Counter(x["source"] for x in dataset) for src, count in sources.most_common(): print(f"{src}: {count:,}")
未收录的受限数据集
以下数据集已申请访问但仍未开放,后续可能合并:
| 数据集 | 行数 | 状态 |
|---|---|---|
| oscar-corpus/OSCAR-2301 | 48,780 | 已申请,等待中 |
| OdiaGenAIdata/pre_train_odia_data_processed | 5,980,000 | 已申请,仍在等待 |
引用信息
bibtex @misc{odia_pretrain_dataset, author = {Saidutta Abhishek Dash}, title = {Odia Pre-training Dataset: What Happens When You Gate a Low-Resource Language}, year = {2025}, publisher = {Hugging Face}, note = {9.75M rows of Odia text, rebuilt from scratch because access requests went unanswered}, howpublished = {url{https://huggingface.co/datasets/saidutta69/odia_pretrain_dataset}}, }