
遇见数据集

MLRS/maltese_news_headlines

收藏
Hugging Face2024-02-28 更新2024-03-04 收录
官方服务:

资源简介:

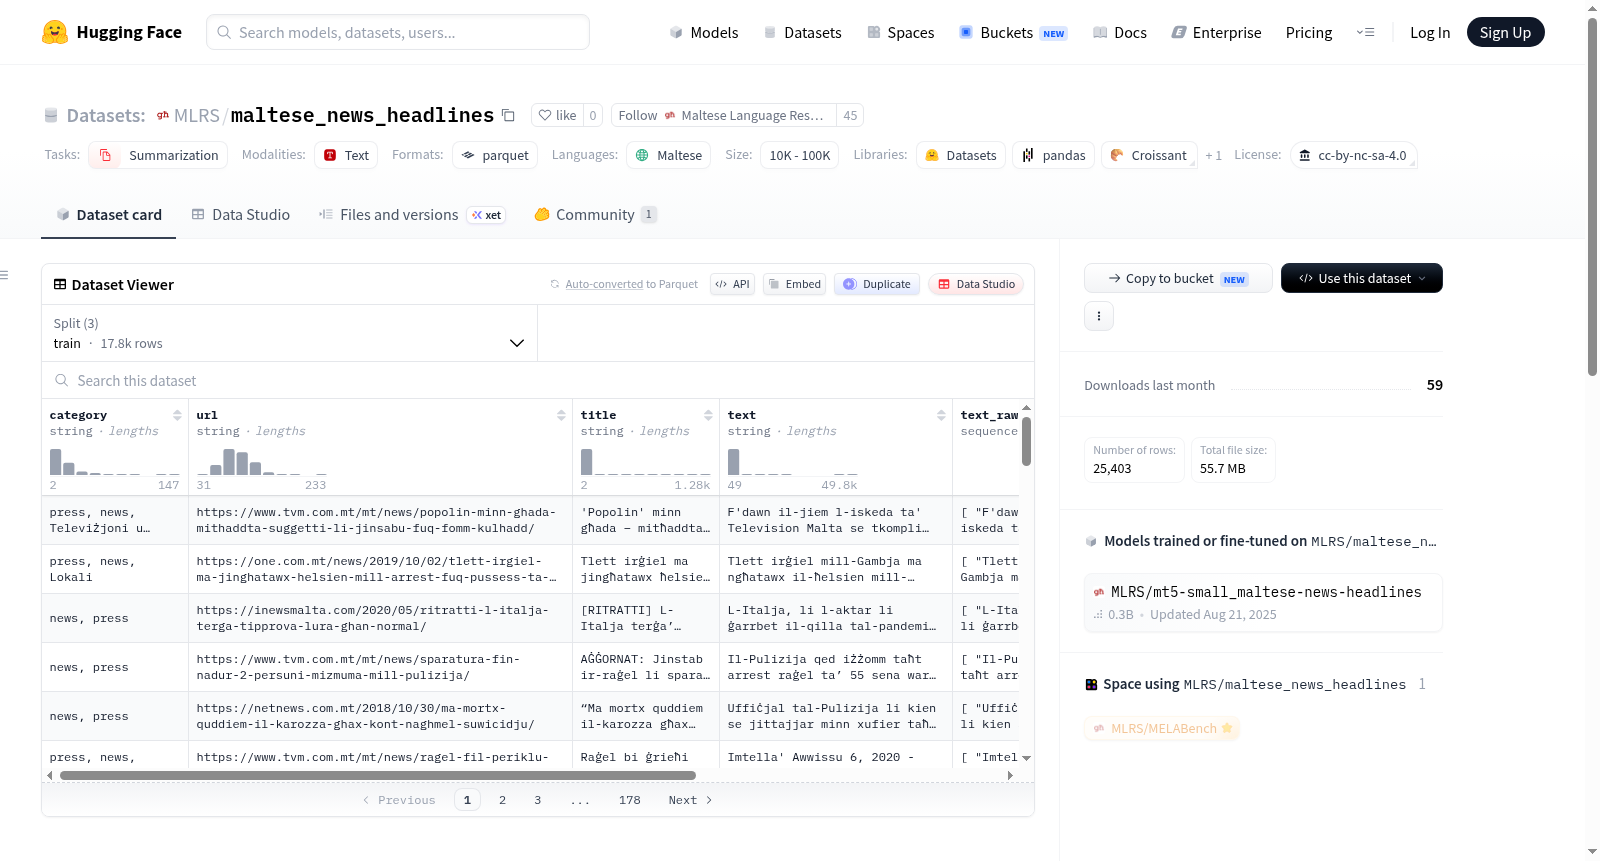
Maltese News Headlines数据集包含马耳他新闻文章的标题和文章内容对,主要用于从文章内容生成标题。数据来源于Korpus Malti v4.0的press_mt子集,并经过清理以过滤掉JavaScript、CSS和重复的非马耳他子标题。数据集的特征包括类别、URL、标题、文本、原始文本序列、基础URL和索引级别。数据集分为训练集、验证集和测试集,分别包含17782、3810和3811个样本。数据集的许可证为CC BY-NC-SA 4.0,适用于非商业用途。

The Maltese News Headlines dataset consists of title and full article content pairs of Maltese news articles, primarily intended for generating headlines from article content. The data is sourced from the press_mt subset of Korpus Malti v4.0, and has been cleaned to filter out JavaScript, CSS, and duplicate non-Maltese subheadings. The dataset features include category, URL, headline, text, raw text sequence, base URL, and index level. The dataset is split into training, validation, and test sets, containing 17782, 3810, and 3811 samples respectively. The dataset is licensed under CC BY-NC-SA 4.0 for non-commercial use.

提供机构:
MLRS
原始信息汇总

Maltese News Headlines 数据集概述

数据集信息

特征

  • category: 类型为字符串。
  • url: 类型为字符串。
  • title: 类型为字符串。
  • text: 类型为字符串。
  • text_raw: 序列类型为字符串。
  • base_url: 类型为类别标签,包含以下名称:
    • 0: inewsmalta.com
    • 1: netnews.com.mt
    • 2: newsbook.com.mt
    • 3: one.com.mt
    • 4: stradarjali.com
    • 5: www.gwida.mt
    • 6: www.illum.com.mt
    • 7: www.tvm.com.mt
  • index_level_0: 类型为 int64。

数据分割

  • train: 包含 17782 个样本,总字节数为 63559985.55997323。
  • validation: 包含 3810 个样本,总字节数为 13618465.019879542。
  • test: 包含 3811 个样本,总字节数为 13622039.420147227。

数据大小

  • 下载大小: 55694312 字节。
  • 数据集大小: 90800490 字节。

配置

  • default: 数据文件路径如下:
    • train: data/train-*
    • validation: data/validation-*
    • test: data/test-*

许可证

  • cc-by-nc-sa-4.0: 该数据集遵循 Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International License。

任务类别

  • summarization: 用于标题生成任务。

语言

  • mt: 马耳他语。

数据集名称

  • Maltese News Headlines: 马耳他新闻标题数据集。

数据集规模

  • 10K<n<100K: 数据集规模在 10,000 到 100,000 个样本之间。
搜集汇总
数据集介绍
MLRS/maltese_news_headlines 数据集图片
构建方式
马耳他语新闻标题数据集源自Korpus Malti v4.0语料库中的新闻子集,通过系统化清洗流程构建而成。原始数据经过严格过滤,移除了JavaScript、CSS代码以及重复的非马耳他语副标题,确保文本纯净度。数据集保留了原始语料中的标题与URL字段,形成标题与文章正文的配对结构。最终整合为训练集、验证集和测试集三部分,分别包含17782、3810和3811个样本,涵盖来自八个马耳他新闻网站的多元内容。
特点
该数据集专为马耳他语新闻标题生成任务设计,具有鲜明的语言与领域特色。每条样本包含类别标签、原始URL、标题、清洗后正文及原始文本序列,形成多维度信息结构。数据来源覆盖马耳他主流新闻平台,如inewsmalta.com、tvm.com.mt等,确保了语料的多样性与代表性。数据集规模介于1万至10万条之间,在低资源语言自然语言处理领域具有重要价值,为马耳他语的摘要生成研究提供了稀缺的标注资源。
使用方法
数据集通过HuggingFace Datasets库可直接加载使用,支持默认配置下的训练、验证和测试分片。使用者可通过指定split参数访问不同子集,数据格式为标准字典结构,包含category、url、title、text等字段。该数据集适用于序列到序列的标题生成任务,可将文章正文作为输入,标题作为目标输出。建议在加载时利用Datasets库的数据转换功能进行预处理,如分词或构建词汇表,以适应下游模型训练需求。
背景与挑战
背景概述
马耳他语作为欧盟的官方语言之一,其自然语言处理资源长期处于匮乏状态,尤其在新闻文本的自动摘要与标题生成领域,缺乏大规模、高质量的标注数据集。为填补这一空白,马耳他语言资源服务(MLRS)团队于2024年发布了Maltese News Headlines数据集,该数据集由Amit Kumar Chaudhary、Kurt Micallef与Claudia Borg等研究人员联合构建,核心研究问题聚焦于马耳他语新闻文章的标题自动生成任务。数据集源自Korpus Malti v4.0语料库中的新闻子集,经过细致的清洗与过滤,最终收录了超过25,000篇带有标题与正文的新闻样本,涵盖八个本地新闻源。该数据集的问世为低资源语言的自然语言处理研究提供了重要基准,推动了马耳他语在文本生成与分类任务上的发展。
当前挑战
该数据集所面对的领域挑战主要体现在马耳他语作为低资源语言的固有困难:缺乏大规模预训练模型与成熟的自然语言处理工具,导致标题生成任务需从零构建,且马耳他语丰富的形态变化与有限的标注数据使得模型泛化能力受限。在构建过程中,团队面临多重挑战:原始语料中混杂有大量JavaScript、CSS代码及非马耳他语的重复子标题,需设计复杂的清洗流程以确保数据质量;此外,从八个不同新闻源采集的数据在格式、标题风格与内容长度上存在显著差异,增加了数据标准化的难度。同时,数据集仅包含约25,000个样本,规模较小,可能不足以支撑深度神经网络的充分训练,且采用了非商业性共享许可,限制了其在商业场景下的广泛应用。
常用场景
经典使用场景
马耳他语新闻标题数据集(MLRS/maltese_news_headlines)的核心应用场景在于新闻摘要生成任务,即从给定的新闻正文内容自动生成准确、凝练的标题。该数据集精心收集了来自马耳他多个主流新闻源的文章与标题配对,涵盖了丰富多样的主题类别,为低资源语言马耳他语的序列到序列模型训练提供了宝贵的基础资源。研究者可借助该数据集微调预训练语言模型,探索在数据稀缺条件下如何有效捕捉新闻文本的核心语义,并生成符合新闻语体规范的标题,从而推动低资源语言自然语言生成技术的发展。
实际应用
在实际应用层面,该数据集可直接赋能马耳他语新闻媒体的内容生产流程,例如辅助编辑人员快速生成新闻标题、优化搜索引擎中的摘要展示,以及提升新闻聚合平台的信息呈现效率。此外,基于该数据集训练的模型还能应用于社交媒体内容摘要、多语言新闻监控系统,乃至教育领域的马耳他语写作辅助工具,显著降低人工摘要成本,加速信息传播与知识获取。其非商业性许可协议也为学术研究与文化保护类项目提供了便利。
衍生相关工作
围绕该数据集已催生出一系列经典学术工作,其中最具代表性的是其原始论文中提出的标题生成与主题分类联合任务框架,该工作首次在公开的马耳他语新闻语料上验证了多任务学习的有效性。后续研究可进一步衍生出针对低资源语言的预训练策略优化、跨领域标题生成泛化能力分析,以及结合对抗训练提升生成文本多样性等方向。这些工作共同构筑了马耳他语自然语言处理领域的基石,也激发了更多针对其他低资源语言的类似数据集构建与模型创新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

