
Feudor2/disagreed_merged
收藏官方服务:
资源简介:
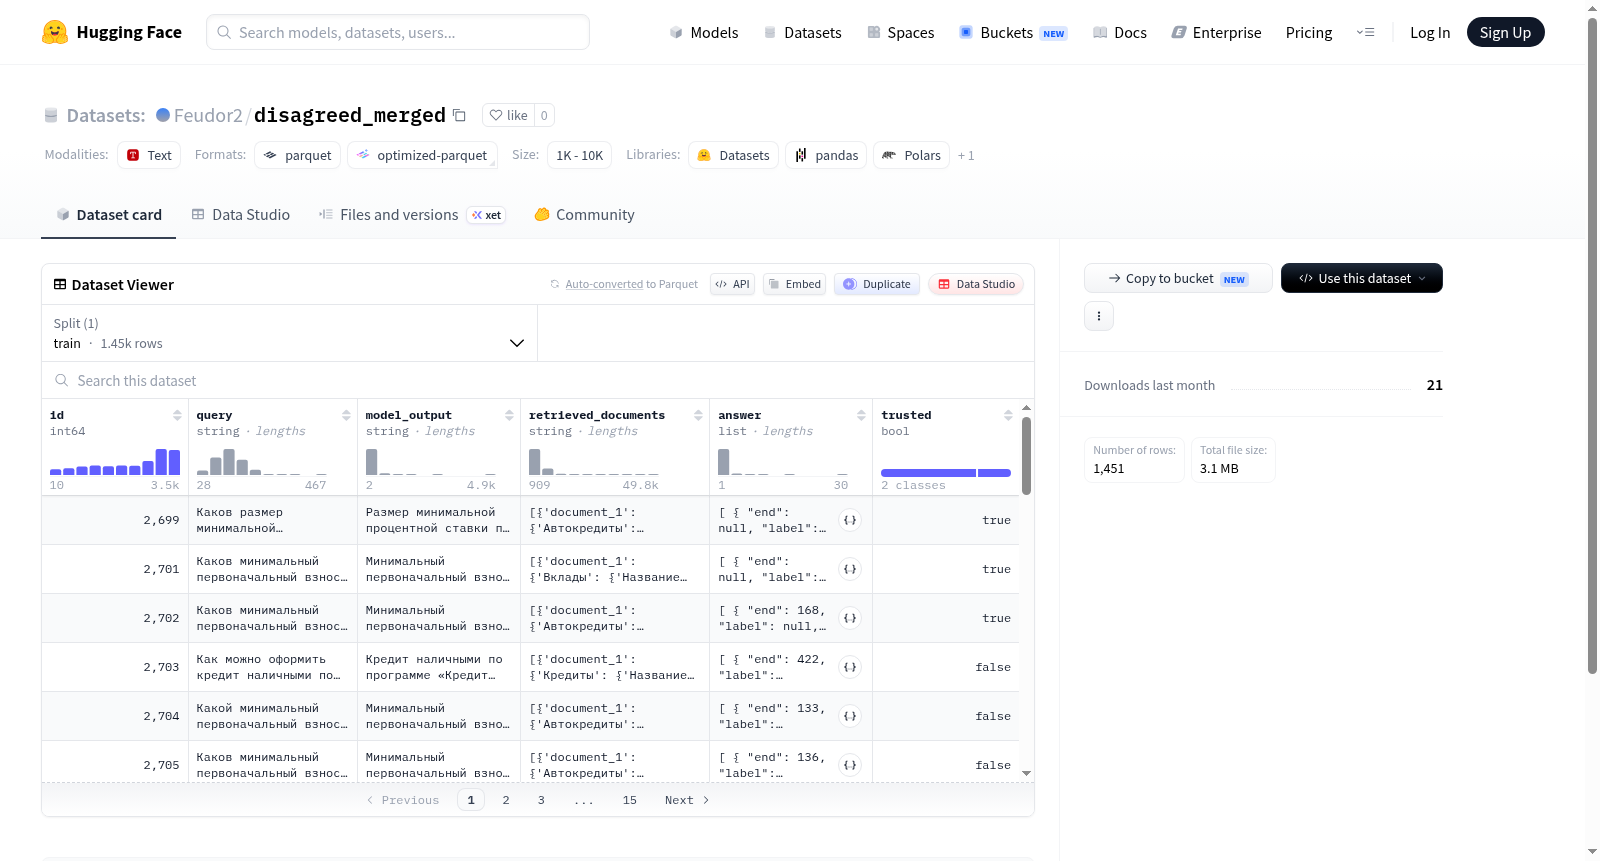
该数据集包含用于评估检索增强生成(RAG)系统的数据,主要结构包括:id(唯一标识符)、query(用户查询)、model_output(模型生成的回答)、retrieved_documents(检索到的相关文档)、answer(标注的答案信息,含起止位置、标签、文本等子字段)和trusted(可信度标记)。数据集仅包含训练集,共1451个样本,适用于问答任务和模型性能分析。
This dataset contains data for evaluating Retrieval-Augmented Generation (RAG) systems, with key features including: id (unique identifier), query (user query), model_output (model-generated response), retrieved_documents (retrieved relevant documents), answer (annotated answer information with subfields like start/end positions, labels, text), and trusted (trustworthiness indicator). It includes only a training split with 1451 examples, suitable for question-answering tasks and model performance analysis.
提供机构:
Feudor2搜集汇总
数据集介绍
构建方式
该数据集名为disagreed_merged,聚焦于检索增强生成(RAG)领域中的分歧样本。其构建基于对模型输出与检索文档之间不一致性的捕捉,通过整合查询(query)、模型输出(model_output)及检索文档(retrieved_documents)等字段,将存在标签争议或内容矛盾的实例进行归并。数据集中每条样本包含详细的答案标注(answer),以起始位置(start)和结束位置(end)定位文本片段,并附有多标签(labels)体系,从而系统性地构建起一个用于训练或评估模型在分歧情境下决策能力的结构化数据集。
特点
该数据集的核心特点在于其专门聚焦于“分歧”场景,即模型输出与检索文档中答案存在不一致或冲突的样本。每个实例均包含明确的信任标记(trusted)字段,用于指示该样本是否被验证为可靠。此外,答案字段采用嵌套结构,支持多标签分类与精准文本定位,为细粒度的分歧分析提供了丰富维度。数据集共包含1451条训练样本,规模适中但针对性极强,适合用于研究模型在信息矛盾时的鲁棒性与校准能力。
使用方法
该数据集的使用可直接通过HuggingFace的datasets库加载,指定配置名为default并读取训练集(train)分片即可。研究者可将查询、模型输出与检索文档作为输入特征,利用答案中的标签(label)与多标签(labels)信息进行分歧分类训练或评估。由于数据集中已包含定位信息(start与end),也可用于序列标注或片段抽取任务。建议在应用时结合trusted字段筛选高置信度样本,以优化模型在争议性场景下的表现分析。
背景与挑战
背景概述
在信息检索与问答系统迅猛发展的当下,如何有效评估模型生成答案的可靠性成为关键课题。disagreed_merged数据集应运而生,由某研究机构于近期构建,其核心聚焦于模型输出与检索文档间存在分歧的复杂场景。该数据集包含1451条高质量训练样本,每条数据均涵盖用户查询、模型输出、检索文档及人工标注的多候选答案,并附带可信度标记。通过捕捉模型预测与证据间的不一致性,该数据集为研究歧义处理、证据融合及生成可信答案提供了独特视角,显著推动了可解释和鲁棒的问答系统评估范式的发展。
当前挑战
该数据集所应对的领域挑战在于,现有问答系统常忽视模型输出与检索结果间的语义矛盾,导致看似准确实则谬误的答案生成。具体挑战包括:1)多候选答案中标签的冲突性与细粒度歧义消解;2)模型输出与检索文档存在实质性分歧时,如何设计评估指标以量化可信度;3)在构建过程中,人工标注者需对53%的样本进行争议性判断,标注一致性难以保证;4)数据规模有限(仅1451例),难以覆盖长尾分歧模式,对模型泛化能力构成严峻考验。
常用场景
经典使用场景
在自然语言处理与信息检索的交叉领域中,disagreed_merged数据集以其独特的标注结构脱颖而出,成为评估问答系统鲁棒性与可信度的经典资源。该数据集汇聚了用户查询、模型输出、检索文档以及多标注者提供的答案片段,尤其注重标注分歧的融合处理,使得研究者能够深入探究模型在面对真实世界不确定性时的表现。常用的场景包括训练和测试开放域问答模型,特别是那些需要从多源文档中抽取精确答案的系统,通过disagreed_merged可以模拟用户对同一问题产生不同回答偏好的复杂情形,从而推动模型从单一正确答案向多元合理答案的认知演进。
衍生相关工作
围绕disagreed_merged数据集已衍生出多项标志性研究工作,推动了可信AI领域的蓬勃发展。部分工作聚焦于分歧感知的排序算法,通过引入标注不一致的样本作为负反馈信号,优化检索模型的排序质量;另一系列研究则致力于开发能够主动识别并利用标注分歧的神经架构,例如设计独立的置信度估计分支与多标签解码器。还有学者基于该数据集提出了“分歧蒸馏”的概念,利用多个不完美教师的异质性知识来增强学生模型的泛化能力。这些工作不仅验证了数据集在评估模型可信度方面的有效性,更启发了一系列关于如何从人类分歧中提取结构化知识的理论探索,持续影响着评估体系的演进方向。
数据集最近研究
最新研究方向
在自然语言处理与信息检索的交叉领域,围绕模型输出可靠性与检索增强生成(RAG)技术的结合成为前沿热点。数据集‘disagreed_merged’聚焦于模型生成答案与检索文档间的潜在分歧,为研究基于证据的文本生成与事实一致性验证提供了关键资源。近期研究借助该数据集中标注的分歧点,深入探索如何通过检索文档中的标签化信息(如‘trusted’字段)来优化模型对不确定答案的修正策略,推动了大语言模型在知识密集型任务中的可信度评估与争议消解机制的发展,对提升智能问答系统的鲁棒性和透明性具有显著意义。
以上内容由遇见数据集搜集并总结生成


