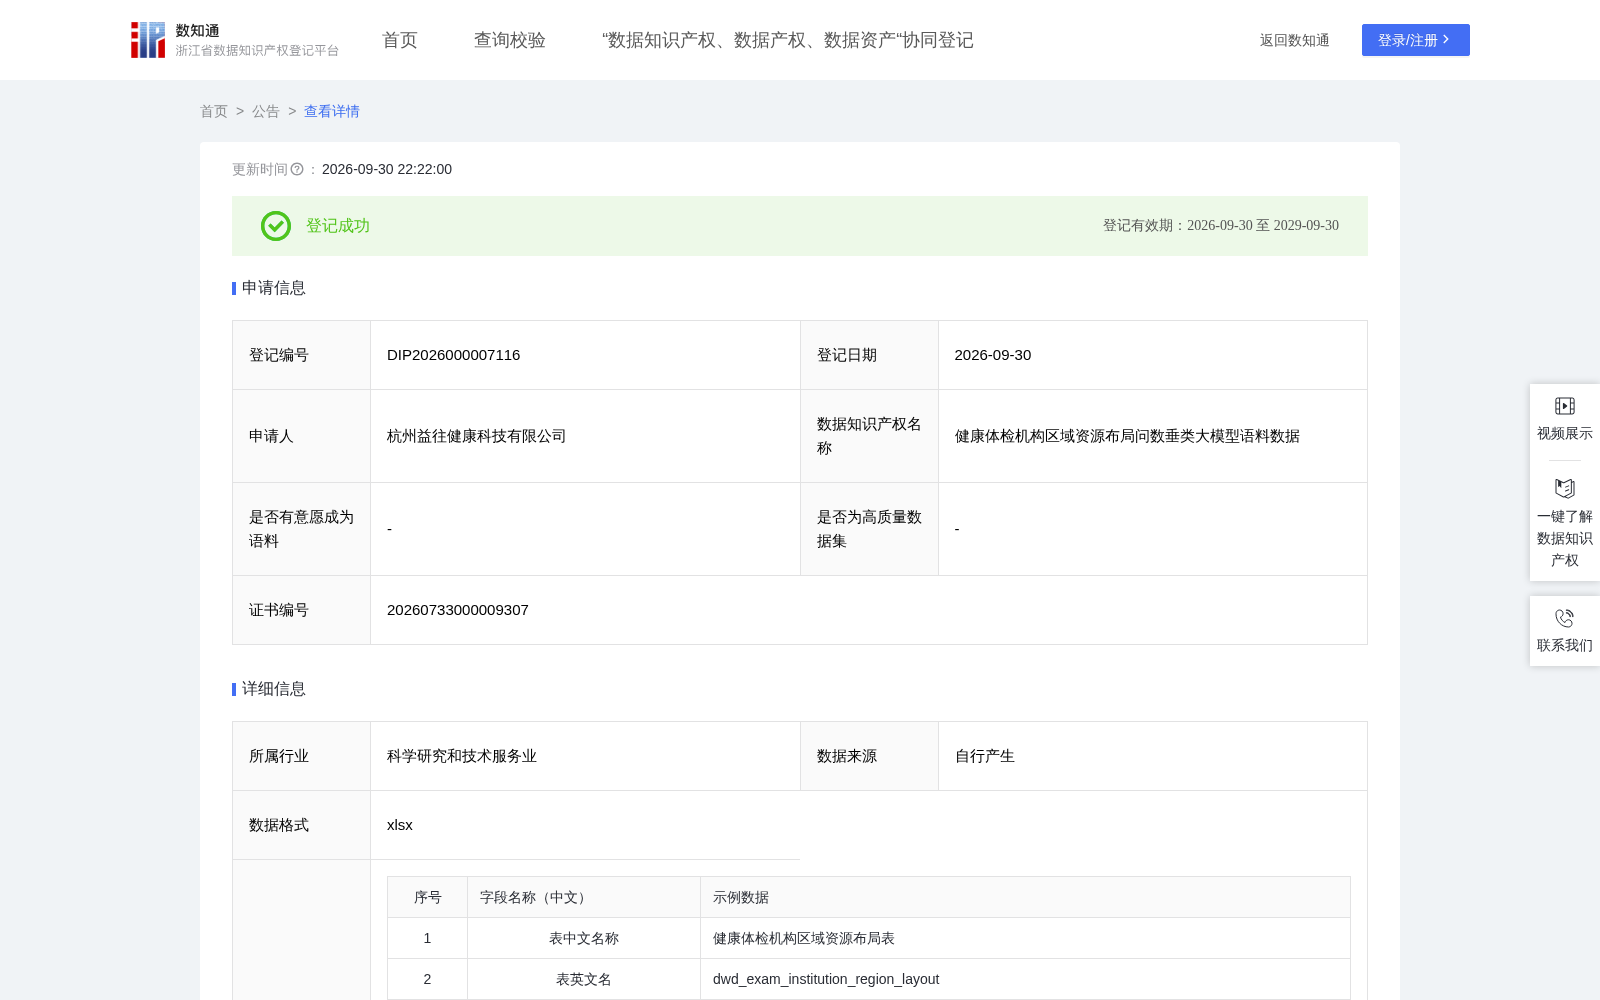
健康体检机构区域资源布局问数垂类大模型语料数据
收藏资源简介:
该数据可用于训练健康体检机构区域资源布局问数垂类大语言模型,使其能够深度理解体检平台在机构覆盖、区域资源配置、公共体检开放、提醒服务、发票服务和套餐供给方向的自然语言问题,并准确转化为对应的SQL查询语句,从而实现体检机构资源布局的高效查询与分析。依托 `dwd_exam_institution_region_layout` 表中的 `institution_code`、`institution_name`、`province_code`、`city_code`、`district_code`、`institution_type`、`public_exam_open`、`reminder_enabled`、`invoice_supported`、`package_count`、`active_package_count`、`order_count` 等字段,模型经训练后可精准理解“某城市不同区县有多少体检机构”“哪些机构类型套餐供给不足”“公共体检开放机构的预约承载如何”“哪些区域需要补充合作机构”等体检资源布局问题。体检平台、医院合作部门和区域运营团队可基于本语料数据快速适配机构资源1.数据整理:采用机构主数据清洗、区域编码标准化和资源指标补齐机制提升数据质量,去除删除标志记录、重复机构记录和机构编码缺失记录,统一省市区编码、机构类型、公共体检开放状态、短信提醒状态和发票支持状态。 2.问题收集与分类:从体检机构管理、区域运营、医院合作和公共体检资源盘点场景中整理常见问数问题,按照区域机构布局、机构类型资源、公共体检开放覆盖、发票提醒服务、套餐资源覆盖、低供给区域识别和高需求区域识别等类别组织语料,确保问题覆盖机构资源治理的核心业务场景。 3.核心算法建模:构建“语义解析-查询生成-异常检测-逻辑验证”全流程算法体系。 (1)语义解析与结构化:对自然语言问题进行分块和槽位抽取,将“城市编码”“区县编码”“机构类型”“公共体检开放”“短信提醒”“发票支持”“套餐数量”“历史预约订单数”等表达映射到标准字段,识别分组、排序、TOP N和阈值筛选条件。 (2)SQL生成与初步验证:基于 `dwd_exam_institution_region_layout` 表模型,将机构数量使用 `COUNT(DISTINCT institution_code)` 聚合,套餐数量、启用套餐数量、历史预约订单数量使用 `SUM` 聚合,支付率类指标使用支付数与订单数计算。系统校验SQL中字段必须存在于建表语句,查询必须显式选择字段并使用只读SELECT语句。 (3)异常值检测:检测机构数、套餐数、启用套餐数、订单数是否出现负值或逻辑倒挂,检测分母为0时的比例计算风险,检测区域编码缺失、机构类型为空、启用套餐数大于套餐总数等异常语料,并对异常样本进行过滤或标记。 (4)逻辑核验与优化:由体检运营人员核验问题-SQL-结果三元组是否符合机构资源布局业务口径,重点检查“区域、机构类型、套餐供给、预约承载”之间的逻辑关系,确保查询结果可直接用于机构拓展和资源复盘。 4.语料库迭代优化:根据模型在区域资源问数中的错误反馈,持续补充低供给区县、公共体检未开放机构、套餐供给不足机构和高订单承载机构等样本,形成“应用-反馈-修正-复核”的语料更新闭环。该算法规则确保本语料数据具备机构资源分析的专业性、准确性和可复用性,为健康体检机构区域资源布局问数模型训练提供高质量支撑。