yapay_zeka_turkce_mmlu_bolum_sonuclari
收藏资源简介:
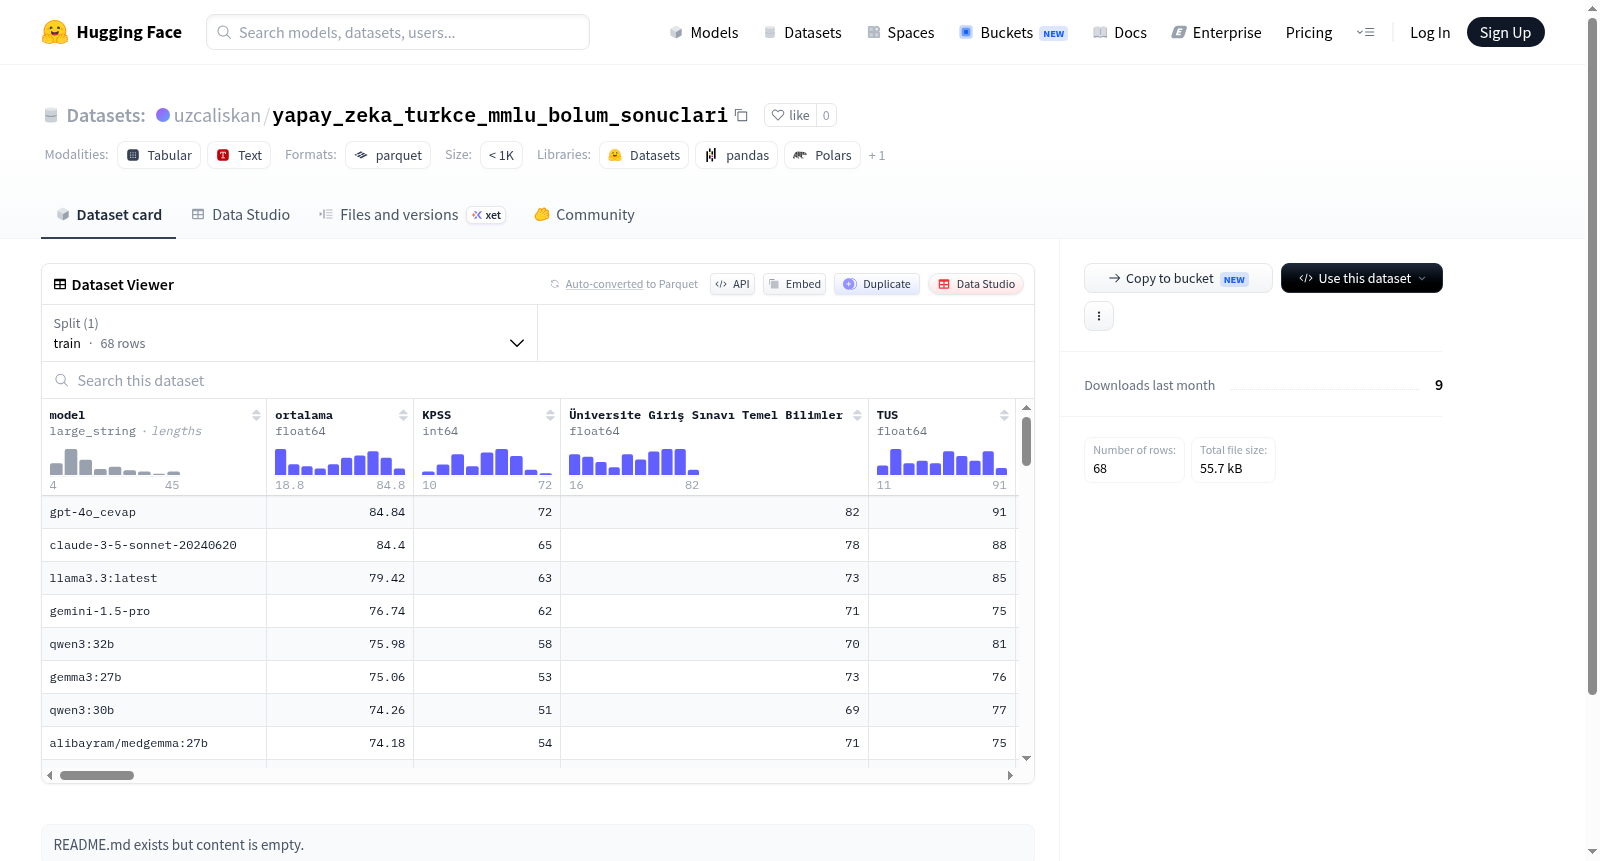
该数据集包含68个样本,每个样本由一个model字段(字符串类型,可能表示模型名称或标识符)和55个以土耳其语命名的数值字段组成。这些数值字段涵盖了广泛的土耳其教育、考试和职业领域,主要包括:1) 标准化考试(如KPSS公务员考试、TUS医学专科考试、大学入学基础科学考试、驾照考试);2) 学科领域(如哲学、历史、土耳其语言文学、宗教知识、社会学、经济学);3) 职业与专业领域(如烹饪、媒体与传播、物流、会计与税务、农业、旅游与酒店管理、老年护理、儿童发展、人力资源管理、企业管理等)。数据集形式为结构化表格,适用于多任务评估、教育数据分析或跨领域模型性能比较等场景,特别关注土耳其语语境下的知识与应用领域。
This dataset contains 68 samples, each consisting of a model field (string type, possibly representing a model name or identifier) and 55 numerical fields named in Turkish. These numerical fields cover a wide range of Turkish education, examination, and professional domains, including: 1) Standardized exams (such as KPSS civil service exam, TUS medical specialty exam, university entrance basic science exam, drivers license exam); 2) Academic disciplines (such as philosophy, history, Turkish language and literature, religious knowledge, sociology, economics); 3) Vocational and professional fields (such as cooking, media and communication, logistics, accounting and taxation, agriculture, tourism and hospitality, elderly care, child development, human resources management, business administration, etc.). The dataset is in structured tabular format and is suitable for multi-task evaluation, educational data analysis, or cross-domain model performance comparison, with a particular focus on knowledge and application contexts in Turkish.
- 数据集名称: yapay_zeka_turkce_mmlu_bolum_sonuclari
- 数据集来源: Hugging Face,地址为 https://huggingface.co/datasets/uzcaliskan/yapay_zeka_turkce_mmlu_bolum_sonuclari
- 数据集描述: 该数据集包含多个土耳其语考试或领域(如KPSS、TUS、历史、哲学等)中不同模型的平均表现结果。
- 主要特征:
- model: 模型名称(字符串类型)
- ortalama: 平均分(浮点数)
- KPSS: 整数型分数
- Üniversite Giriş Sınavı Temel Bilimler: 大学入学考试基础科学分数(浮点数)
- TUS: 医学专业入学考试分数(浮点数)
- Futbol: 足球知识分数(整数)
- Kim 500 Milyar İster: 电视问答节目分数(整数)
- Ehliyet Sınavı: 驾照考试分数(整数)
- KPSS Denemeleri: KPSS模拟考试分数(整数)
- Felsefe: 哲学分数(整数)
- Tarih: 历史分数(浮点数)
- Türk Dili ve Edebiyatı: 土耳其语语言文学分数(浮点数)
- Dini Bilgiler: 宗教知识分数(整数)
- Adalet: 司法领域分数(整数)
- Sağlık Yönetimi: 健康管理分数(浮点数)
- İlahiyat: 神学分数(浮点数)
- Siyer: 伊斯兰先知传记分数(浮点数)
- Aşçılık: 烹饪分数(整数)
- Medya ve İletişim: 媒体与传播分数(整数)
- AUZEF: 安纳托利亚大学开放教育学院相关分数(整数)
- Acild Durum ve Afet Yönetimi: 紧急情况与灾害管理分数(整数)
- Bankacılık ve Sigortacılık: 银行与保险分数(整数)
- Büro Yönetimi ve Yönetici Asistanlığı: 办公室管理与行政助理分数(整数)
- DHBT: 宗教知识考试分数(整数)
- Dış Ticaret: 对外贸易分数(整数)
- Elektrik Enerjisi Üretim,İletim ve Dağıtımı: 电能生产、传输与分配分数(整数)
- Emlak ve Emlak Yönetimi: 房地产与物业管理分数(整数)
- Ev İdaresi: 家政管理分数(整数)
- Fotoğrafçılık ve Kameramanlık: 摄影与摄像分数(整数)
- Halkla İlişkiler ve Reklamcılık: 公共关系与广告分数(整数)
- Halkla İlişkiler ve Tanıtım: 公共关系与推广分数(整数)
- Havacılık Yönetimi: 航空管理分数(整数)
- Kamu Yönetimi: 公共管理分数(整数)
- Kültürel Miras ve Turizm: 文化遗产与旅游分数(整数)
- Laborant ve Veteriner Sağlık: 实验员与兽医健康分数(整数)
- Lojistik: 物流分数(整数)
- Maliye: 财政学分数(整数)
- Marka İletişimi: 品牌传播分数(整数)
- Menkul Kıymetler ve Sermaye Piyasası: 证券与资本市场分数(整数)
- Muhasebe ve Vergi Uygulamaları: 会计与税务应用分数(整数)
- Okul Öncesi Öğretmenliği: 学前教育教师分数(整数)
- Parakende Satış ve Mağaza Yöneticiliği: 零售与店铺管理分数(浮点数)
- Radyo ve Televizyon Programcılığı: 广播与电视节目制作分数(浮点数)
- Sağlık Kurumları İşletmeciliği: 医疗机构管理分数(浮点数)
- Sosyal Hizmet: 社会工作分数(浮点数)
- Sosyal Hizmetler: 社会服务分数(浮点数)
- Sosyoloji: 社会学分数(浮点数)
- Spor Yönetimi: 体育管理分数(浮点数)
- Tarım: 农业分数(浮点数)
- Turizm ve Otel İşletmeciliği: 旅游与酒店管理分数(浮点数)
- Turizm ve Seyehat Hizmetleri: 旅游与旅行服务分数(浮点数)
- Tıbbi Dökümantasyon ve Sekreterlik: 医疗文档与秘书分数(浮点数)
- Uluslar Arası İlişkiler: 国际关系分数(浮点数)
- Uluslararası Ticaret ve Lojistik Yönetimi: 国际贸易与物流管理分数(浮点数)
- Yaşlı Bakımı: 老年护理分数(浮点数)
- Yerel Yönetimler: 地方政府分数(浮点数)
- Yönetim Bİlişim Sistemleri: 管理信息系统分数(浮点数)
- Çalışma Ekonomisi ve Endüstri İlişkileri: 劳动经济学与产业关系分数(浮点数)
- Çağrı Merkezi Hizmetleri: 呼叫中心服务分数(浮点数)
- Çocuk Gelişimi: 儿童发展分数(浮点数)
- Özel Koruma ve Güvenlik: 特殊保护与安全分数(浮点数)
- İktisat: 经济学分数(浮点数)
- İnsan Kaynakları Yönetimi: 人力资源管理分数(浮点数)
- İşletme Yönetimi: 企业管理分数(浮点数)
- 数据集划分: 仅包含训练集(train),共68个样本,占用36022字节。
- 配置文件: 默认配置(default),数据文件路径为
data/train-*。 - 下载大小: 49747字节。
- 数据集大小: 36022字节。