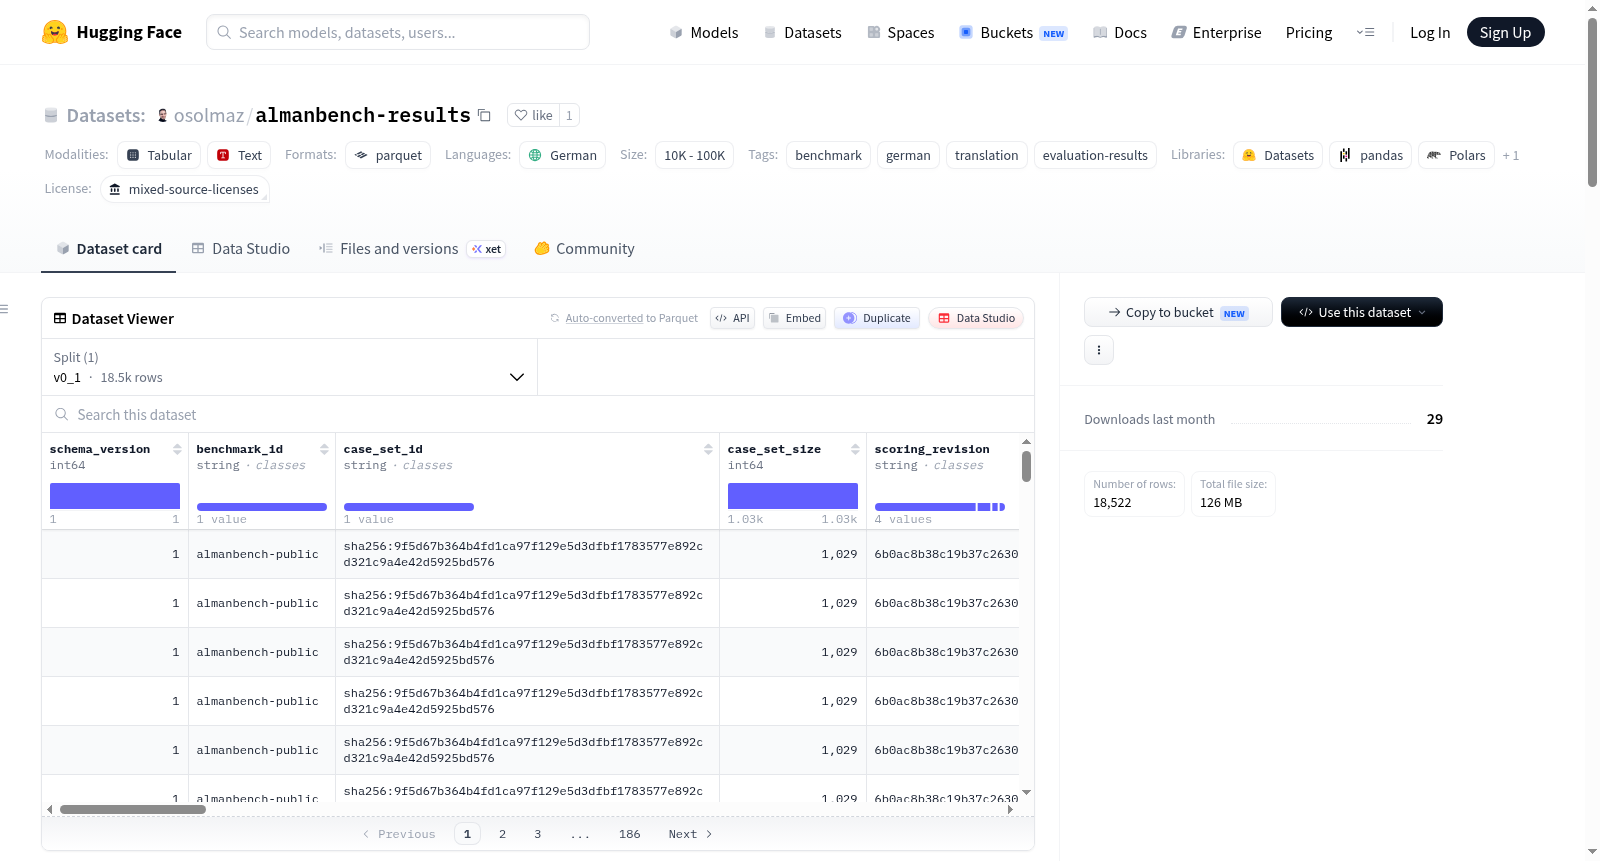
almanbench-results
收藏资源简介:
AlmanBench results 数据集是 AlmanBench(标准德语到 Alman 语翻译基准)的模型评估结果集合。该数据集存储了被评估模型对基准测试项目中每个项目的逐行回答,以及支撑公开排行榜的聚合数据。每个数据行对应一个模型对一个基准项目的响应,包含源句子(标准德语)、可接受的 Alman 语翻译版本、模型输出、任何暴露的推理过程、两个评分(接受度和合规度)、令牌计数以及完整的运行溯源信息(如运行ID、执行ID、案例集ID、评分修订版)。数据集特别包含 `reasoning_effort` 列,直接记录请求的推理工作量,无需从模型标签推断。当前版本(v0.1)包含 17,493 行数据,覆盖了 17 个不同模型在包含 1,029 个项目的公共测试集上的评估结果。接受度是主要评估指标,衡量模型输出与项目许可的所有翻译版本之间的标准化精确匹配程度;合规度是一个保守的检查器,用于标记 Alman 语消除的标准德语表面形式。数据集适用于机器翻译模型评估、基准测试分析、模型行为研究以及跨模型性能比较等任务。数据结果仅在同一个基准版本内具有可比性。数据集遵循严格的污染控制政策,禁止其内容出现在训练语料库中。
The AlmanBench results dataset is a collection of model evaluation results for AlmanBench, a benchmark for translating Standard German to Alman language. It stores line-by-line responses from evaluated models for each item in the benchmark project, along with aggregated data that supports the public leaderboard. Each row corresponds to a models response to a benchmark item, including the source sentence (Standard German), acceptable Alman language translation versions, model output, any exposed reasoning processes, two scores (acceptability and compliance), token counts, and full run traceability information (e.g., run ID, execution ID, case set ID, score revision). The dataset notably includes a `reasoning_effort` column that directly records the requested reasoning effort without inference from model labels. The current version (v0.1) contains 17,493 rows, covering evaluation results from 17 different models on a public test set of 1,029 items. Acceptability is the primary evaluation metric, measuring the normalized exact match between model output and all permitted translation versions of an item; compliance is a conservative checker for flagging Standard German surface forms eliminated by Alman language. The dataset is suitable for tasks such as machine translation model evaluation, benchmark analysis, model behavior research, and cross-model performance comparison. Data results are comparable only within the same benchmark version. The dataset adheres to a strict contamination control policy, prohibiting its content from appearing in training corpora.
数据集概览
AlmanBench results 是 AlmanBench(标准德语到 Alman 方言翻译基准测试)的逐样本模型结果数据集。该数据集记录了各评估模型对每个基准测试项的原始回答、评分、推理过程及完整运行信息,并汇总了公开排行榜背后的聚合数据。
基本信息
- 数据集名称:AlmanBench results
- 语言:德语(语言代码
de,子变体de-AL) - 许可证:其他(混合来源许可证)
- 标签:基准测试、德语、翻译、评估结果
- 样本规模:
10K < n < 100K(单表包含 18,522 行) - 配置:默认配置,数据文件为
data/results-v0.1.parquet(分割名v0_1)
数据结构与内容
每条记录代表一个模型对一个基准测试项的作答,包含以下关键列:
- 源句子(Source sentence)
- 可接受的翻译(Accepted renderings)
- 模型输出(Model output)
- 暴露的推理过程(Exposed reasoning)
- 两个评分:Acceptance(接受率)与 Compliance(合规率)
- Token 计数
- 完整运行来源信息(运行 ID、执行 ID、案例集 ID、评分修订版本号)
reasoning_effort列记录请求的推理努力级别
文件布局
| 路径 | 说明 |
|---|---|
data/results-v0.1.parquet |
所有模型的核心数据表(18,522 行,每模型每项一行),可通过 datasets 库加载并在数据查看器中浏览 |
v0.1/<model-id>/results.jsonl |
按运行分组的逐行结果,采用发布格式(JSON Lines) |
v0.1/<model-id>/result.json |
运行聚合结果,包含层级与集合细分、Token 总量、预估成本及生成配置 |
v0.1/<model-id>/manifest.json |
运行清单,含 Prompt 哈希和执行身份(仅适用于当前管道执行的任务) |
leaderboard.json |
所有模型在该案例集上的聚合结果,用于驱动排行榜页面 |
almanbench-result.schema.json |
每行结果的 JSON Schema 定义 |
当前结果(v0.1)
评估于 2026 年 7 月,使用系统提示中指定的规范。API 模型使用记录的推理努力级别;托管提供商模型通过 Hugging Face Inference Providers 运行。每个模型在全部 1,029 项公开测试集上运行一次。Acceptance 是主要评价指标。
| 模型 | 路由 | Acceptance | Compliance |
|---|---|---|---|
| GPT-5.5 xhigh | OpenAI API | 94.8% | 99.9% |
| GPT-5.6 Sol max | OpenAI API | 94.4% | 99.9% |
| Claude Fable 5 high | Anthropic API | 94.1% | 99.8% |
| GPT-5.6 Sol xhigh | OpenAI API | 93.5% | 99.7% |
| DeepSeek V4 Flash | HF Inference Providers, Novita | 89.7% | 99.8% |
| Inkling max | HF Inference Providers, Together | 89.2% | 99.8% |
| GPT-5.6 Luna xhigh | OpenAI API | 87.7% | 98.4% |
| GPT-5.6 Terra xhigh | OpenAI API | 87.5% | 99.8% |
| Kimi K2.7 Code | HF Inference Providers, Novita | 87.0% | 99.3% |
| DeepSeek V4 Pro | HF Inference Providers, Novita | 85.3% | 99.8% |
| Claude Sonnet 5 xhigh | Anthropic API | 83.3% | 95.4% |
| MiniMax M3 | HF Inference Providers, Novita | 79.6% | 98.2% |
| Claude Opus 4.8 max | Anthropic API | 74.8% | 91.1% |
| Nemotron 3 Ultra | HF Inference Providers, Together | 74.6% | 98.4% |
| Qwen3.6 35B A3B | HF Inference Providers, Scaleway | 74.3% | 97.0% |
| Gemma 4 31B IT | HF Inference Providers, Novita | 64.8% | 94.8% |
| MiMo V2.5 Pro | HF Inference Providers, DeepInfra | 64.2% | 88.5% |
| Ternary Bonsai 27B | HF Inference Providers, Together | 48.2% | 90.4% |
评价指标
- Acceptance(主要指标):对测试项完整许可翻译集的归一化精确匹配。评分区分大小写,历史来源中的古旧拼写必须保留。
- Compliance(辅助指标):保守的语法检查,标记 Alman 已淘汰的标准德语表面形式。不相关但语法正确的答案仍可通过,因此仅作为下限指标。
数据版本管理
结果仅在同一基准版本内可比。在 v0.1 版本中,接受集维护会就地更新参考标准,已存储的运行会重新评分(必要时在受影响行上重新运行)。每行记录其评分的 case_set_id 和 scoring_revision。未来版本会创建新目录和新 parquet 文件,旧版本保持不变发布。
使用示例
python from datasets import load_dataset
rows = load_dataset("osolmaz/almanbench-results", split="v0_1") sol = rows.filter(lambda r: r["model_id"] == "gpt-5.6-sol-xhigh") misses = sol.filter(lambda r: not r["correct"])
出处与污染政策
运行通过 bench-run 管道(Inspect AI、模型注册、导出器)执行,每行记录确切的 scoring_revision(可复现评分的仓库提交)。基准数据中的源句子和可接受翻译可能污染模型,AlmanBench 数据禁止出现在训练语料中。规范金丝雀 GUID:8b1a4c9e-almanbench-4f2d-9c7a-3e5b6d8f0a12。
引用信息
bibtex @misc{almanbench2026, title = {AlmanBench: A Standard German to Alman Translation Benchmark}, author = {Solmaz, Onur}, year = {2026}, howpublished = {url{https://alman.ai/almanbench/}} }