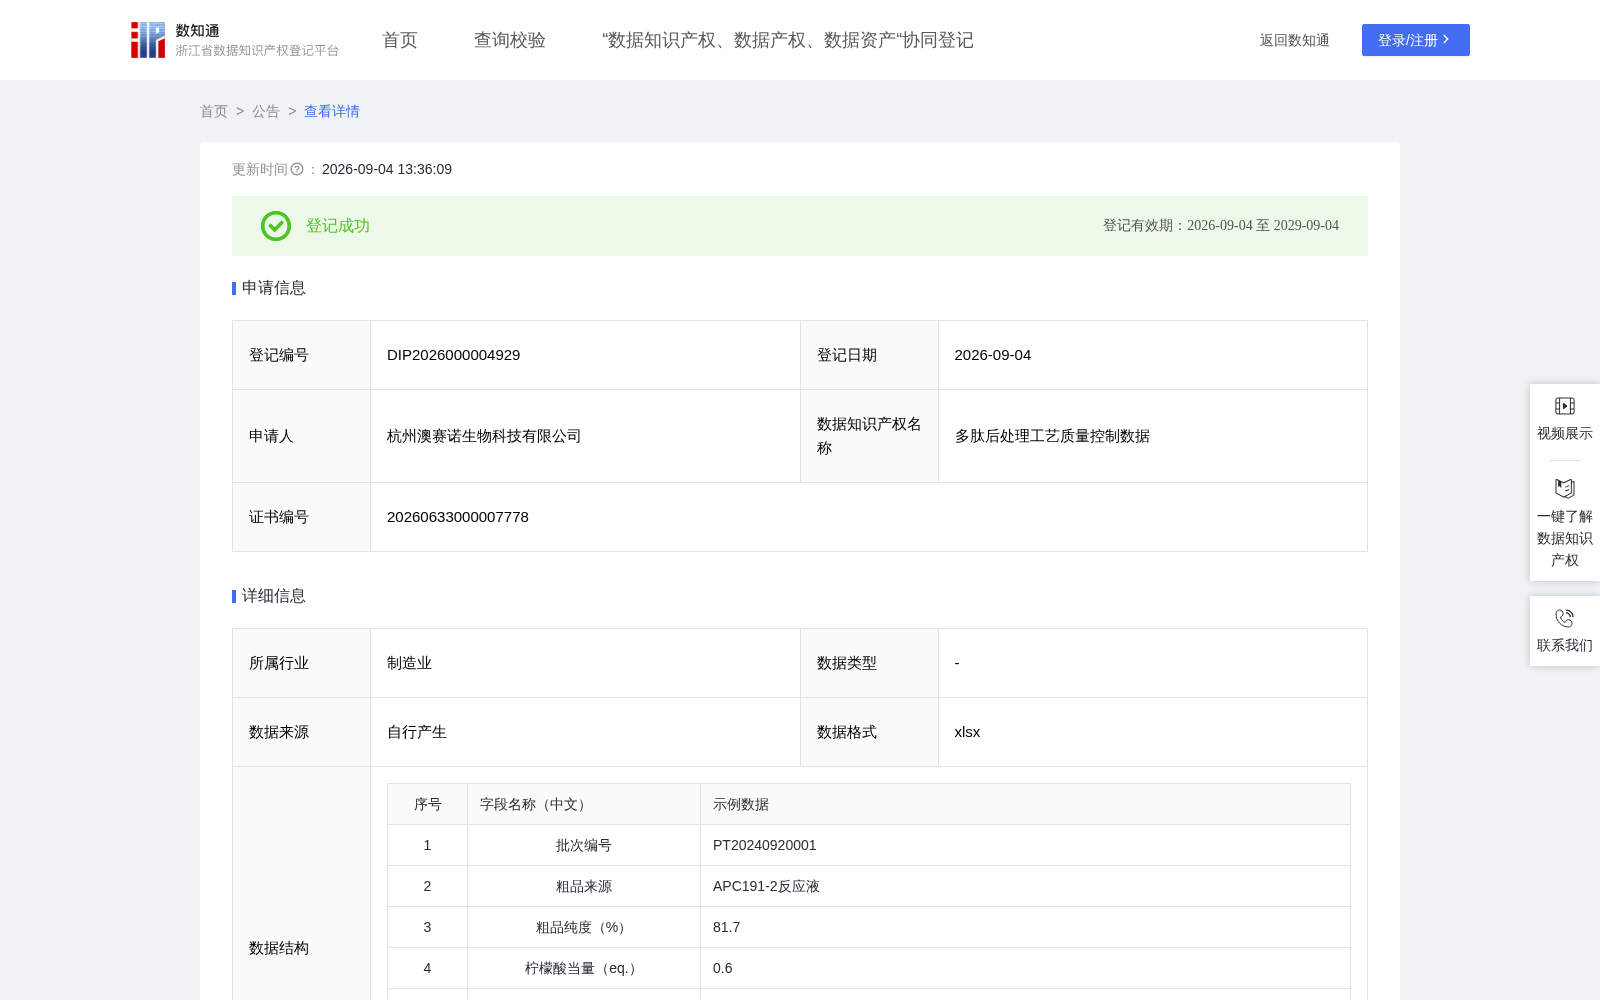
多肽后处理工艺质量控制数据
收藏资源简介:
本数据集基于APC191多肽合成后的纯化处理过程,系统采集酸洗、碱洗、盐水洗、打浆、干燥等关键后处理工序的工艺参数与质量检测数据,建立后处理工艺参数与杂质去除效果、产品纯度的关联评估模型。 数据结构中包含批次编号、粗品来源及纯度等标识字段,用于区分不同批次的处理对象;柠檬酸当量、碳酸氢钠当量、氯化钠当量等试剂用量字段,用于量化各工序的化学处理强度;各工序温度与时间字段,用于反映工艺操作条件;甲醇/乙腈打浆比例、干燥温度与时间等关键参数字段,用于评估精制工序对产品质量的控制效果。各字段相互配合,为后处理工艺质量评估提供量化数据支撑。 具体应用包括:(1)为多肽纯化工艺研发团队提供基于历史数据的杂质去除率预测参考,辅助分析不同后处理条件下杂质去除效率的差异,优化纯化工艺参数;(2)为质量控制人员提供批次质量等级评定依据,通过后处理工艺评分快速评估各批次纯化效果的一致性;(3)为生产管理人员提供各工序效果评估数据,辅助制定后处理标准操作规程和工艺改进方案。【加工前的数据说明】原始数据来源于公司多肽后处理纯化工艺生产记录,包含批次编号、粗品来源、粗品纯度、柠檬酸当量、第一次酸洗温度、第一次酸洗时间、碳酸氢钠当量、氯化钠当量、碱洗温度、碱洗时间、第二次盐水洗氯化钠质量分数、第二次盐水洗温度、第二次盐水洗时间、甲醇/乙腈打浆比例、打浆温度、打浆时间、干燥温度、干燥时间、产品稳定性评分、HPLC纯度HP、最大单杂、总杂、后处理收率等字段。加工前按格拉布斯准则(一种识别离群点的统计方法)剔除异常值并补缺失值。 【处理规则】1. 杂质去除率预测建模:采用梯度提升树回归(一种多棵决策树集成的回归法)建模,8:1:1划分5折交叉验证,将批次工艺参数代入训练好的模型预测得到杂质去除率。 2. 权重确定:采用熵值法(一种基于数据离散程度确定权重的方法)计算,得到杂质去除率权重α、稳定性评分权重β、HPLC纯度权重γ、后处理收率权重δ字段;权重依据各维度数据离散程度设定,离散程度越大权重越大。 3. 综合评分与质量分级:按公式"后处理工艺评分=α×杂质去除率×100+β×产品稳定性评分+γ×HP×100+δ×后处理收率×100"计算,得到后处理工艺评分字段;按分位数法(按排序位置确定阈值)确定阈值,A级阈值取80百分位、B级阈值取50百分位,得到A级阈值、B级阈值字段;后处理工艺评分≥A级阈值为A级,B级阈值≤后处理工艺评分<A级阈值为B级,后处理工艺评分<B级阈值为C级,得到质量等级字段。 4. 工序级效果评估:计算后处理工艺评分与各工序参数的皮尔逊相关系数(一种度量两变量线性相关的统计方法),得到酸洗工序相关系数、碱洗工序相关系数、打浆工序相关系数字段;酸洗工序相关系数≥0.6评定为优良,0.3≤酸洗工序相关系数<0.6评定为一般,酸洗工序相关系数<0.3评定为待优化,碱洗工序相关系数、打浆工序相关系数按同口径评定,得到酸洗效果评估、碱洗效果评估、打浆效果评估字段。 以上计算结果均保留2位小数。 【数据内容描述】经加工后形成的数据集包含38个字段:批次编号、粗品纯度、柠檬酸当量、杂质去除率、后处理工艺评分、质量等级、酸洗工序相关系数、酸洗效果评估等38个字段,用于多肽后处理工艺质量评估。