
遇见数据集

adrilmanurung/momento

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

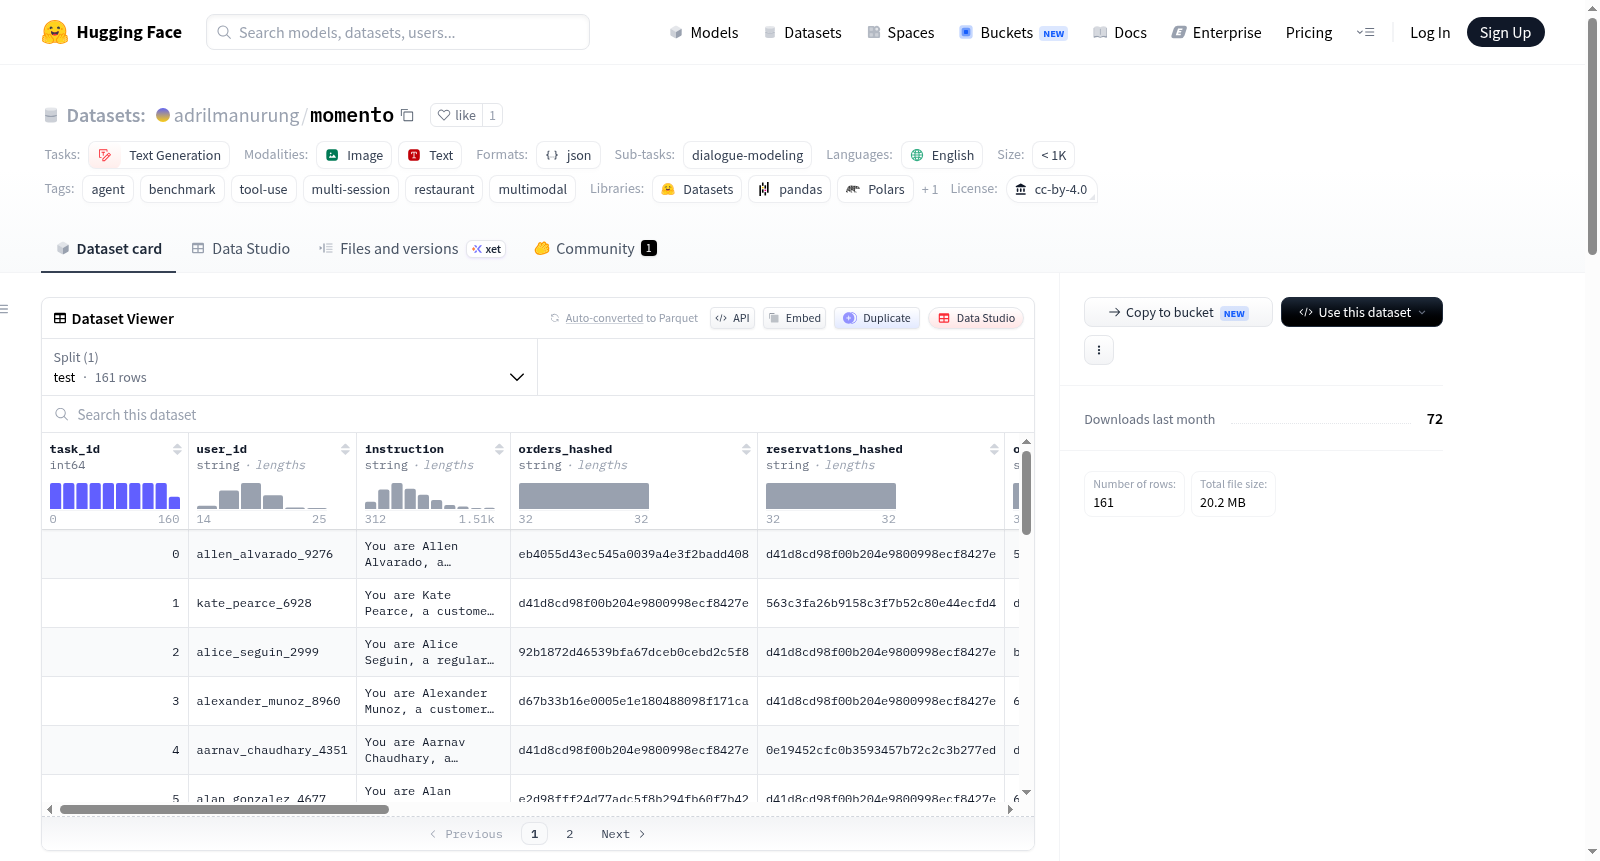
Momento是一个基准数据集,用于评估基于大型语言模型(LLM)的代理在跨多个会话的对话中,通过工具介导完成任务的持久记忆和推理能力。任务基于餐厅服务领域,要求代理回忆过去的用户偏好、解决跨多个交互的目标、以正确顺序调用正确工具,并遵守领域策略约束。与单轮或单会话基准不同,Momento明确测试代理是否能利用长期记忆,基于先前的对话历史在新会话中正确服务用户。数据集包含场景数据(如scenarios.jsonl),每个任务包括任务ID、用户ID、指令、会话历史、工具调用DAGs、图像引用等,支持多模态和代理评估。

Momento is a benchmark dataset for evaluating LLM-based agents on persistent, tool-mediated task completion across multiple conversational sessions. Tasks are grounded in a restaurant service domain and require agents to recall past user preferences, resolve goals that span multiple interactions, and invoke the correct tools in the correct order, all while respecting domain policy constraints. Unlike single-turn or single-session benchmarks, MOMENTO explicitly tests whether agents can leverage long-term memory to serve users correctly in new sessions based on prior conversation history. The dataset includes scenario data (e.g., scenarios.jsonl), with each task comprising task ID, user ID, instruction, session history, tool call DAGs, image references, etc., supporting multimodal and agentic evaluation.

提供机构:
adrilmanurung
搜集汇总
数据集介绍
adrilmanurung/momento 数据集图片
构建方式
Momento数据集专为评估基于大语言模型的智能体在多会话场景下的持久记忆与推理能力而构建,其任务设定于餐厅服务领域。每个样本以JSON格式存储于scenarios.jsonl文件中,包含任务标识、用户身份、指令、当前日期、预期数据库状态哈希值、工具调用有向无环图、智能体必须向用户呈现的预期信息、历史会话记录、种子数据以及可选图片引用。历史会话记录了用户过去的偏好与交互,种子数据提供了任务相关的数据库行,而工具调用有向无环图则定义了多个可接受的工具执行顺序,确保任务完成的多样性与正确性。
特点
Momento数据集的独特之处在于其跨多会话的持续性任务设计,要求智能体在多次交互中利用长期记忆来正确服务用户。它明确测试了智能体能否回忆过去用户偏好、解决跨越多个会话的目标,并按正确顺序调用恰当的工具,同时遵守领域策略约束。每个任务包含多个可接受的工具调用序列,适应不同解决方案路径。此外,数据集提供了图片等非文本元素,模拟用户可能参考的视觉信息,进一步增加了任务的复杂性和真实感。
使用方法
使用Momento数据集时,首先将每个任务的种子数据注入数据库,并将历史会话加载到记忆系统中。然后,智能体需基于当前指令与历史记忆,在模拟对话中逐步调用工具完成任务。评估通过比较预期数据库状态哈希值、工具调用序列及需呈现信息来量化智能体的表现。任务中的工具调用有向无环图定义了多个可接受方案,因此评估应检查智能体是否执行了任一有效路径。数据集支持多种验证方式,包括检查参数子集或工具返回值,适用于不同粒度的评估场景。
背景与挑战
背景概述
Momento是一个由研究团队于近年构建的基准数据集,旨在评估基于大语言模型(LLM)的智能体在跨会话场景中完成持久性任务的能力。该数据集聚焦于餐厅服务领域,核心研究问题在于智能体能否利用长期记忆,在多次交互中准确回忆用户偏好、解决跨会话目标,并遵循领域策略正确调用工具。Momento的提出标志着对话系统评估从单轮或单会话任务向多会话、记忆驱动的复杂场景迈进,对推动智能体在真实服务场景中的应用具有重要价值。
当前挑战
Momento数据集所解决的领域问题主要挑战在于,现有基准测试多局限于单次交互,无法检验智能体对历史信息的保持与推理能力,而真实服务场景常需跨越多个会话完成任务。在构建过程中,研究者面临三大挑战:一是模拟真实多会话对话的复杂性,需设计连贯的用户画像与跨会话目标;二是定义多样化的工具调用依赖关系(如DAG结构),确保任务有多个有效解决方案,但验证时需严格匹配工具调用顺序与参数;三是引入视觉信息(如菜品图像)作为对话参考,增加了多模态理解与记忆调用的难度。
常用场景
经典使用场景
Momento数据集专为评估多会话、持久化记忆与工具调用能力的对话智能体而生。其核心设计围绕餐饮服务领域展开,要求智能体在跨越多个会话周期的交互中,准确记忆用户的历史偏好与行为记录,并在新会话中根据这些记忆信息调用恰当的工具完成任务。经典使用场景包括:智能体需在用户首次访问时记录其饮食习惯,在数周后的再次订餐中主动推荐符合其口味的菜品,同时处理预约、会员积分查询等跨会话操作。该数据集通过精心构造的action_dags结构,提供了多条可接受的工具调用路径,从而能够全面检验智能体在复杂约束下的规划与记忆能力。
解决学术问题
Momento数据集填补了现有对话智能体评测中缺乏长期记忆与跨会话推理能力的空白。传统基准测试多为单轮或单会话任务,难以揭示智能体在持久化上下文中的表现短板。该数据集通过引入结构化历史会话、种子数据库以及多步工具依赖图,系统性地解决了一个关键学术问题:如何评测智能体在多次交互中保持用户状态一致性、正确恢复历史上下文并据此进行合理决策的能力。其意义在于为持久化记忆与工具调用领域的模型比较提供标准化评估框架,推动了面向真实复杂场景的对话系统研究,尤其是在需要长期服务关系的垂直领域中具有重要影响。
衍生相关工作
Momento数据集的发布催生了多项围绕持久化记忆与多会话推理的衍生研究工作。与该数据集相辅相成的经典工作包括:基于检索增强生成(RAG)的记忆管理策略研究,探索如何高效存储和检索跨会话的用户事实;面向工具调用的图规划方法,利用action_dags结构优化子任务调度与依赖解析;以及多模态融合的对话记忆模型,将食物图像等视觉信息与文本记忆结合以提升用户意图理解。此外,Momento所使用的评估范式已被后续工作借鉴,用于构建金融、医疗等垂直领域的持久化对话基准,进一步扩大了其在长程人机交互评测方面的学术影响力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

