
bengaliAI/ben10-asr-results
收藏官方服务:
资源简介:
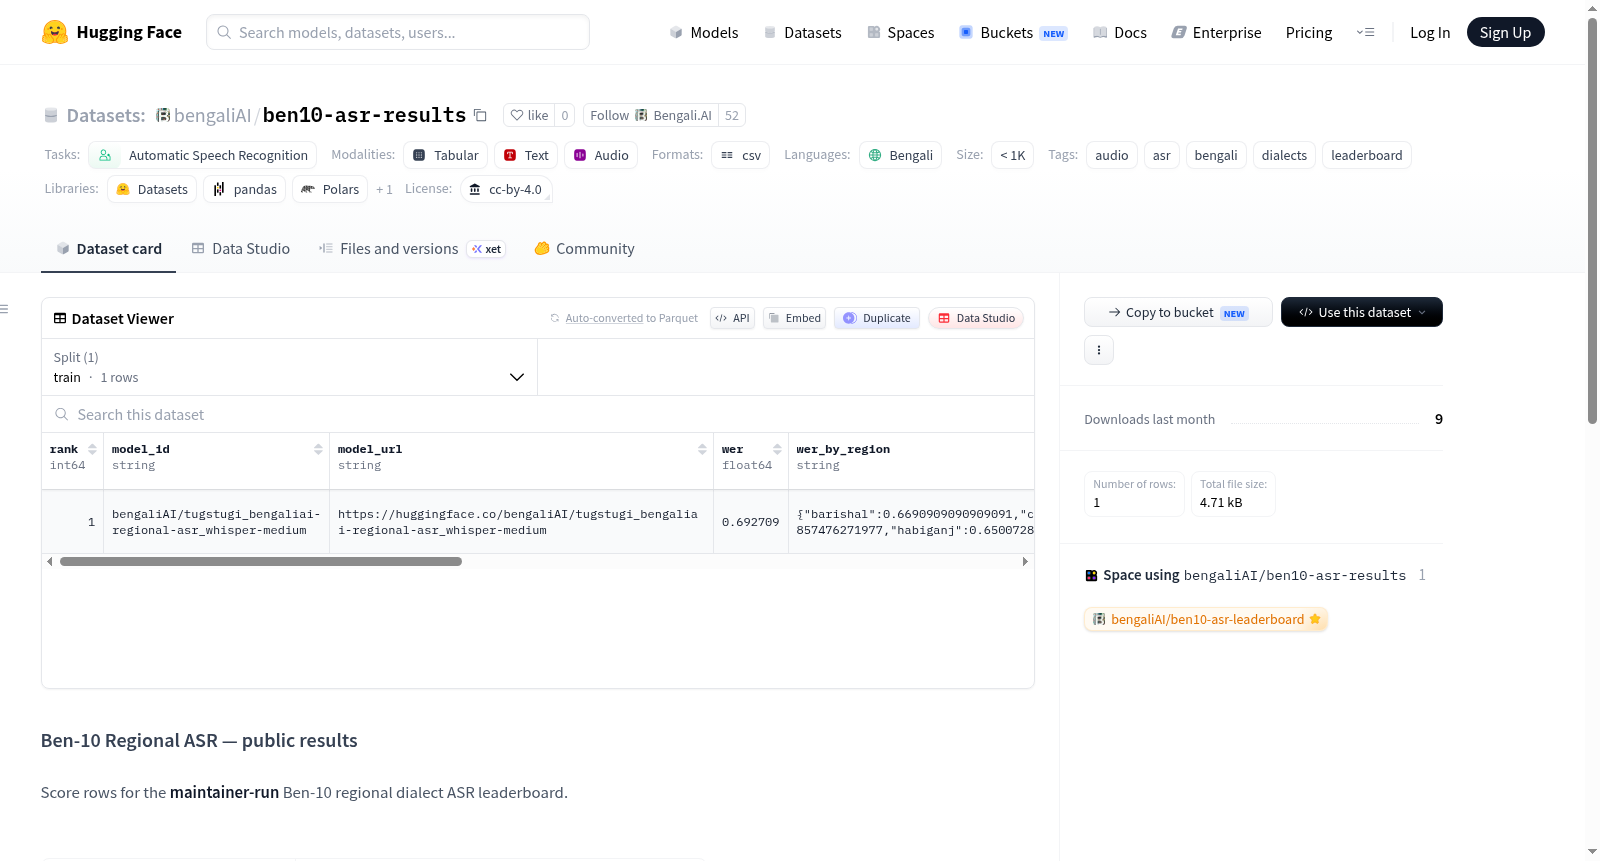
该数据集包含Ben-10区域方言自动语音识别(ASR)排行榜的公共结果,专注于孟加拉语(bn)及其方言。数据集用于记录和维护由维护者运行的ASR模型在私有测试集ben-10-test上的评估分数,包括词错误率(WER)、区域特定WER、模型信息、评估时间等字段。README强调了测试集保持私有性,禁止上传任何预测文件或测试标签,并提供了评估请求流程。
This dataset contains public results for the Ben-10 regional dialect automatic speech recognition (ASR) leaderboard, focusing on Bengali (bn) and its dialects. It is used to record and maintain evaluation scores of ASR models on the private test set ben-10-test by maintainers, including fields such as word error rate (WER), region-specific WER, model information, evaluation timestamps, and more. The README emphasizes that the test set remains private, prohibits uploading any prediction files or test labels, and outlines the evaluation request process.
提供机构:
bengaliAI搜集汇总
数据集介绍
构建方式
Ben-10 Regional ASR Leaderboard Results数据集专为孟加拉语方言自动语音识别(ASR)任务而生,其构建依托于严谨的评测流程。数据集以CSV格式存储了由维护者统一运行的Ben-10区域方言ASR排行榜评分结果,每条记录包含模型标识、权重链接、整体词错误率(WER)以及按区域细化的词错误率映射,同时记录了推理后端、代码提交哈希值及评测时间等元信息。为确保评估的公正性与可复现性,测试集严格保密,不对外公开任何音频、标签或假设结果,仅通过维护者在封闭测试集上解码后追加评分行来更新数据。
使用方法
该数据集主要用于查阅和追踪Ben-10区域方言ASR排行榜的评测结果,用户可通过HuggingFace上的ben10-asr-leaderboard空间可视化查看各模型的区域词错误率。若要提交新模型进行评测,用户需在BengaliAI/reg-speech-aacl仓库的议题区发起请求,由维护者在私有测试集上解码并更新结果行。数据集本身不提供公开的预测文件或测试标签,用户应避免上传此类内容以维护评测的完整性与安全性。
背景与挑战
背景概述
在自动语音识别(ASR)领域,地域方言的多样性对模型泛化能力构成了显著挑战,尤其对于低资源语言如孟加拉语而言尤为突出。为系统评估多方言ASR系统的性能,孟加拉语AI社区(BengaliAI)于近期构建了Ben-10 Regional ASR基准数据集与排行榜。该数据集由研究机构与志愿者共同维护,专注于孟加拉语十个主要方言区域的语音识别评测,通过私有测试集`ben-10-test`提供统一的模型评估平台。核心研究问题在于衡量现有ASR模型在跨地域方言上的鲁棒性,其影响力已延伸至南亚多语言语音处理领域,为方言级ASR评估树立了重要范式。
当前挑战
该数据集面临的挑战具有双重性。在领域问题层面,孟加拉语方言间声学与语言特征的显著差异导致标准ASR模型在方言区域上的词错误率(WER)严重不均,亟需通过地域粒度化的评测来驱动方言自适应与多方言联合建模方法的发展。在构建过程中,由于测试集需保持完全私有以防止过拟合,使得社区贡献者无法获取原始音频与标注,仅能依赖维护者团队进行封闭解码,这一非对称评估机制增加了验证结果可复现性的难度。此外,排行榜维护依赖人工请求与处理流程,在社区参与度增长时可能面临反馈延迟与扩展性瓶颈。
常用场景
经典使用场景
Ben-10区域ASR排行榜结果数据集,作为孟加拉语方言语音识别研究领域的标杆性资源,其经典使用场景在于系统性地评估和比较不同语音识别模型在孟加拉语及其10种地域方言上的识别性能。研究者可通过该数据集提供的标准化词错误率(WER)以及按区域细分的WER指标,横向对比自研模型与前沿模型的方言鲁棒性。该数据集常被用来验证多方言语音识别系统的泛化能力,尤其是在资源稀缺的孟加拉语方言场景下,为模型在不同口音、韵律和词汇变异上的适应能力提供了量化的评价基准。
解决学术问题
在学术研究中,Ben-10数据集核心解决了孟加拉语方言语音识别领域长期缺乏标准化、可复现评测基准的困境。传统上,孟加拉语方言识别研究因测试集不统一、评估指标各异,导致模型性能难以横向对比。该数据集通过维护私密测试集和标准化评估流程,为研究者提供了公平、透明的竞争舞台,从而推动了端到端语音识别、自监督预训练模型、语言模型适配等技术在方言场景下的系统化性能评估。其意义在于促使学术界关注低资源方言的语音识别难题,并为模型优化指明区域层面的性能短板,进而促进孟加拉语言社区的人机交互公平性。
实际应用
在实际应用层面,Ben-10数据集支撑着孟加拉语方言语音识别产品的精准迭代与落地部署。例如,面向孟加拉国农村地区的语音助手、智能客服和语音输入法,需能准确理解迥异于标准语的区域口音。开发者借助该数据集的区域WER细粒度分析,可定位模型在特定方言(如锡尔赫特语、吉大港语)上的识别瓶颈,从而针对性收集口音数据或调整解码策略。此外,该数据集还服务于方言语音检索、多语种会议转写及无障碍通信系统,显著提升了地域方言用户在语音交互场景中的实际体验和包容性。
数据集最近研究
最新研究方向
在孟加拉语区域方言自动语音识别(ASR)领域,Ben-10基准数据集的最新研究方向聚焦于构建细粒度方言鲁棒性评估体系。通过维护私有测试集与标准化解码流程,研究者可精确量化模型在孟加拉各地方言上的词错误率(WER)差异,从而推动方言感知型语音模型的迭代优化。该成果不仅为孟加拉语自然语言处理树立了方言评测新范式,更对低资源语言中的方言公平性研究具有标杆意义,其开放式评估机制正催化区域多模态语音技术的边界拓展。
以上内容由遇见数据集搜集并总结生成


