
遇见数据集

BCCard/bc-finance-llm-benchmark

收藏
Hugging Face2026-06-29 更新2026-07-22 收录
官方服务:

资源简介:

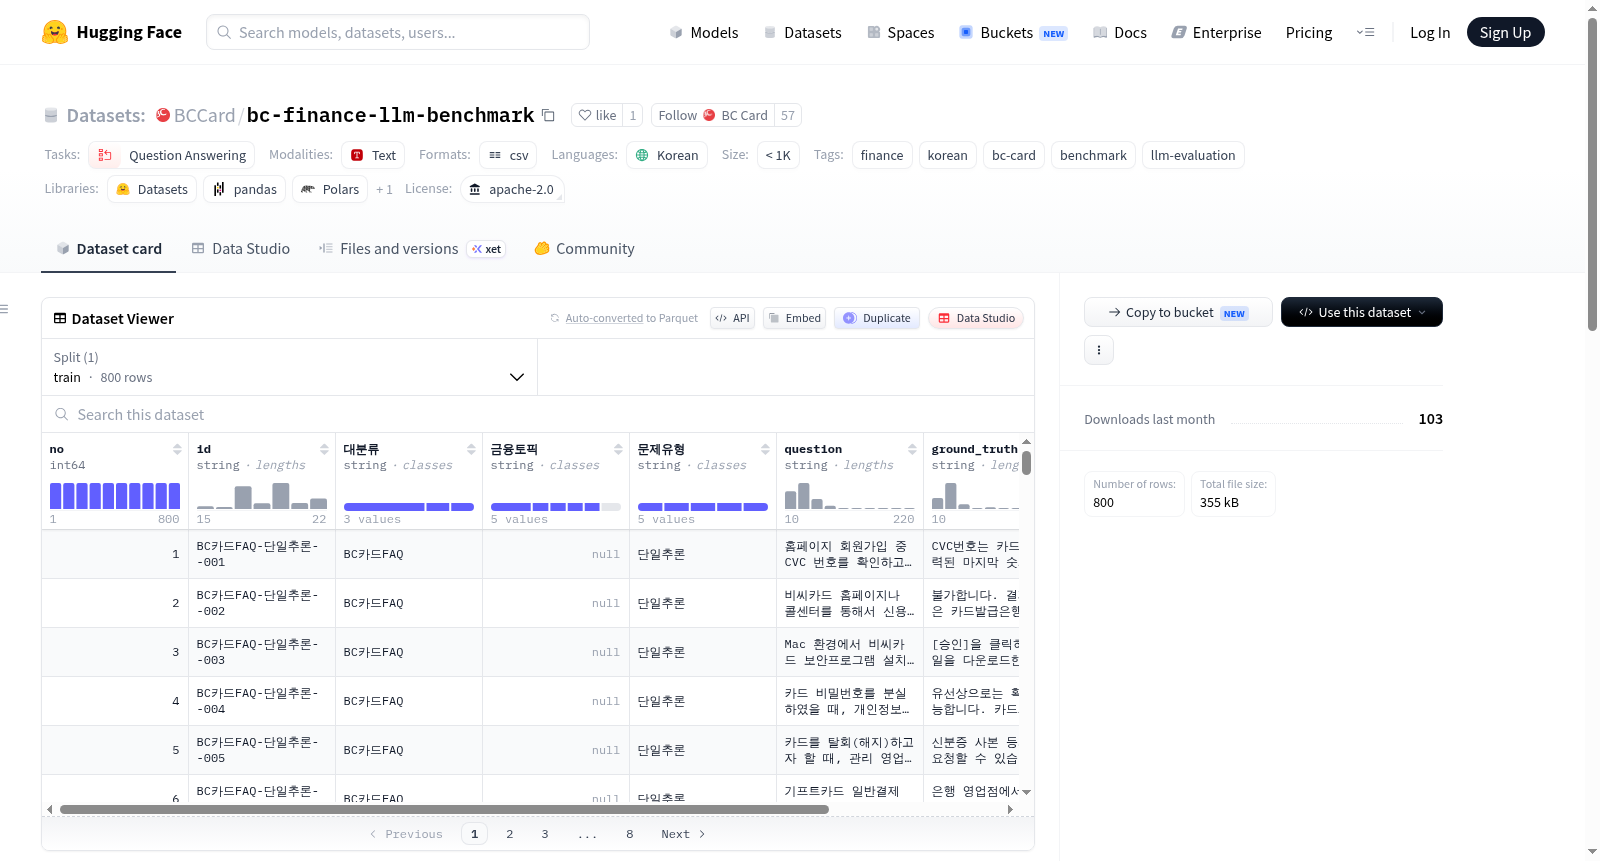
BC Card Finance LLM Benchmark是一个专门用于评估韩国金融领域大型语言模型(LLM)性能的基准数据集。该数据集由BC卡与延世大学DSL通过产学合作项目(S2026 LLMOps项目)共同开发。数据集包含800个韩语问答对,涵盖金融领域,特别是BC卡FAQ和通用金融主题。数据格式为问题与真实答案对,包含序号、ID、大类分类(如BC卡FAQ、通用等)、金融细分主题、问题类型(如单一推理、多重推理等)、问题文本、真实答案和来源标签等列。该数据集主要用于LLM-as-Judge自动评估流程,通过比较模型生成的回答与提供的真实答案来评估模型性能。数据集采用Apache 2.0许可证。

BC Card Finance LLM Benchmark is a benchmark dataset specifically designed for evaluating the performance of large language models (LLMs) in the Korean financial domain. It is an outcome of the industry-academia collaboration between BC Card and Yonsei University DSL (S2026 LLMOps project). The dataset consists of 800 Korean question-answer pairs covering the financial domain, particularly BC Card FAQs and general finance topics. The format is Question/Ground Truth pairs, with columns including serial number, question ID, broad category (e.g., BC Card FAQ, general), financial sub-topic, question type (e.g., single reasoning, multiple reasoning), question text, ground truth (reference answer), and source tag. It is intended for use in LLM-as-Judge automatic evaluation pipelines to compare model responses against the ground truth. The dataset is licensed under Apache 2.0.
提供机构:
BCCard
搜集汇总
数据集介绍
BCCard/bc-finance-llm-benchmark 数据集图片
构建方式
该数据集源自BC卡与延世大学DSL实验室的产学研合作项目(S2026 LLMOps项目),专注于韩国金融领域大语言模型的性能评估。构建过程基于BC卡的常见问题解答(FAQ)以及通用金融知识,精心筛选并组织了800道评估题目。每道题目均包含唯一的标识符、问题原文、标准参考答案(ground_truth),以及详细的元数据,如数据来源大类、具体金融主题和题目类型(如单步推理、多步推理)。通过系统化的分类与标注,确保了评估内容的全面性与专业性。
特点
bc-finance-llm-benchmark数据集的核心特点在于其高度的金融领域针对性,完全使用韩语构建,覆盖从BC卡业务FAQ到广泛金融知识的多元层次。其独特的元数据体系,包括金融主题和问题类型标签,允许进行细粒度的模型能力诊断。作为LLM评估基准,它采用LLM-as-Judge的自动化评估范式,通过比较模型输出与预定义的ground_truth来衡量模型在韩国金融场景下的推理准确性与知识掌握程度,为领域内模型的迭代优化提供了标准化标尺。
使用方法
用户可将此数据集无缝集成至LLM-as-Judge的自动评估流水线中。具体而言,将数据集中的'问题'作为输入,交由待评估的韩国金融专业大语言模型生成回答。随后,利用评判模型或预定义的评分逻辑,将模型生成内容与数据集中对应的'ground_truth'进行语义对齐与质量比较,从而得出客观的评分。该过程无需人工干预,支持大规模模型批量测试,高效评估模型在韩国金融知识问答任务上的综合表现。
背景与挑战
背景概述
随着大型语言模型(LLM)在金融领域的广泛应用,评估其专业性能已成为一项关键任务。BC Card Finance LLM Benchmark 数据集由 BC卡公司与延世大学 DSL 实验室联合创建,作为 S2026 LLMOps 项目的成果,于近期发布。该数据集包含 800 道韩国金融领域问答题,覆盖 BC卡 FAQ 及一般金融知识,旨在系统性地评估 LLM 在金融场景中的推理与回答能力。其问世填补了韩国特定金融领域基准测试的空白,推动了金融行业 LLM 的标准化评估进程,并促进了相关技术在信贷、客服等实际业务中的落地验证。
当前挑战
该数据集所面对的领域挑战在于:金融领域对答案的精确性和合规性要求极高,LLM 需在多步推理、术语理解及政策适应性上达到足够水准,而现有通用基准难以衡量此类专业能力。构建过程中的挑战亦不容忽视:数据源涉及敏感金融文档,需平衡机密性与可用性;人工构建 800 道高质量问答对需要领域专家深度参与,确保问题覆盖广度与真实性;同时,标注标准的一致性和多源文本的整合也增加了数据集构建的复杂性。
常用场景
经典使用场景
在金融领域的大语言模型研究中,bc-finance-llm-benchmark数据集以其800道精心设计的问题,成为了评估模型在韩语金融场景下理解与推理能力的标杆。该数据集涵盖BC卡常见问题解答与一般金融知识,通过单步推理、多步推理等多样化题型,系统性地检验模型对金融术语、业务流程及风险规则的掌握程度。典型用法是采用LLM-as-Judge的自动评估框架,将模型生成答案与参考答案进行语义匹配与逻辑一致性比对,从而量化模型在垂直领域中的表现优劣。这一设计不仅降低了人工评估的成本,还为韩语金融LLM的迭代优化提供了可复现的标准化基准。
实际应用
在实际产业中,该数据集直接服务于金融科技企业对大模型进行定制化评估与选型。例如,银行或信用卡公司在部署智能客服系统前,可利用该基准测试不同LLM在面对账户查询、交易纠纷处理、金融产品解释等高频场景时的应答质量。此外,数据集中的多步推理问题可检验模型能否胜任如贷款条件分析、投资风险提示等需要综合多源信息的任务。通过筛选出在该基准中表现优异的模型,企业能够更可靠地将其集成到自动化服务流程中,从而降低人工介入成本、提升客户响应效率,同时确保回答的金融合规性与专业性。
衍生相关工作
自bc-finance-llm-benchmark发布以来,衍生出一系列具有影响力的研究工作。有学者基于该数据集提出了面向韩语金融领域的检索增强生成(RAG)优化方案,通过对比倒排索引、稠密检索等策略对基准得分的影响,验证了外部知识库对模型金融问答能力的提升效果。另有工作利用该基准微调轻量级模型(如Qwen2.5-7B),探索在资源受限环境下保持领域回答准确性的路径。此外,部分研究将其作为对抗性测试的评估工具,通过构建扰动样本来分析模型对金融文本细微差异的鲁棒性。这些衍生工作均表明,该数据集已逐步成为韩语金融LLM研究的共享基石,持续激发着社区在领域适配、效率优化与安全评估等方向的创新探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

