
nassimjp/loquace-102k-pashto
收藏官方服务:
资源简介:
مینه ناک خبرې کوونکې - یوه ټولګه چې ۱۰۲،۰۰۰ ایټالوي مینه ناک او احساساتي خبرې اترې پکې په ښکلي پښتو ژباړل شوي دي。
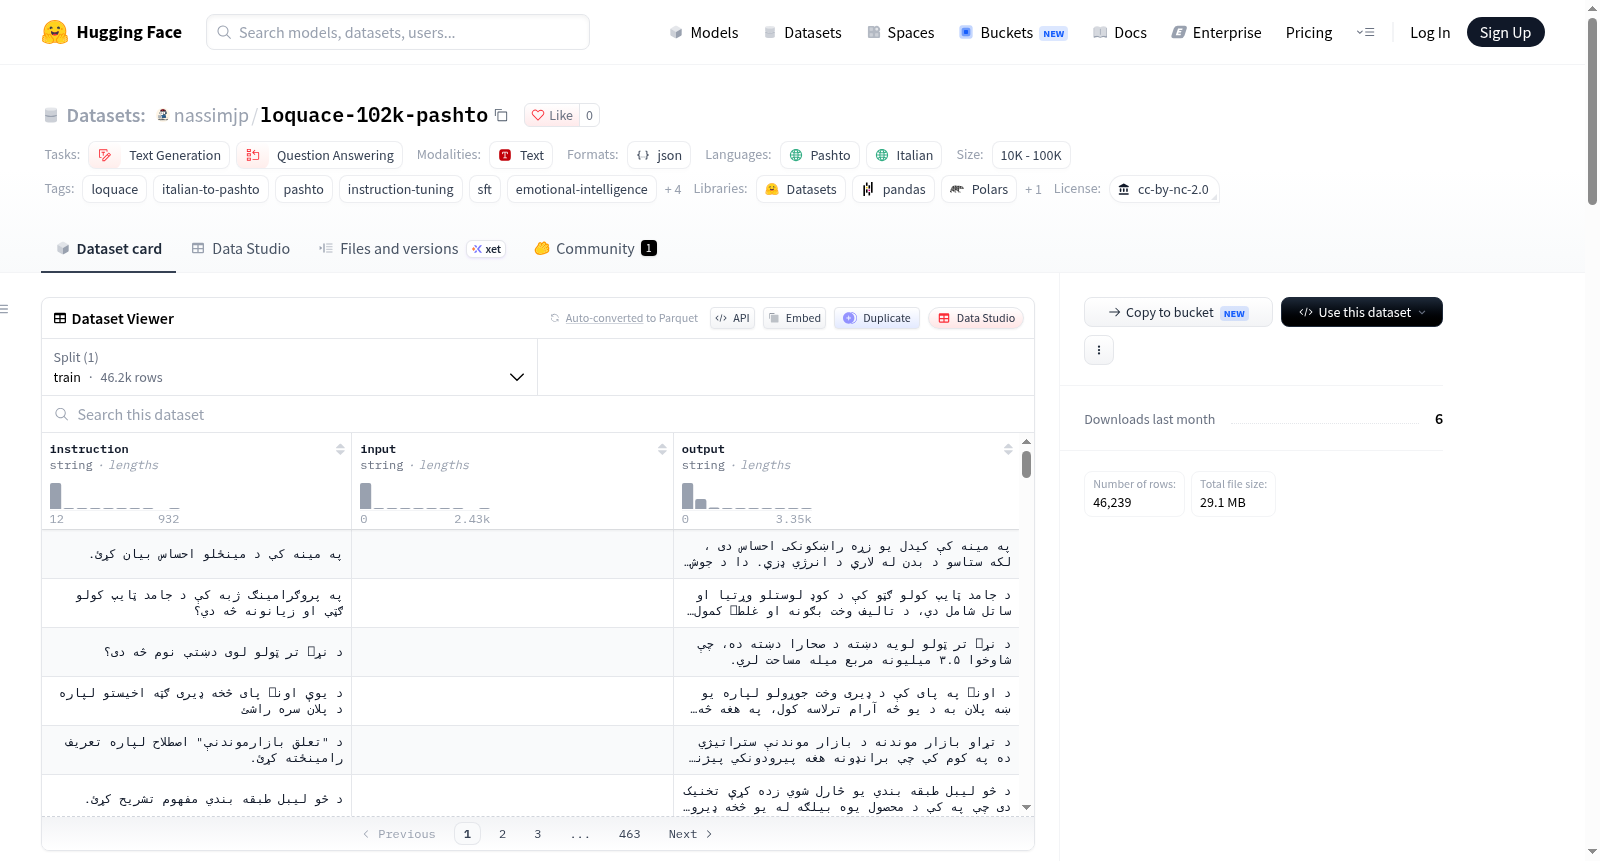
This is a meticulously curated, emotionally-rich dataset of 102,000 Italian conversations translated into Pashto, designed for Supervised Fine-Tuning (SFT) of Large Language Models (LLMs) for emotional intelligence, romantic conversations, and poetic expressions in Pashto.
提供机构:
nassimjp搜集汇总
数据集介绍
构建方式
该数据集构建于跨语言情感对话资源稀缺的背景下,以cosimoiaia发布的Loquace-102k意大利语情感对话数据集为源文本,借助Google Translate API将全部102,000条对话逐条译为普什图语,形成意大利语至普什图语的双语平行语料。翻译流程保留原始对话的轮次结构与情感标注,未对内容进行人工改写或筛选,最终由nassimjp整理发布至Hugging Face平台,并以CC BY-NC 2.0协议开放,确保衍生作品遵循相同许可条件。
特点
数据集在规模与情感维度上具有显著特征。其收录逾十万条独特对话,体量处于10万至100万区间,是目前针对普什图语情感智能任务规模最大的公开资源之一。内容聚焦爱情、浪漫与情绪表达,语言风格兼具诗意与口语化,覆盖指令微调、情感问答及文本生成等任务类型。源语言为意大利语,目标语言为普什图语,形成非对称低资源语言对,为跨语言情感迁移研究提供独特素材。
使用方法
该数据集适用于大语言模型的监督微调,研究者可加载Hugging Face数据集库中的对应仓库,按对话轮次或指令-回复格式解析数据,用于训练普什图语情感对话生成、共情回复及问答系统。使用时应遵循CC BY-NC 2.0许可,仅限非商业研究用途,并须在成果中明确标注原始数据集Loquace-102k及翻译者nassimjp。鉴于数据为机器翻译产物,建议在训练前进行质量抽检,并结合人工评估以降低翻译噪声对模型性能的影响。
背景与挑战
背景概述
普什图语作为低资源语言,长期缺乏情感智能与浪漫对话的高质量指令微调数据,制约了大型语言模型在普什图语情感表达与生成任务上的表现。2026年,研究者Nassim(nassimjp)在Hugging Face平台发布了loquace-102k-pashto数据集,该数据集基于cosimoiaia于2024年构建的意大利语情感对话数据集Loquace-102k,通过机器翻译与人工筛选,将102,000余条意大利语对话译为普什图语,旨在为普什图语大语言模型的情感智能、浪漫对话及诗歌化表达提供监督微调资源。该数据集填补了普什图语在情感计算与对话生成领域的空白,对推动低资源语言的情感智能研究具有重要的奠基意义,并为后续跨语言情感迁移研究提供了可复用的数据范式。
当前挑战
该数据集所应对的领域问题在于普什图语情感对话数据的极度稀缺,以及现有大语言模型在普什图语浪漫与情感语境下生成能力薄弱,难以捕捉其诗歌传统与细腻情感表达。构建过程中,翻译质量面临显著挑战,意大利语与普什图语在情感隐喻、文化意象及礼貌策略上存在深层差异,机器翻译难以完整传递原文的情感温度与语用意图。同时,浪漫与亲密对话涉及文化敏感内容,需在普什图语文化规范下进行本地化调适,避免语义偏移或冒犯。此外,非商业许可限制了下游应用的推广,数据规模虽达十万级,但对话多样性与情感细粒度标注仍有待进一步丰富与验证。
常用场景
经典使用场景
在低资源语言情感计算领域,该数据集作为迄今规模最大的普什图语情感对话语料,经典使用场景集中于大语言模型的情感智能监督微调。研究者以102,000条意大利语源对话的普什图语译文为样本,训练模型生成饱含爱意、浪漫与诗性表达的回应,从而填补普什图语在情感对话生成任务上的数据空白。其指令微调格式天然适配对话系统的生成式训练,使模型习得普什图语中细腻的情感韵律与修辞风格。
实际应用
实际应用中,该数据集可服务于普什图语聊天机器人、情感陪伴系统及跨文化交际辅助工具的研发。开发者利用其训练模型,能够构建以普什图语进行浪漫对话、情感疏导与诗歌创作的智能体,满足普什图语用户对母语情感交互的需求。同时,该数据集亦可用于机器翻译系统的情感风格迁移评估,以及在非商业研究场景下开展低资源语言对话系统的基准测试,具备显著的社会应用潜力。
衍生相关工作
该数据集直接衍生于意大利语Loquace-102k情感对话数据集,通过机器翻译构建普什图语版本,形成了跨语言情感对话数据家族。围绕其产生的经典工作包括基于该语料的普什图语情感生成模型微调研究、低资源语言翻译质量对比分析,以及结合普什图诗歌传统的情感表达风格迁移探索。这些工作共同拓展了情感智能在多语言环境下的研究边界,并为后续普什图语自然语言处理任务奠定了数据基础。
以上内容由遇见数据集搜集并总结生成


