
遇见数据集

qwen_continuation_dataset

收藏
Hugging Face2026-07-05 更新2026-07-06 收录
官方服务:

资源简介:

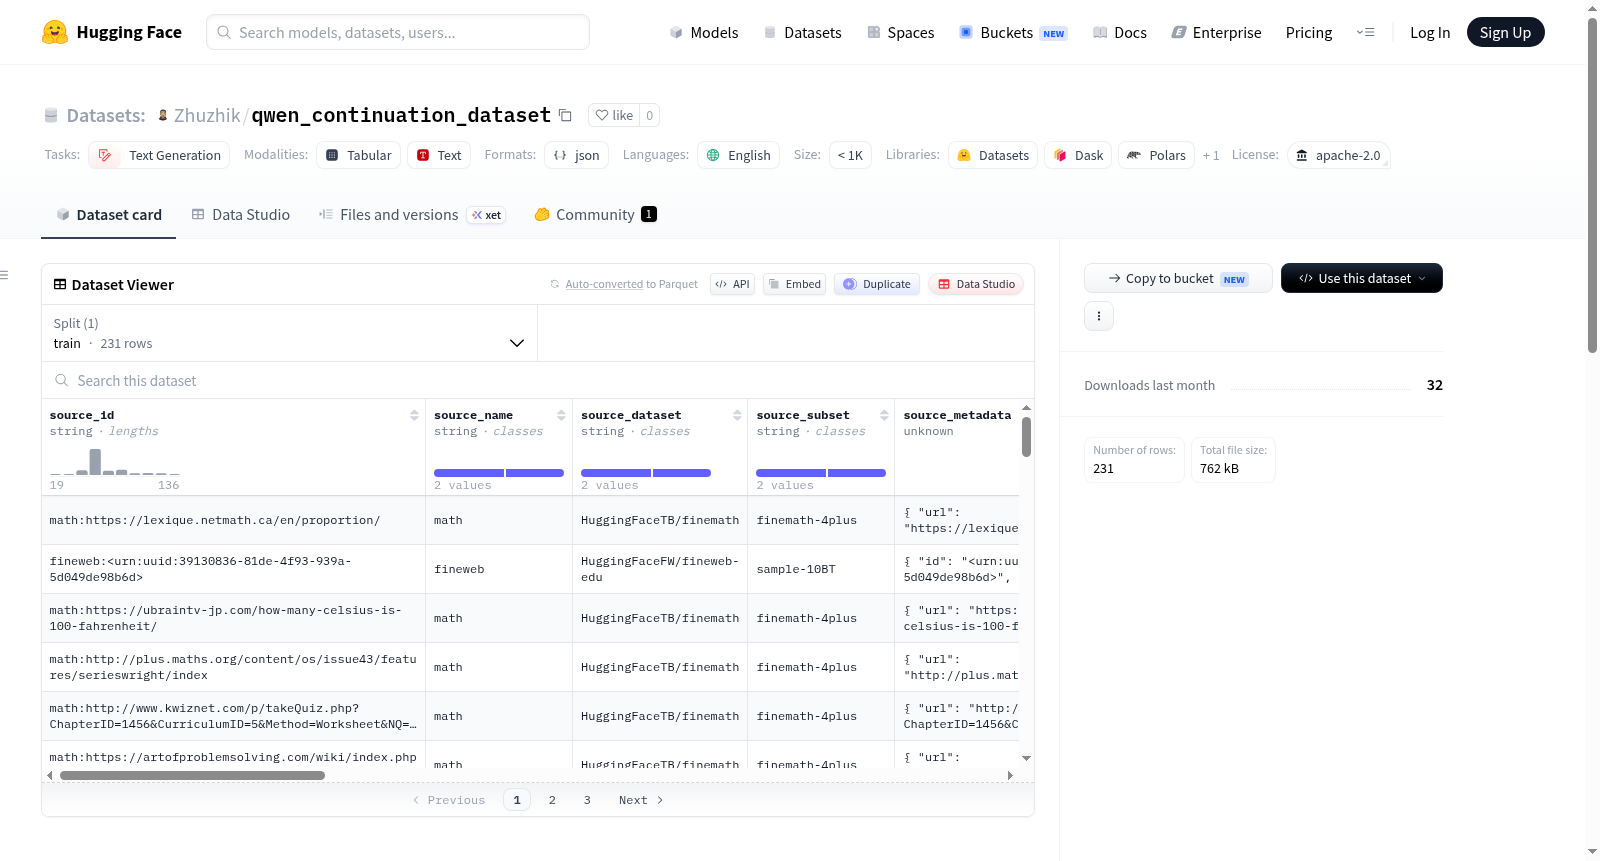
Qwen Continuation数据集是一个专门用于文本生成任务的英语数据集,旨在支持文本续写研究。该数据集包含235个示例,分为42个数据分片,采用Apache 2.0许可证。数据来源于fineweb和math两个原始数据集,每个样本包括7个关键字段:source_id(源文档ID)、source_name(源数据集名称)、prefix_text(输入前缀)、real_continuation(原始续写内容)、teacher_continuation(模型生成的续写内容)、synthetic_text(前缀与模型续写的组合文本)以及generation(生成设置和逐令牌熵信息)。该数据集适用于文本生成模型的训练、评估和续写质量对比分析等任务,特别适合研究模型生成文本与人类撰写文本之间的差异。数据以JSONL格式存储,可通过Hugging Face的datasets库直接加载使用。

The Qwen Continuation dataset is an English dataset specifically designed for text generation tasks, focusing on text continuation research. It contains 235 examples divided into 42 data splits and is licensed under Apache 2.0. The data is sourced from two original datasets: fineweb and math. Each sample includes 7 key fields: source_id (source document ID), source_name (source dataset name), prefix_text (input prefix), real_continuation (original continuation content), teacher_continuation (model-generated continuation content), synthetic_text (combined text of prefix and model continuation), and generation (generation settings and per-token entropy information). This dataset is suitable for tasks such as training and evaluating text generation models, as well as comparative analysis of continuation quality, particularly for studying differences between model-generated and human-written text. The data is stored in JSONL format and can be directly loaded using the Hugging Face datasets library.

创建时间:
2026-06-26
原始信息汇总

数据集概述

数据集名称:Qwen Continuation Dataset

许可证:Apache-2.0

语言:英语

任务类型:文本生成(text-generation)

数据集结构:默认配置(default),训练集以 JSONL 格式存储,路径为 data/*.jsonl

数据集规模

统计项 数值
分片数 42
样本总数 235
每个分片大小 1
更新日期 2026-07-05 14:47 UTC

数据字段说明

字段名 描述
source_id 源文档 ID
source_name 源数据集名称(finewebmath
prefix_text 输入前缀
real_continuation 原始数据集中的延续内容
teacher_continuation 模型生成的延续内容
synthetic_text 前缀 + 教师模型生成的延续内容
generation 生成设置及每个 token 的熵值

生成工具

该数据集使用 qwen_continuation_dataset 项目生成。

加载方式

python from datasets import load_dataset

常规加载

ds = load_dataset("Zhuzhik/qwen_continuation_dataset")

流式加载

ds = load_dataset("Zhuzhik/qwen_continuation_dataset", streaming=True)
搜集汇总
数据集介绍
qwen_continuation_dataset 数据集图片
构建方式
该数据集通过调用qwen_continuation_dataset项目中的自动化流水线构建而成。其核心思想是利用预训练语言模型作为教师模型,对来自FineWeb与Math等源数据集中的文本片段进行续写生成。具体而言,系统首先从源文档中提取前缀文本及其对应的真实续写,随后由教师模型生成替代性的续写内容,最终将前缀与模型生成的续写拼接形成合成文本。数据集的构建过程还记录了每一Token的生成熵与生成配置参数,为后续分析模型行为提供了元信息。全部数据以JSONL格式存储,共包含42个分片,总计235个样本,每个分片仅含一个样本,设计上便于分布式处理与流式加载。
特点
本数据集最显著的特征在于其对比性结构:每个样本同时包含来自原始文档的真实续写与模型生成的教师续写,为研究生成式语言模型与人类文本之间的差异提供了平行语料。字段设计中,`prefix_text`与`real_continuation`保留了源数据的原始连续性,而`teacher_continuation`与`synthetic_text`则代表了模型的语言理解与生成能力。此外,`generation`字段存储了生成过程中的逐Token熵值,可支撑关于模型不确定性、流畅度及创造性方面的定量分析。数据集规模虽小,但覆盖了通用网页文本与数学领域两种异质性来源,使其在领域迁移与模型校准研究上具备独特价值。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集。标准的本地加载方式为`load_dataset("Zhuzhik/qwen_continuation_dataset")`,获取全部235个样本。对于内存敏感或需要实时处理的场景,建议启用流式模式:`load_dataset("Zhuzhik/qwen_continuation_dataset", streaming=True)`,此时数据将按需读取而非一次性加载至内存。数据包含七个可直接使用的字段,其中`prefix_text`与`teacher_continuation`可构建输入-输出对用于微调,`real_continuation`可作为金标准用于评估生成质量,而`generation`字段中的熵值可用于过滤低质量样本或分析模型在不同前缀下的置信度分布。
背景与挑战
背景概述
Qwen Continuation Dataset 是由研究者 Teodorus 于2026年创建的一个面向文本生成任务的数据集,旨在利用大规模语言模型(如 Qwen)自动生成高质量的文本延续,以提升模型在上下文理解与生成连贯性方面的能力。该数据集基于 FineWeb 与数学类数据源,通过模型生成续写内容,形成“前缀-续写”结构,为语言模型的微调与评估提供了一种可扩展的合成数据构建范式。其诞生顺应了当前自然语言处理领域对大规模、多样化训练数据的需求,尤其在少样本学习与领域适应任务中展现出潜力。尽管规模较小(仅235个样本),但其强调的模型自生成数据策略已引起学界关注,为后续研究提供了方法参考。
当前挑战
该数据集面临的核心挑战在于:一是领域问题层面,文本生成任务亟需解决模型对长距离依赖的建模能力不足、续写内容逻辑一致性与事实准确性难以保障等问题,而当前数据集样本量极小(235条),难以覆盖复杂多样的语言现象与上下文场景;二是构建过程中,模型生成的续写可能引入噪声或重复模式,导致合成数据偏离真实分布,影响下游泛化性能;此外,数据来源仅涵盖网页文本与数学领域,存在领域偏置风险,且生成配置(如温度、熵值)的敏感性使得延续质量高度不稳定,增加了数据质量控制的难度。这些挑战限制了数据集在通用文本生成任务中的适用性与可信度。
常用场景
经典使用场景
在自然语言处理与生成式模型的交汇领域,Qwen Continuation Dataset专为文本延续任务设计,其经典使用场景在于训练和评估语言模型的前缀续写能力。通过提供多样化来源的片段前缀及对应的真实延续与模型生成延续,该数据集引导模型学习在给定上下文下生成连贯、语义一致的后续文本,是探索模型上下文理解与生成流畅性的基石资源。
衍生相关工作
基于该数据集,学术界衍生了多项经典工作,包括面向低资源领域的文本延续微调策略研究、通过对比学习优化前缀表示的方法探索,以及利用熵值分析模型生成不确定性的工作。部分研究者将其与强化学习结合,构建奖励模型以训练更鲁棒的续写器;另有工作聚焦于跨数据集迁移时的泛化能力评估,推动了文本生成领域从模型架构到训练范式的系统性创新。
数据集最近研究
最新研究方向
在当前大语言模型快速迭代的背景下,Qwen Continuation Dataset专注于探究模型生成式续写与原始文本之间的语义偏离与信息熵差异。该数据集基于FineWeb与Math两类异构语料,通过Qwen模型产生的教师续写与真实续写的对比,揭示了前沿研究中对模型幻觉检测与可控生成质量的深层关注。其核心价值在于为文本续写一致性、自回归生成中的不确定性量化及交叉域语义对齐提供基准评估,尤其对提升模型在复杂逻辑推理与知识密集型任务中的续写保真度具有指导意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

