
yapay_zeka_turkce_mmlu_model_cevaplari
收藏官方服务:
资源简介:
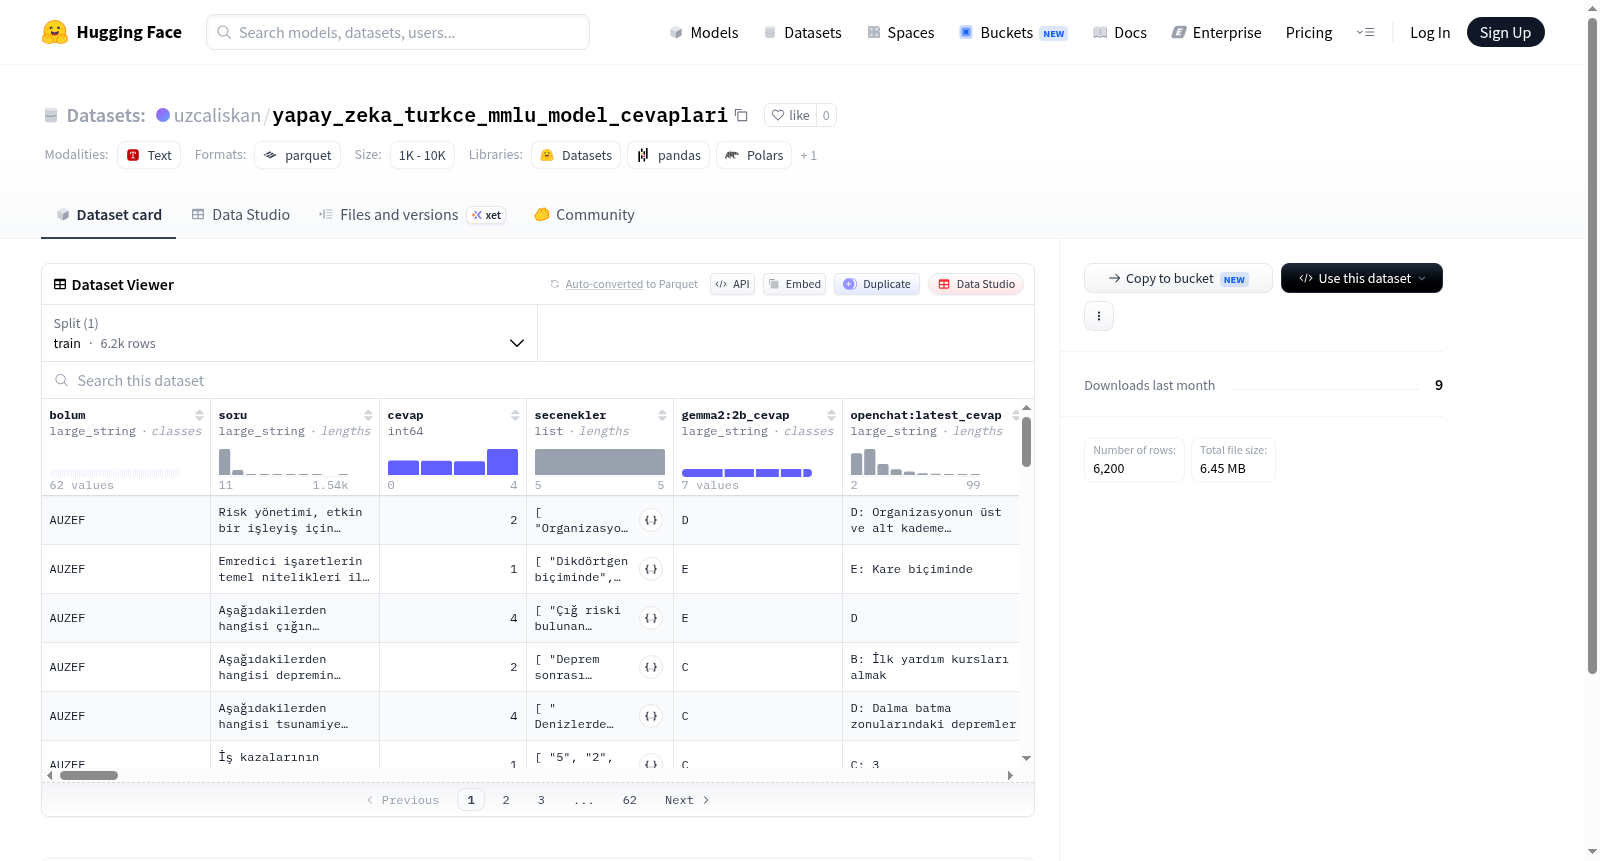
该数据集是一个用于评估和比较多个语言模型在土耳其语问答任务上性能的基准数据集。数据集的核心内容包括土耳其语的问题(soru)、选项列表(secenekler)以及正确答案(cevap,为整数索引)。此外,数据集还包含了大量不同语言模型对每个问题的预测答案,这些模型涵盖了广泛的开源模型(如Gemma、Llama、Qwen、Mistral、Phi等系列的不同版本)和商业模型(如GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Pro)。数据集中还包含一些专门针对土耳其语或特定领域(如医疗)微调的模型变体的答案。数据集规模为6200个样本,仅包含一个训练集分割。该数据集适用于自然语言处理研究,特别是多模型问答性能评估、模型答案一致性分析、土耳其语语言理解能力评测等任务。
创建时间:
2026-07-23
原始信息汇总
- 数据集名称:yapay_zeka_turkce_mmlu_model_cevaplari
- 数据集来源:Hugging Face,链接为 https://huggingface.co/datasets/uzcaliskan/yapay_zeka_turkce_mmlu_model_cevaplari
- 数据集描述:该数据集旨在记录多种语言模型(LLM)对土耳其语MMLU(大规模多任务语言理解)问题的回答,用于评估和比较不同模型在土耳其语问答任务上的表现。
- 数据集规模:包含6200个样本,数据集总大小为14,862,363字节(约14.2 MB),下载大小为6,443,659字节(约6.1 MB)。
- 数据划分:仅包含训练集(train)。
- 数据特征:每个样本包含以下字段:
bolum(部分/章节):文本类型soru(问题):文本类型cevap(正确答案):整数类型secenekler(选项):字符串列表- 多个模型回答字段(模型名称 +
_cevap后缀):文本类型,每个字段记录对应模型对同一个问题的输出。
- 参与的模型:数据集中记录了超过70个不同模型(包括本地模型和商业API模型)的答案,涵盖多种规模和变体,例如:
- 开源模型:Gemma系列(2b、9b、12b、27b等)、Llama系列(3、3.1、3.2、3.3)、Qwen系列(2.5、3)、Phi系列(3、3.5、4)、Mistral系列、DeepSeek-R1系列等
- 土耳其语微调模型:Turkcell-LLM-7b、Trendyol-LLM-8b、Kocdigital-LLM-8B、Defne-llama3.1-8B、Metin-LLaMA-3-8B-Instruct-TR-DPO、Morfoz-LLM-8b等
- 商业/API模型:GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Pro
- 其他变体:Aya系列、Doktor Llama、MedGemma、Cere-llama等
- 用途:适用于土耳其语自然语言处理研究,特别是多模型比较、模型评估、答案一致性分析等任务。
搜集汇总
数据集介绍
构建方式
该数据集基于土耳其语版本的MMLU(Massive Multitask Language Understanding)基准测试构建而成,旨在系统评估大语言模型在土耳其语语境下的多任务理解能力。数据集的构建过程首先从MMLU测试集中提取涵盖多个学科领域的题目,随后将每道题目呈现给一系列不同规模与架构的模型进行推理回答。每个样本包含题目所属的章节(bolum)、原始问题文本(soru)、标准答案(cevap)以及选项列表(secenekler)。更为关键的是,数据集为每个问题记录了数十种不同模型的原始输出,这些模型从轻量级如tinyllama到大规模如gemma3:27b,涵盖了通用模型、土耳其语定制模型以及GPT-4o、Claude等商用API模型,从而形成一个多模型响应并存的评测语料库。
特点
该数据集最鲜明的特色在于其多模型比较的架构设计,将同一个土耳其语MMLU问题与超过50种模型的回答进行关联存储,构建了一套标准化的横向对比基准。数据集中不仅包含了如gemma、llama、qwen等国际主流模型系列的不同版本,还专门集成了Trendyol-LLM、Kocdigital-LLM、Defne-llama3.1-8B、Metin-LLaMA-3-8B-Instruct-TR-DPO等一系列针对土耳其语进行微调或优化的本地化模型,以及GPT-4o、Claude-3.5-Sonnet、Gemini-1.5-Pro等商业模型在土耳其语任务上的表现。这种异构模型覆盖范围使得研究者能够系统性地观察不同模型在土耳其语理解任务上的能力差异、偏差模式以及语言适应性。
使用方法
该数据集可便捷地通过Hugging Face Datasets库进行加载,用户只需指定数据集名称即可获取训练集,数据以标准表格形式呈现。研究者可基于数据集中的'bolum'字段进行特定学科领域的筛选分析,例如区分人文、科学或工程等子集,探究模型在不同知识领域的表现。利用模型中各模型对应字段(如gpt-4o_cevap、llama3.2:latest_cevap等)与标准答案'cevap'的比对,可计算每类模型的正确率、错误分布以及回答模式。此外,该数据集也支持对模型回答的文本分析,如回答长度、语言一致性、推理质量评估等。研究者还可将不同模型的输出降维可视化,揭示模型间的相似性与集群特征。
背景与挑战
背景概述
yapay_zeka_turkce_mmlu_model_cevaplari数据集诞生于对土耳其语大语言模型评估的迫切需求之中,由土耳其本土研究机构主导构建。其核心研究问题在于系统性地评测多种开源与商业大模型在土耳其语MMLU(大规模多任务语言理解)基准上的表现,涵盖从轻量级模型(如gemma3:1b)到大规模模型(如gemma3:27b)的广泛谱系。该数据集收录了超过60种模型在6200道土耳其语题目上的回答,为土耳其语自然语言处理领域提供了首个大规模的模型性能对比基准,对推动低资源语言大模型的发展与评估具有里程碑式的影响力。
当前挑战
数据集所解决的领域挑战在于土耳其语作为低资源语言,长期缺乏标准化的大模型评估框架,现有MMLU基准多聚焦于英语,难以反映模型在土耳其语上的真实能力。构建过程中面临的核心挑战包括:需要收集并适配涵盖多学科的土耳其语测试题,确保题目翻译与文化语境的本土化;协调数十种不同架构与版本的模型进行本地推理,保障实验条件的一致性;以及处理不同模型输出格式的异构性问题,建立统一且可比的评判标准,从而生成可靠的多模型对照评估数据。
常用场景
经典使用场景
在自然语言处理与多语言大模型评估领域,yapay_zeka_turkce_mmlu_model_cevaplari 数据集为研究者提供了一座横跨语言与知识的桥梁。该数据集基于土耳其语版本的 MMLU(大规模多任务语言理解)基准构建,核心设计在于收集数十种开源及商业大语言模型在数千道涵盖科学、人文、工程等多学科题目上的回答,形成了一组结构化的模型输出集合,因而尤为适合用于跨模型、跨尺寸、跨版本的土耳其语知识推理能力横向对比研究。
实际应用
在工业界与工程实践中,yapay_zeka_turkce_mmlu_model_cevaplari 数据集扮演着客观的模型选型向导角色。企业或研究机构若需在土耳其语场景下部署智能客服、教育评测、知识问答系统,可借助该数据集的模型回答记录,直观对比不同尺寸模型(如从 0.5B 参数的小模型到 35B 参数的大模型)的实际表现,进而权衡推理成本与回答质量,做出数据驱动的模型选择决策,显著降低土耳其语应用开发中的试错成本。
衍生相关工作
该数据集的发布直接催生了一系列围绕土耳其语大模型诊断与改进的衍生工作。基于其中丰富的模型出错模式分析,研究者得以开发针对土耳其语语义误解、知识缺失的定向微调和提示优化方法;同时,该数据集已成为土耳其语模型竞赛和基准排行榜的权威参考资源,促使多个本地化大模型(如 Trendyol-LLM、Turkcell-LLM 等)以之为标杆迭代版本。长远来看,这一系统性评估范式亦为其他低资源语言构建同类评测数据集提供了可复制的方法论模板。
以上内容由遇见数据集搜集并总结生成


