
遇见数据集

Pleaze/fin-alpaca-deepseek-r1-qwen-7b

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

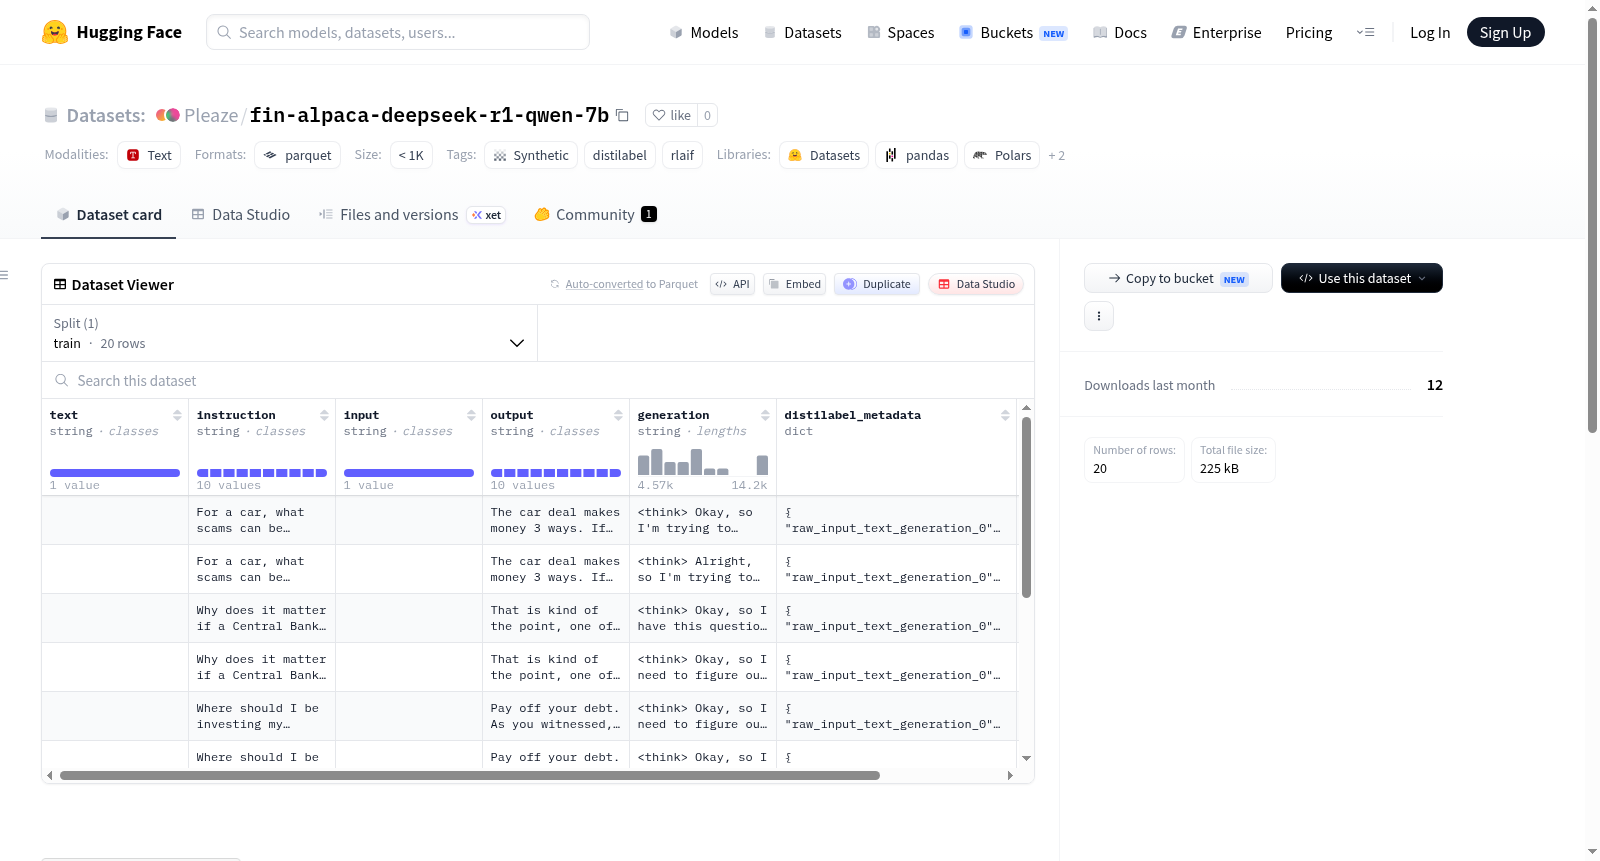
该数据集名为fin-alpaca-deepseek-r1-qwen-7b,由Distilabel工具生成,包含20个训练样本。数据集中每个样本包括多个字段:文本(text)、指令(instruction)、输入(input)、输出(output)、生成内容(generation)、Distilabel元数据(distilabel_metadata)和模型名称(model_name)。示例内容显示,数据集主要涉及汽车金融领域的问答,具体探讨0%融资与返利可能涉及的诈骗手段,并包含模型生成的详细推理过程。数据集可能用于指令微调或评估大型语言模型在金融诈骗分析方面的能力。

The dataset named fin-alpaca-deepseek-r1-qwen-7b is created using Distilabel and contains 20 training examples. Each example includes multiple fields: text, instruction, input, output, generation, distilabel_metadata, and model_name. The sample content indicates that the dataset focuses on Q&A in the automotive finance domain, specifically exploring potential scams related to 0% financing versus rebates, with detailed reasoning generated by the model. The dataset is likely intended for instruction tuning or evaluating large language models in financial scam analysis.
提供机构:
Pleaze
搜集汇总
数据集介绍
Pleaze/fin-alpaca-deepseek-r1-qwen-7b 数据集图片
构建方式
该数据集基于Distilabel框架构建,通过合成数据生成管道,利用DeepSeek-R1-Distill-Qwen-7B模型对金融领域指令进行响应。数据集的创建流程完整记录在pipeline.yaml文件中,可通过Distilabel CLI工具复现。具体而言,系统接收金融相关指令(如关于汽车贷款诈骗的分析),引导模型进行逐步推理并输出结构化思考过程与最终答案。每条样本包含原始用户输入、模型生成的思考链及最终输出,并附带详细的元数据,包括输入输出token统计、模型名称等信息。数据集规模较小,仅含20条训练样本,旨在作为金融推理数据的轻量级基准。
使用方法
使用者可直接通过HuggingFace Datasets库加载数据集,调用默认配置的train划分即可获得20条样本。每条样本以字典形式呈现,包含text、instruction、input、output、generation及distilabel_metadata等字段。若要复现数据生成流程,可运行`distilabel pipeline run --config "<pipeline.yaml的URL>"`命令。该数据集适用于金融领域大语言模型推理能力的评估与微调,特别是利用其思考链字段进行思维链蒸馏或偏好学习。研究者亦可依托其结构化元数据,对比不同模型在相同金融指令下的推理模式差异。
背景与挑战
背景概述
随着金融领域对大语言模型推理能力的日益重视,如何高效构建具备深度思考能力的金融问答数据集成为关键挑战。在此背景下,Qucy等人于2024年利用distilabel框架,融合DeepSeek-R1-Distill-Qwen-7B模型的思维链(Chain-of-Thought)特性,创建了fin-alpaca-deepseek-r1-qwen-7b数据集。该数据集专注于汽车金融场景中的欺诈识别问题,以0%融资与现金返利为切入点,引导模型逐步推理金融交易中的潜在风险。尽管规模仅含20个样本,但其独特的结构化设计——包含指令、输入、输出及生成长链推理——为金融领域的大模型对齐与风险分析提供了高质量基准。数据集通过synthetic和rlaif标签标注,强调了合成数据与人工反馈结合的创新路径,对金融NLP的推理增强研究具有重要推动作用。
当前挑战
该数据集所解决的领域问题聚焦于金融交易中欺诈行为的识别与推理,然而金融术语的模糊性、交易结构的复杂性以及欺诈手段的隐蔽性,使得模型难以精准捕捉多方利益博弈的本质。例如,0%融资与返利之间的权衡涉及利率计算、时间价值与心理账户等多维因素,当前的少量样本难以覆盖所有欺诈变体。在构建过程中,数据生成依赖单一模型(DeepSeek-R1-Distill-Qwen-7B)的思维链,可能引入输出偏差或推理短路;同时,distilabel管道虽实现了自动化链式生成,但人类标注的缺失可能导致关键语义的遗漏。此外,模型输出的冗余性(如长篇幅思考过程)与示例的稀缺性,为后续微调与评估的泛化带来了挑战。
常用场景
经典使用场景
在金融领域的自然语言处理研究中,fin-alpaca-deepseek-r1-qwen-7b数据集被广泛用于训练和评估大语言模型在金融问答、推理和对话生成方面的能力。该数据集包含20条高质量的金融指令样本,每条样本均包含用户提问、模型推理过程(包含长篇链式思考)和最终答案,为金融领域的指令微调提供了宝贵的训练材料。典型使用场景包括金融知识问答、金融诈骗识别分析、贷款与融资方案比较等复杂金融问题的推理任务,研究者可利用这些数据来提升模型在金融场景下的逻辑推理和专业知识应用能力。
解决学术问题
该数据集有效解决了金融领域大语言模型研究中缺乏高质量、可复现的指令微调数据的问题。传统的金融NLP研究多依赖于通用领域数据集或小规模人工标注数据,难以充分支撑模型在金融场景下的深度推理与专业知识应用。fin-alpaca-deepseek-r1-qwen-7b通过提供包含完整链式思考过程(chain-of-thought)的金融问答对,使研究者能够探索模型在金融决策推理、风险识别和产品比较等复杂任务上的表现。其意义在于为金融领域的大模型研究树立了一个可复现的基准,推动了金融智能化研究的进程。
实际应用
在实际应用中,基于fin-alpaca-deepseek-r1-qwen-7b数据集训练的模型可被部署于金融科技平台的智能客服系统,用于解答用户关于汽车贷款零利率与现金回扣的优劣比较、金融产品诈骗识别等专业问题。此外,该数据还可用于开发金融知识辅助工具,帮助消费者理解复杂的金融条款与潜在风险。金融机构也可利用微调后的模型进行内部培训材料的自动生成,提升从业人员对金融诈骗手段的识别能力,从而降低运营风险。
数据集最近研究
最新研究方向
在金融与语言模型交叉领域,fin-alpaca-deepseek-r1-qwen-7b数据集聚焦于利用深度求索推出的推理增强型模型DeepSeek-R1-Distill-Qwen-7B,通过蒸馏技术生成高质量、包含逐步推理链条的金融领域指令数据。其前沿研究方向体现在利用合成数据与RLHF(基于人类反馈的强化学习)方法,探索模型在复杂金融场景(如欺诈识别、风险评估)中的因果推理与多步逻辑拆解能力,契合生成式AI在垂直行业落地中对可解释性与透明度日益增长的需求。该数据集的小规模(20条样本)与精密标注结构,为微调语言模型在金融问答中的严苛准确性提供了基准,并推动了‘蒸馏-推理’范式在专业领域的应用,对构建可信金融智能助手具有重要示范意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

