
Epistchemology/FlowER_grpo
收藏官方服务:
资源简介:
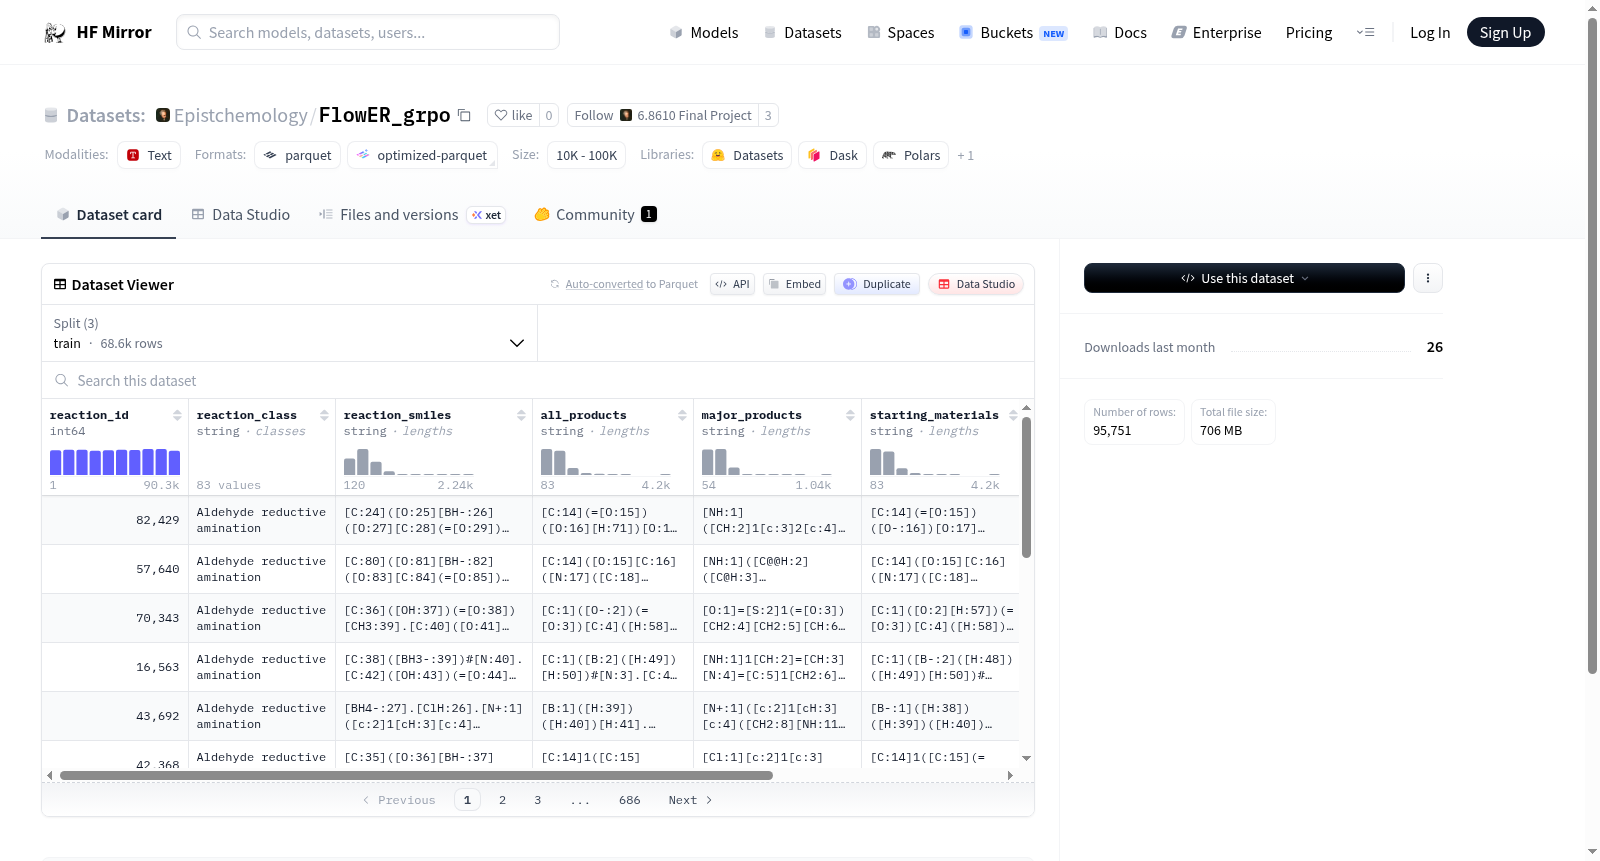
该数据集包含化学反应相关的详细信息,主要特征包括反应ID、反应类别、反应SMILES表达式、所有产物、主要产物、起始材料、注释步骤和机制步骤列表。数据集分为训练集、验证集和测试集,分别包含68595、913和26243个样本。文件大小和下载大小也有详细说明。
This dataset contains detailed information about chemical reactions, including features such as reaction ID, reaction class, reaction SMILES, all products, major products, starting materials, annotated steps, and mechanism step lists. The dataset is divided into training, validation, and test sets, containing 68,595, 913, and 26,243 samples respectively. File sizes and download sizes are also detailed.
提供机构:
Epistchemology搜集汇总
数据集介绍
构建方式
FlowER_grpo数据集是面向有机化学反应机理预测任务精心构建的大规模结构化资源,其数据源自权威化学反应数据库,经自动化流程提取与人工校验整理而成。每条记录均涵盖反应唯一标识(reaction_id)、反应类别标签(reaction_class)、标准SMILES表达的反应式(reaction_smiles),以及明确区分的所有产物(all_products)、主要产物(major_products)与起始物料(starting_means)。进一步地,数据集中嵌入了注释步骤(annotated_steps)与机理步骤列表(mech_step_list),后者以浮点数值序列刻画反应路径的逐步演变,从而将静态反应式转化为动态的、分步的机理信息链,为深度模型学习反应的内在推理逻辑奠定了坚实的数据基础。
特点
该数据集最显著的特点在于其层级化与结构化并重的设计哲学。它不仅提供了传统的反应类别与分子式信息,更首创性地引入了注释步骤与步进式机理向量,将反应拆解为可学习的离散与连续信息序列,使得模型能够超越简单的产物预测,深入理解电子转移、键断裂与形成等微观机理。数据规模庞大,训练集包含68,595条样本,验证集与测试集分别有913条与26,243条,分布合理,适应于现代深度学习模型的训练与评估需求。各类字段类型明确,涵盖整型、字符串与嵌套浮点列表,展现了丰富的语义层次与数值精度。
使用方法
FlowER_grpo数据集专为化学反应机理预测与生成任务设计,可用于训练图神经网络、序列模型或混合架构,以从反应物推导出完整的阶梯式机理。使用者可通过HuggingFace Datasets库按'class'配置加载,其默认划分出train、val、test三个子集,便于进行标准化的模型训练、超参数调优与性能评估。在应用中,可选取reaction_smiles与starting_materials作为输入特征,all_products与major_products作为监督目标,或进一步利用mech_step_list作为序列标注任务的标签。数据以Parquet格式存储,支持高效流式读取与子集采样,适用于大规模分布式训练场景。
背景与挑战
背景概述
FlowER_grpo数据集由研究团队在近期创建,聚焦于有机化学反应机理预测与逆合成分析这一核心研究问题。该数据集以反应分类(class)为配置,包含近7万条训练样本、900余条验证样本及2.6万余条测试样本,覆盖了反应编号、反应类别、SMILES表达式、产物、起始物料及详细的机理步骤等丰富信息。其发布为化学信息学领域提供了标准化的大规模反应数据资源,推动了基于深度学习的反应预测模型发展,尤其在自动推断反应路径与条件优化方面具有重要影响力。
当前挑战
该数据集面临的挑战主要源于化学反应本身的复杂性与数据构建的精细度要求。在领域问题层面,反应机理预测需处理多步反应网络中的中间体选择、副反应干扰及立体化学效应,现有模型难以准确泛化至稀有反应类型。在构建过程中,数据清洗与标注面临SMILES表示的二义性、反应条件缺失以及专家手动注释机理步骤的主观差异性,这些因素限制了数据集的规模扩展与跨系统通用性。
常用场景
经典使用场景
FlowER_grpo数据集为有机化学反应机理预测与逆合成分析领域提供了结构化的标注数据资源。该数据集将化学反应以SMILES字符串形式呈现,并包含反应类别、起始原料、主产物及完整的反应步骤注释,特别适用于训练基于序列到序列模型的反应预测系统。研究者可借助该数据集的注释步骤与机理步骤向量,构建从反应物到产物的端到端预测模型,或基于反应类别信息进行反应类型分类任务的探索。
实际应用
在实际场景中,FlowER_grpo可辅助药物研发领域的合成路线自动化设计,帮助化学家快速甄别具有可行性的反应方案。通过集成至计算机辅助合成规划系统,该数据集能显著降低人工实验试错的成本,尤其适用于复杂天然产物或候选药物分子的高效合成。同时,其在化工生产过程优化中也可发挥潜力,通过预测副产物分布来指导绿色化学反应条件的筛选。
衍生相关工作
基于FlowER_grpo数据集的特性,衍生了一系列经典研究,包括利用图神经网络编码反应模板进行单步产物预测的工作,以及结合强化学习策略优化多步逆合成路径的模型。此外,有研究采用该数据集的反应类别标注,开发了基于对比学习的反应类型判别框架,显著提升了跨类别反应迁移的泛化能力。这些工作共同拓展了数据驱动化学合成的基础方法论体系。
以上内容由遇见数据集搜集并总结生成


