TingChen-ppmc/Nanchang_Dialect_Conversational_Speech_Corpus
收藏资源简介:
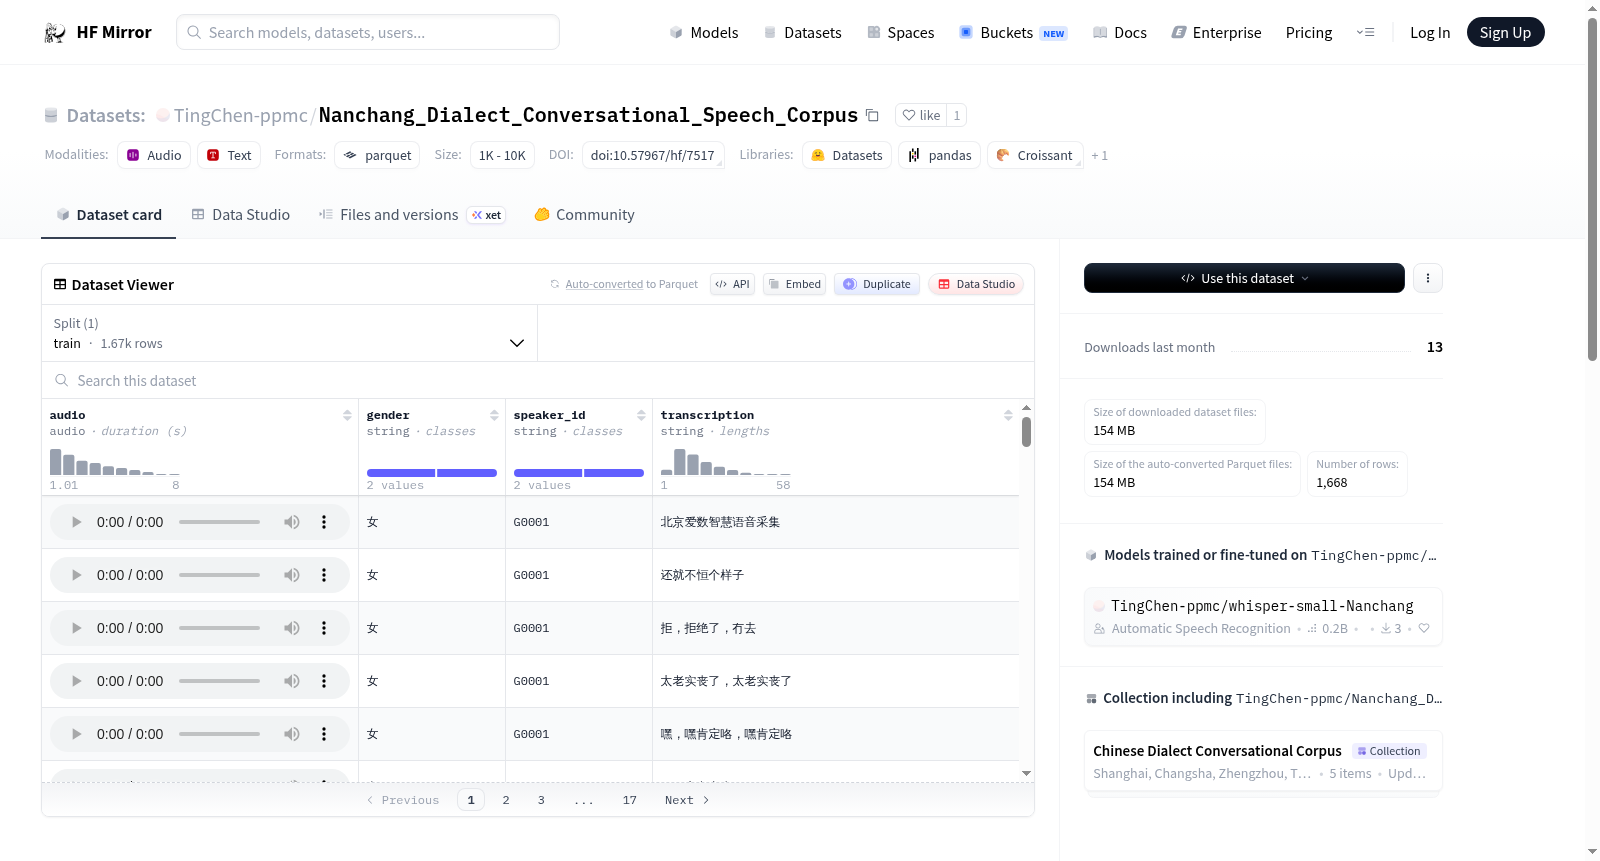
该数据集来源于Magicdata的ASR-CNANDIACSC,即南昌方言对话语音语料库。数据集中的音频根据转录文件中的时间跨度被分割成句子,且持续时间少于1秒的句子被丢弃。对话的主题已被移除。数据集包含音频、性别、说话者ID和转录文本等特征,并且只有训练集。数据集的使用方法包括加载数据集和分割出测试集。
该数据集来源于Magicdata的ASR-CNANDIACSC,即南昌方言对话语音语料库。数据集中的音频根据转录文件中的时间跨度被分割成句子,且持续时间少于1秒的句子被丢弃。对话的主题已被移除。数据集包含音频、性别、说话者ID和转录文本等特征,并且只有训练集。数据集的使用方法包括加载数据集和分割出测试集。
数据集概述
数据集信息
特征
- audio: 音频数据
- gender: 说话人性别
- speaker_id: 说话人ID
- transcription: 语音转录文本
数据分割
- train: 训练集,包含1668个样本,大小为151062019.576字节
数据集大小
- download_size: 154068613字节
- dataset_size: 151062019.576字节
配置
- config_name: default
- data_files:
- split: train
- path: data/train-*
数据集加载
加载数据集
python from datasets import load_dataset dialect_corpus = load_dataset("TingChen-ppmc/Nanchang_Dialect_Conversational_Speech_Corpus")
分割测试集
python from datasets import load_dataset train_split = load_dataset("TingChen-ppmc/Nanchang_Dialect_Conversational_Speech_Corpus", split="train")
其中test=0.5表示0.5的数据将被分割到测试集
corpus = train_split.train_test_split(test=0.5)
示例数据
python { audio: { path: A0001_S001_0_G0001_0.WAV, array: array([-0.00030518, -0.00039673, -0.00036621, ..., -0.00064087, -0.00015259, -0.00042725]), sampling_rate: 16000 }, gender: 女, speaker_id: G0001, transcription: 北京爱数智慧语音采集 }