UniProtKB
收藏资源简介:
UniProtKB Processed是一个经过处理的蛋白质序列数据集,源自LiteFold/UniProtKB的FASTA分片,基于UniProtKB数据库。该数据集为蛋白质特征提取任务提供结构化的、已分割好的数据,处理流程包括解析FASTA头信息、计算序列SHA-256哈希值、分配确定性的训练/验证/测试分割,并输出为可查询的表格文件。数据集规模庞大,包含1亿至10亿个样本,每个样本代表一个UniProtKB FASTA记录,包含记录标识符、蛋白质名称、生物体名称、分类学ID、基因名称、序列长度、序列哈希值、来源数据库和数据分割信息等字段。数据分割基于序列哈希值确定性分配,默认比例为80%训练集、10%验证集和10%测试集,确保相同序列总在同一子集。数据集以JSONL压缩格式存储,附有元数据和统计摘要文件,适用于蛋白质序列分析和机器学习任务,采用CC BY 4.0许可证。
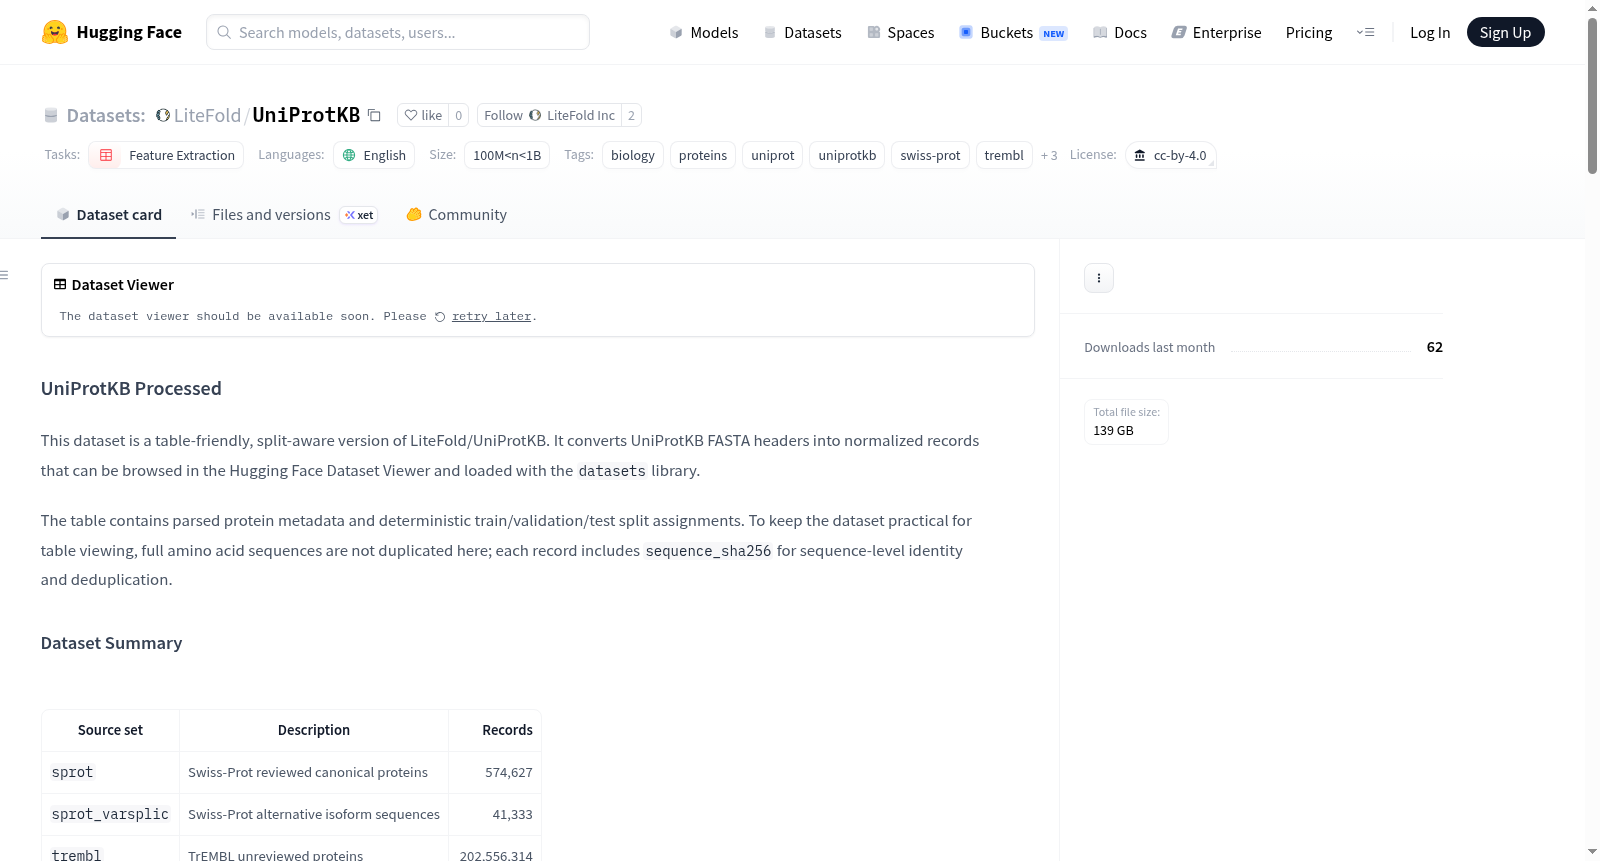
UniProtKB Processed is a processed protein sequence dataset derived from LiteFold/UniProtKB FASTA shards, which are built upon the UniProtKB database. This dataset provides structured, pre-split data for protein-related feature extraction tasks. The processing pipeline includes parsing UniProt FASTA headers, computing exact SHA-256 hashes for amino acid sequences, assigning deterministic train/validation/test splits, and finally outputting queryable tabular files. The dataset is large-scale, containing 100 million to 1 billion samples. Each data row represents a UniProtKB FASTA record with rich fields such as record identifier (record_id, accession), protein name, organism name, taxon ID, gene name, sequence length, sequence SHA-256 hash, source database, and split information (split, split_group). Data splits are deterministically assigned based on sequence hash, with a default ratio of 80% training, 10% validation, and 10% test sets, ensuring identical protein sequences are always placed in the same subset. The dataset is stored in JSONL compressed format with accompanying processing metadata and statistical summary files. It is suitable for bioinformatics tasks like protein sequence analysis and machine learning model training/evaluation, and is licensed under CC BY 4.0.