
gmikros/kathnlp-treebank
收藏官方服务:
资源简介:
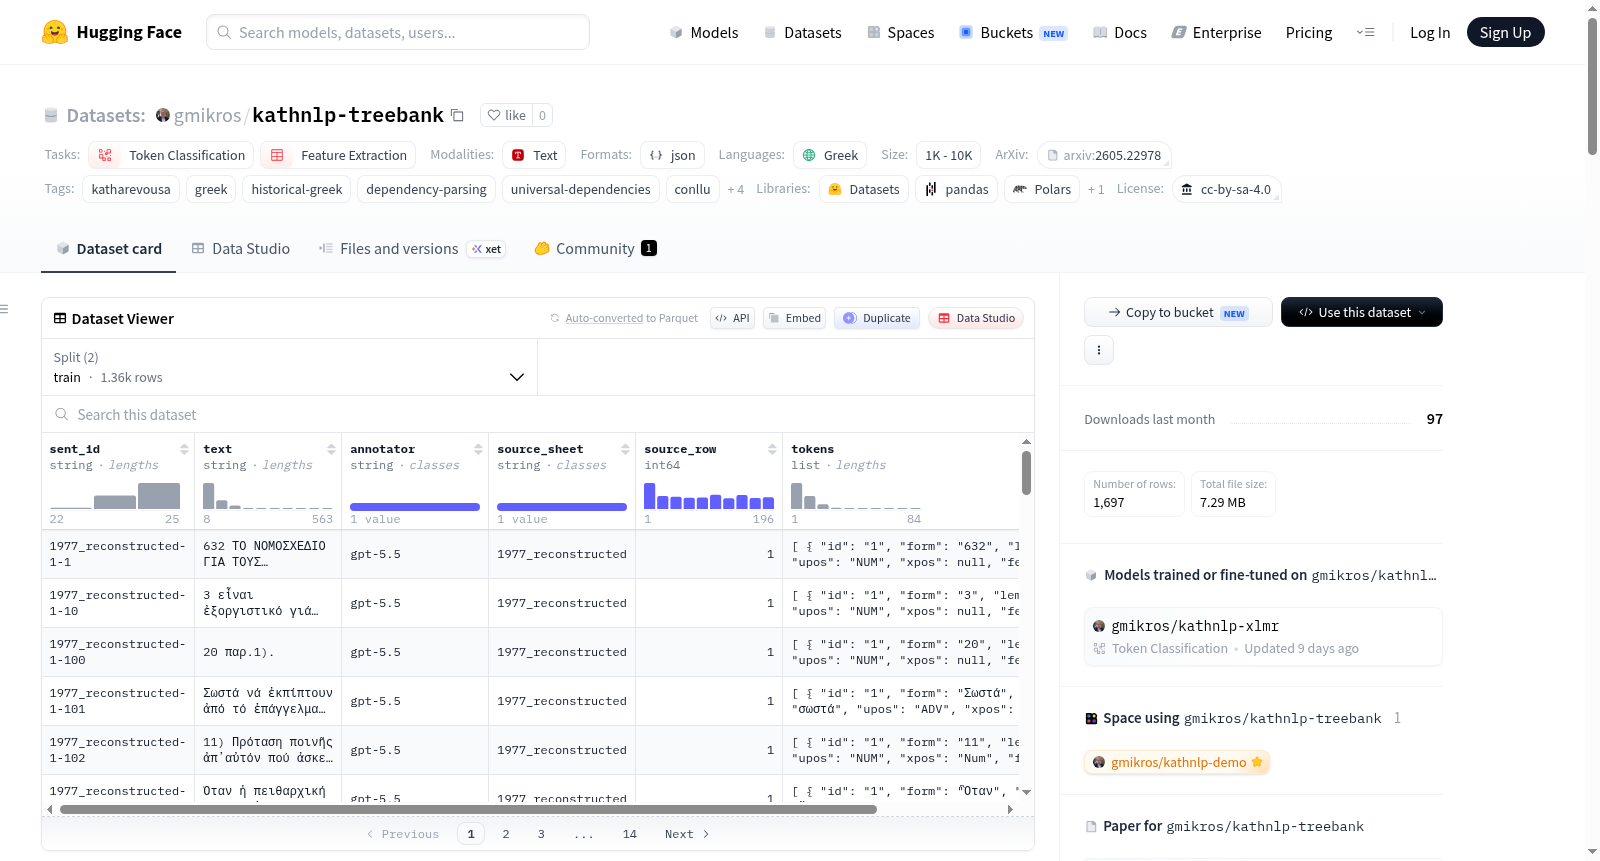
一个用于Katharevousa Greek(20世纪希腊法律、行政和议会话语中使用的古语化官方注册)的Universal-Dependencies风格参考树库。该树库涵盖了早期第三希腊共和国(1976-1977年)书面议会问题中的1,697个句子,并随[`kathnlp`](https://github.com/gmikros/katharevousa-nlp-tooling)解析管道一起发布。
A Universal-Dependencies-style reference treebank for **Katharevousa Greek**, the archaizing official register used in 20th-century Greek law, administration, and parliamentary discourse. The treebank covers 1,697 sentences from written parliamentary questions of the early Third Hellenic Republic (1976–1977) and is released alongside the [`kathnlp`](https://github.com/gmikros/katharevousa-nlp-tooling) parsing pipeline.
提供机构:
gmikros搜集汇总
数据集介绍
构建方式
该数据集基于希腊议会1976至1977年间书面质询的历史档案构建,原始文档经OCR技术数字化处理,并针对词内连字符与换行伪影进行了重建。语料库的标注采用架构约束的大语言模型辅助方法,利用GPT-5系列模型生成结构化JSON输出,并辅以自动验证、重试队列与确定性快照机制。最终收录1697个句子,其中1565句来自主批次流程,132句为经重试替换后通过验证的样本。
特点
作为首个为Katharevousa希腊语设计的通用依赖树库,该数据集聚焦于20世纪希腊法律、行政与议会话语中的典雅正式语域。其独特之处在于严格遵循通用依赖关系v2标注体系,并保留了源档案中的多调正字法与单调正字法变体。数据规模虽小(训练集1357句、测试集340句),但采用固定种子42划分,确保实验可重复性,且涵盖不同模型的基准测试报告。
使用方法
用户可通过Hugging Face的datasets库直接加载,使用`load_dataset("gmikros/kathnlp-treebank")`获取预划分的训练与测试集。亦可从Hugging Face Hub下载原始CoNLL-U格式文件,借助`hf_hub_download`函数获取`train.conllu`或`test.conllu`,以便与传统的自然语言处理工具链集成。该数据集同时提供JSONL格式,便于通过数据集查看器浏览单句结构化词元信息。
背景与挑战
背景概述
近代希腊语经历了从纯净语(Katharevousa)向通俗语(Demotic)的深刻转型,而纯净语作为20世纪希腊法律、行政及议会话语中的官方雅化语体,其语言资源极其匮乏,鲜有数字化语料库可供自然语言处理研究。在此背景下,由George Mikros与Fotios Fitsilis等学者于2026年创建的Katharevousa希腊语树库(kathnlp-treebank),旨在为这一历史语言变体提供首个通用依存关系(Universal Dependencies)风格的参考树库。该数据集精选了1,697句来自第三届希腊共和国初期(1976–1977年)的议会书面质询文本,并配套开发了可复现的解析流水线。作为低资源历史语言处理领域的标志性成果,其诞生不仅填补了纯净语依存句法资源的空白,也为探究希腊语语言演变与计算分析架设了关键桥梁。
当前挑战
该数据集所应对的核心领域挑战在于,纯净语作为兼具古典雅致与官方正式性的历史语言变体,长期缺乏高质量、标准化的标注语料库,导致依存句法分析、词性标注等任务面临零资源困境。数据构建过程中亦遭遇多重技术障碍:原始档案源自20世纪70年代的手动打印议会文件,需透过OCR技术处理总计1,674页图像/1,338个问题的庞大巨量,并克服字内连字符与换行伪影带来的重建难题(最终字符识别准确率达98.7%);标注环节采用大语言模型辅助的自动化方案,虽通过结构验证与重试机制保证了1,565句主批次、132句重试替换件的稳定产出,但因缺乏完整的专家仲裁,标注质量尚存优化空间;此外,受限于仅340句的保留测试集规模与单一的议会文本体裁,数据集的泛化能力与代表性仍有待后续扩展。
常用场景
经典使用场景
kathnlp-treebank 数据集的核心应用场景在于赋能低资源历史语言变体的依存句法分析与词性标注任务。作为首个面向 Katharevousa Greek 的 Universal Dependencies 风格树库,其涵盖 1,697 句来自 1976–1977 年希腊议会书面质询的文本,为古典式现代希腊语的自然语言处理提供了标准化的参照基准。研究者可利用该数据集训练和评估依存解析器、序列标注模型,或将其作为跨时期希腊语迁移学习的桥梁,从而推动低资源语言场景下句法分析能力的提升。
衍生相关工作
围绕 kathnlp-treebank 已衍生出一系列具有影响力的学术工作。其配套论文描述了完整的数据构建流程与基准评测协议,报告了多种模型(包括 spaCy、Stanza、mBERT、XLM-R 等)在依存句法分析任务上的性能表现。结合其开源解析管线 kathnlp,研究者可复现并扩展不同模型的对比实验。此外,该数据集与 ICDAR 2024 中介绍的希腊议会档案数字化工作形成互补,共同推动了历史文档分析与低资源自然语言处理的交叉研究,为后续构建更大规模的历史语料树库奠定了方法论基础。
数据集最近研究
最新研究方向
在低资源历史语言处理领域,Katharevousa希腊语树库的推出开辟了极具特色的前沿方向——将通用依存句法分析范式引入近代官方书面语,尤其是20世纪希腊议会文献这一特定体裁。当前研究热点聚焦于:利用LLM辅助标注(如GPT-5系列)与确定性快照机制构建高质量参考树库,结合spaCy、Stanza、mBERT、XLM-R等多模型基准测试,系统评估古典与近代希腊语在句法分析任务上的迁移学习表现。该数据集填补了卡萨雷乌萨语——这一兼具古典典雅性与现代行政职能的“半人造”语言——在通用依存关系框架下的资源空白,其对多调正字法保留与OCR重建流程(基于YOLOv5与Calamari-OCR,达98.7%字符精度)的透明度记录,为数字人文与低资源NLP的可复现研究树立了标杆,也为后续专家校订版迭代奠定了谱系基础。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


