
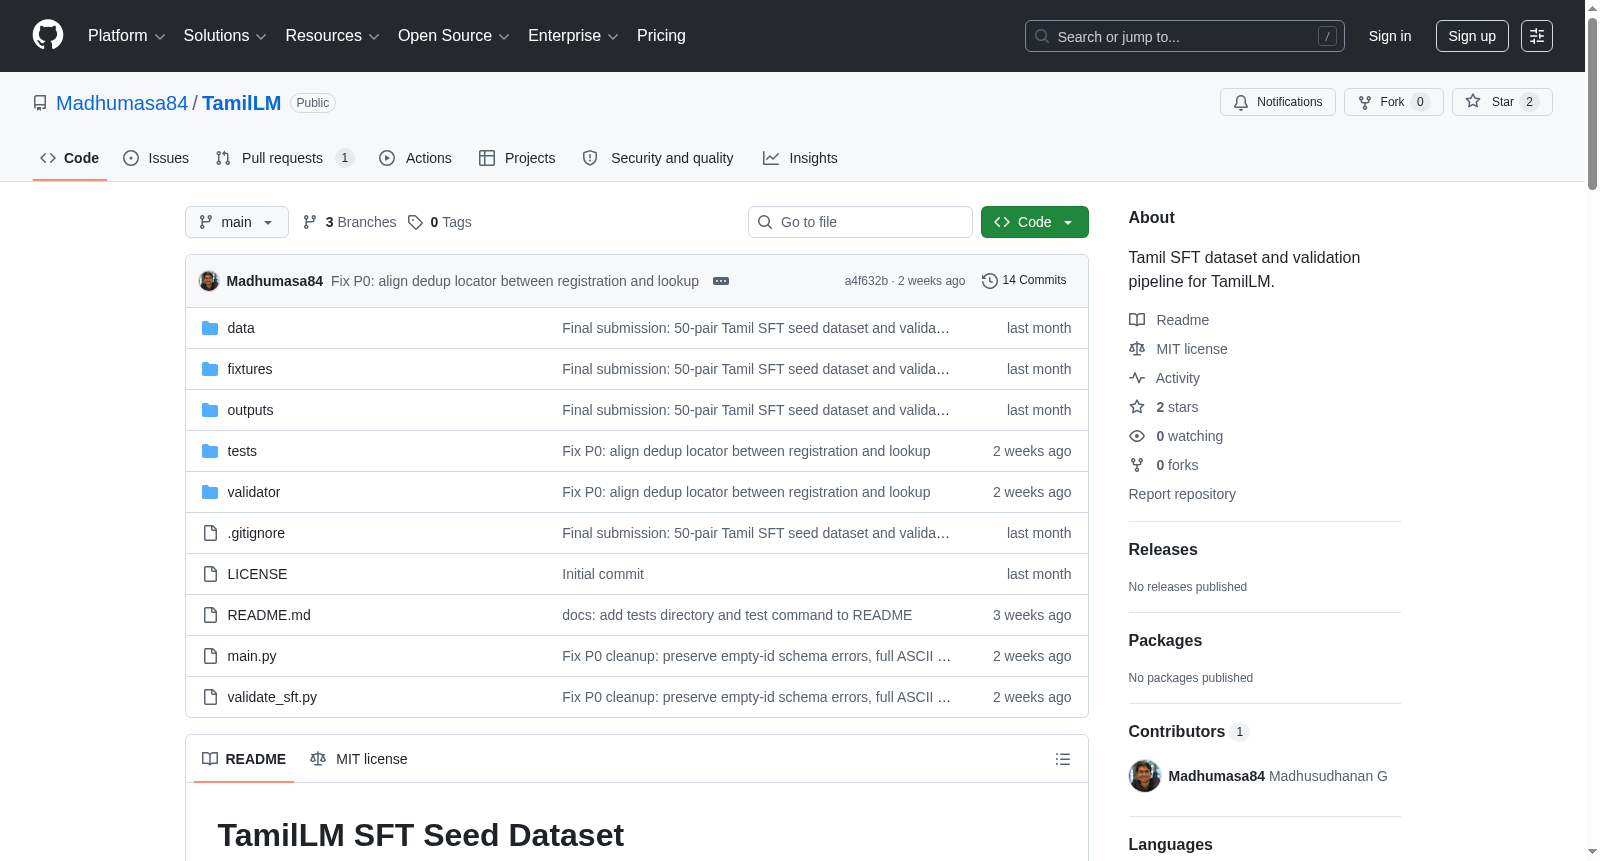
TamilLM SFT Seed Dataset
收藏数据链接:
官方服务:
资源简介:
一个包含50对泰米尔语指令调优种子数据集和验证流程,用于TamilLM(从头开始的泰米尔语第一语言模型)。数据集强调真实用户输入,包括口语化、正式和文学三种语域,并包含代码混合和方言变体。
This dataset consists of 50 pairs of Tamil instruction-tuning seed samples and a validation pipeline, designed for TamilLM—a native Tamil language model built entirely from scratch. The dataset emphasizes authentic user inputs, encompassing three distinct registers: colloquial, formal, and literary, and additionally incorporates code-mixing content and dialectal variants.
创建时间:
2026-06-02
原始信息汇总
数据集概述:TamilLM SFT Seed Dataset
该数据集是一个用于 TamilLM(一个从头训练的泰米尔语优先语言模型)的指令微调种子数据集,包含 50 对 泰米尔语指令-响应对,并附带一个验证管道。
核心设计
- 设计哲学:以泰米尔语思维进行创作,而非翻译。提示语模仿真实用户在数字环境中的书写习惯,包括碎片化口语、情感化表达和不同程度的代码混合(从纯泰米尔语到泰米尔-英语混合)。
- 语言风格划分:数据集中明确区分了三种语域:
- 口语泰米尔语:口语化、代码混合。
- 正式泰米尔语:程序化、中立。
- 文学泰米尔语:文雅、富有感染力,适用于历史、文学和评论内容。
- 验证机制:通过内置的
validator模块自动执行边界检查(如语域一致性)和相似度检测。
关键验证逻辑与技术细节
- 近重复检测:不自动拒绝,而是标记为“待人工审查”。使用**字符三词元(Character Trigrams)**而非词n元组,以更好地处理泰米尔语的粘着语特性(如词根后接不同后缀)。
- P0修复:跨Schema无效记录的重复检测:
- 采用两遍扫描策略。第一遍注册所有记录的提示和响应文本(如果存在、为字符串且非空),无论其 schema 验证是否通过。
- 第二遍运行完整的检查套件。Schema 错误仍会短路内容检查,但来自第一遍的重复发现会与 schema 错误一并记录。
- 重复ID检测:
schema.duplicate_id发现现在计入报告的duplicate_count。 - 退出码策略:仅当基础设施故障(如文件未找到)时退出码为1;数据验证失败(如格式错误)时退出码为0,视为数据发现而非工具故障。
- 三个泰米尔语特定边界情况:
- 复合字符:泰米尔语元音符号是组合Unicode码点,导致简单字符计数错误。验证器通过统计U+0B80–U+0BFF范围内的所有码点来计算泰米尔语字符比例。
- 泰米尔语转写的英语外来词:如“ஹைட்ரேட்டடா”(hydrated)完全使用泰米尔文书写,但本质是英语。验证器通过一个三值标记字段(
allowed_code_switch、unexpected_latin_text)来管理此类代码混合。 - 方言变体:不同方言(如蒂鲁内尔维利方言与哥印拜陀方言)的相似对,其字符三词元Jaccard相似度约0.65,低于0.70的阈值,因此不被标记为重复。阈值通过已知的好样本和坏样本校准得到。
验证结果
- 记录数:50条,全部有效(0条无效)。
- 质量评分:99.9 / 100(总体)。
- 问题数:0个错误,1个警告,0个信息提示。
- 重复发现:0个。
注:唯一的警告是来自英语比例检查的误报,所涉记录为一个有意的代码混用口语配对,经人工审查确认为可接受。
搜集汇总
数据集介绍
构建方式
该数据集名为TamilLM SFT Seed Dataset,专为从零训练的泰米尔语大语言模型TamilLM设计,包含50对指令微调种子数据。其构建理念为“以泰米尔语思维撰写,而非翻译成泰米尔语”,每条提示均模拟真实用户的数字交流语境,涵盖从完全泰米尔语到高度泰米尔式英语的语码混合形式。数据按三种语域精心划分:口语泰米尔语呈现碎片化与情感化特征,正式泰米尔语保持程序化与中性,文学泰米尔语则富于修辞与感染力。构建过程中,通过基于泰米尔语动词词尾模式匹配的一致性检查自动强制执行语域边界,确保每条记录的语言风格与其标注语域严格一致。近重复数据采用标记而非自动拒绝策略,利用字符三元组而非词n元组计算Jaccard相似度,准确捕捉泰米尔语黏着结构下的变体差异,阈值经过校准以区分方言变异与模板化重复。
使用方法
数据集的使用简洁而灵活。用户可通过安装依赖并运行主脚本快速启动,默认路径对零参数调用完全支持。显式命令接口允许自定义输入文件、清洗输出与验证报告路径,满足不同使用场景。数据集的真实来源为data/tamil_sft_seed.jsonl文件,验证管道会生成清洗后的clean.jsonl与详尽的validation_report.json供分析。测试套件通过pytest运行,覆盖个体规则检查、P0回归案例、工具函数与编排器逻辑。验证结果报告包含记录总数、有效数、无效数、聚合质量分数以及问题与重复发现详情,用户可据此评估数据质量并迭代改进。这种开箱即用且可编程的设计,使得数据集既适合快速验证,也适合集成到更复杂的泰米尔语模型训练流水线中。
背景与挑战
背景概述
TamilLM SFT Seed Dataset是一个专为泰米尔语大语言模型TamilLM设计的指令微调种子数据集,由研究团队于近期创建。该数据集聚焦于泰米尔语在数字环境中的实际使用特性,核心研究问题在于如何构建高质量、语言真实的指令数据以改善模型对低资源语言的适应能力。与多数依赖机器翻译的数据集不同,该数据集的每一条提示均模拟真实用户的输入习惯,涵盖口语、正式及文学三种语域,并通过精心设计的验证管道保证数据质量。这一工作为泰米尔语自然语言处理领域提供了基础性资源,对推动低资源语言模型的自主开发具有重要影响力,也为其他低资源语言的数据构建提供了可借鉴的方法论。
当前挑战
该数据集面临的首要挑战是泰米尔语独特的语言结构所带来的技术难题,如复合字符在Unicode中由多个码点构成,导致简单的字符计数会错误地膨胀泰米尔语脚本比例,需采用精确的码点计数策略。此外,数据中混入的泰米尔文拼写英语借词(如“ஹைட்ரேட்டடா”)虽能通过拉丁脚本检查,却造成不同记录间同一借词因拼写方式不同而形成零Jaccard相似度的伪重复,需借助枚举标记字段加以区分。方言变体之间的相似度接近但应当保留,因而阈值必须通过已知方言对和模板化对的对比进行精密校准,使真实差异与模板化替换的聚类界限分明。数据构建过程中,还需处理口语中高度碎片化、存在情感色彩及代码混合的语言现象,同时在验证管道中分离基础设施错误与数据错误,确保仅当工具自身无法正常运行时才以非零退出码报错。
常用场景
经典使用场景
在自然语言处理领域,低资源语言的指令微调数据集构建始终是一项极具挑战性的任务。TamilLM SFT Seed Dataset 专为泰米尔语(Tamil)从零开始的大语言模型设计,包含50条精心标注的指令-回答对。其典型使用场景覆盖了泰米尔语口语、正式语和文学语三种语域的有意区分,以及从纯泰米尔语到泰米尔英语混合语(Tanglish)的自然代码切换。该数据集不仅作为泰米尔语指令微调种子数据,更提供了一套完整的验证流水线,用于自动检测重复项、语域一致性和脚本比例异常,为低资源语言模型的数据质量保障树立了标杆。
解决学术问题
该数据集核心解决了低资源语言大模型训练中数据稀缺与质量不可控的双重困境。学术上,它首次系统性提出了泰米尔语特有的语域分类校验方法,利用泰米尔语动词词尾模式匹配自动区分口语、正式语和文学语,弥补了现有英文主导的验证工具无法处理黏着语形态的空白。针对泰米尔语黏着构词带来的字符级相似度度量难题,数据集采用字符三元组(character trigrams)而非词元组,精准捕获变位形式间的共享结构,有效过滤模板化重复数据。此外,它揭示了泰米尔语中英语借词的脚本混合问题,通过枚举型字段标记有意与无意的代码切换,推动了对多脚本语言数据清洗理论的深化。
实际应用
在实际应用中,该数据集可支撑泰米尔语智能客服、教育辅导系统和区域社交媒体分析等垂直领域的模型微调。例如,口语混合语对可用于训练识别泰米尔人日常聊天中的情感色彩和碎片化表达,正式语对则适用于政府服务机器人的程序化应答,而文学语对能辅助泰米尔古典文学的数字人文研究。数据集的验证管道还具备工业级鲁棒性:基础设施故障(如文件缺失)与非基础设施故障(如数据格式错误)被明确分离,确保在持续集成环境中仅对真正影响数据质量的异常报错,避免因无效记录中断自动化流水线。
数据集最近研究
最新研究方向
TamilLM SFT Seed Dataset聚焦于为泰米尔语构建首个从零开始训练的大语言模型,其最新研究方向在于解决泰米尔语在数字语境下的独特挑战,包括口语与书面语的多语码混合、方言变体、以及泰米尔语特有的复合字符和借词处理问题。该数据集通过精心设计的50对指令微调种子数据,结合自动化验证流水线,旨在确保数据的语言真实性和多样性,以支持泰米尔语大模型的忠实表达而非简单翻译。这一工作对于推动低资源语言在自然语言处理领域的前沿研究具有重要意义,尤其是在多语言AI应用日益普及的背景下,为保护语言多样性和促进文化包容性提供了关键技术支撑。
以上内容由遇见数据集搜集并总结生成


