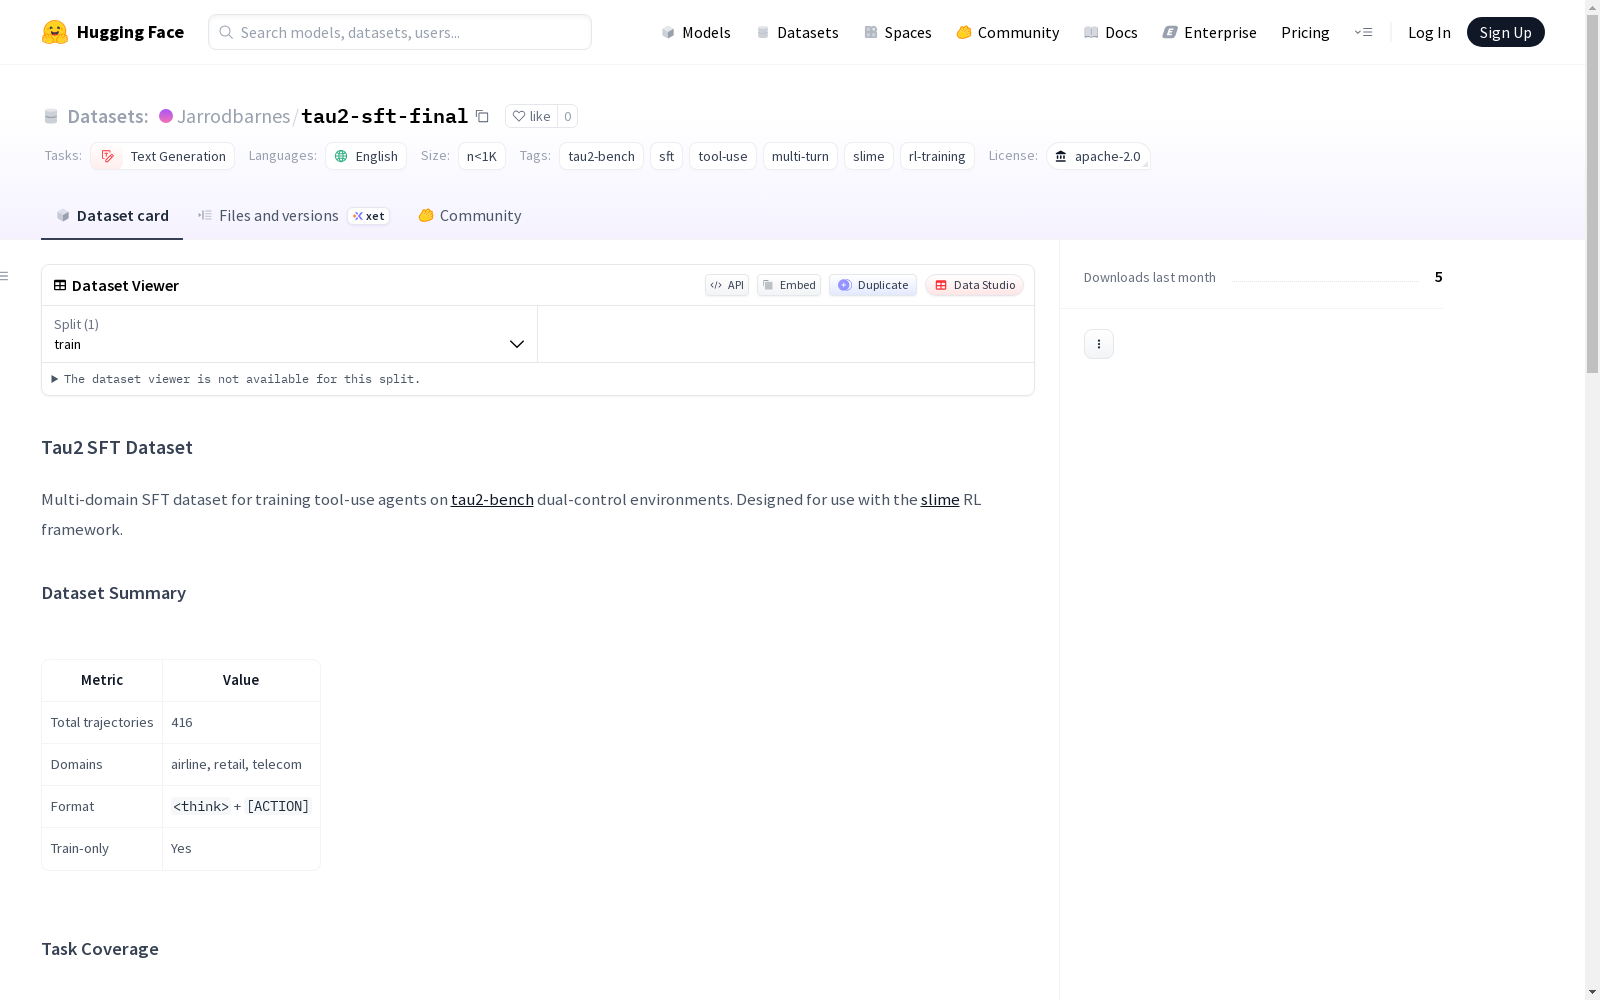
tau2-sft-final
收藏资源简介:
Tau2 SFT数据集是一个多领域的监督微调数据集,用于在tau2-bench双控制环境中训练工具使用代理。该数据集包含416个轨迹,覆盖航空、零售和电信三个领域,采用JSONL格式存储,包含任务ID、提示、响应和元数据等信息。数据集设计用于与slime RL框架配合使用,并提供了训练基准和任务覆盖率等详细信息。
The Tau2 SFT Dataset is a multi-domain supervised fine-tuning dataset for training tool-using agents in the tau2-bench dual-control environment. This dataset contains 416 trajectories covering three domains: aviation, retail, and telecommunications. It is stored in JSONL format and includes information such as task ID, prompt, response, and metadata. The dataset is designed to work with the slime RL framework, and provides detailed information including training benchmarks and task coverage metrics.
Tau2 SFT 数据集概述
数据集基本信息
- 许可证: Apache-2.0
- 任务类别: 文本生成
- 语言: 英语
- 标签: tau2-bench, sft, tool-use, multi-turn, slime, rl-training
- 规模类别: n<1K
数据集简介
这是一个用于在 tau2-bench 双控环境中训练工具使用代理的多领域监督微调数据集。设计用于 slime 强化学习框架。
数据集摘要
| 指标 | 值 |
|---|---|
| 总轨迹数 | 416 |
| 领域 | airline, retail, telecom |
| 格式 | <think> + [ACTION] |
| 仅用于训练 | 是 |
任务覆盖范围
| 领域 | 训练任务数 | 覆盖率 |
|---|---|---|
| airline | 30 | 100% |
| retail | 74 | 100% |
| telecom | 74 | 82.4% |
监督微调基线 (Qwen3-4B, 1 epoch)
| 领域 | Pass@1 | 平均部分得分 |
|---|---|---|
| airline | 5.0% | 17.5% |
| retail | 20.0% | 38.7% |
| telecom | 0.0% | 0.0% |
| 整体 | 8.75% | 18.9% |
文件
tau2_sft_final.jsonl- 完整数据集 (416 条轨迹)tau2_sft_final_reasoned10.jsonl- 过滤为 10 词以上推理的数据 (267 条轨迹)
数据格式
json { "task_id": "[domain]task_id[sample_N]", "prompt": [...messages...], "response": "", "metadata": { "domain": "airline|retail|telecom", "tau2_task_id": "...", "success": true|false, "partial_score": 0.0-1.0, "tool_sequence": ["tool1", "tool2", ...] } }
数据选择策略
桥接对齐选择:优先选择成功轨迹,用高质量失败轨迹(部分得分 >= 0.55)填充,并强制要求工具序列的多样性。
使用方法
python from datasets import load_dataset
ds = load_dataset("Jarrodbarnes/tau2-sft-final", data_files="tau2_sft_final.jsonl", split="train")
训练参考
完整的监督微调到 GRPO 流程请参见 slime tau-bench 示例。