
遇见数据集

NCube/papyrus

收藏
Hugging Face2024-05-22 更新2024-06-12 收录
官方服务:

资源简介:

数据集来源于Papyrus,这是一个位于蒙特利尔大学的文档库,主要包含多种语言的论文摘要,特别是法语和英语。数据集提供了四种不同的配置,基于摘要的语言,允许生成法语、英语或多语言的关键词。具体配置包括:Papyrus-f(从法语摘要生成法语关键词)、Papyrus-e(从英语摘要生成英语关键词)、Papyrus-m(从任何一种语言的摘要生成该语言的关键词)、Papyrus-a(从文档的多个摘要生成与摘要相同语言的关键词)。数据集的主要语言为英语和法语,还包括西班牙语、德语、意大利语、葡萄牙语、阿拉伯语、他加禄语、加泰罗尼亚语、希腊语、土耳其语、俄语、波兰语、波斯语、印尼语、林加拉语、瑞典语、芬兰语、罗马尼亚语和韩语。

数据集来源于Papyrus,这是一个位于蒙特利尔大学的文档库,主要包含多种语言的论文摘要,特别是法语和英语。数据集提供了四种不同的配置,基于摘要的语言,允许生成法语、英语或多语言的关键词。具体配置包括:Papyrus-f(从法语摘要生成法语关键词)、Papyrus-e(从英语摘要生成英语关键词)、Papyrus-m(从任何一种语言的摘要生成该语言的关键词)、Papyrus-a(从文档的多个摘要生成与摘要相同语言的关键词)。数据集的主要语言为英语和法语,还包括西班牙语、德语、意大利语、葡萄牙语、阿拉伯语、他加禄语、加泰罗尼亚语、希腊语、土耳其语、俄语、波兰语、波斯语、印尼语、林加拉语、瑞典语、芬兰语、罗马尼亚语和韩语。

提供机构:
NCube
原始信息汇总

数据集卡片 for Papyrus

数据集描述

数据集概述

Papyrus数据集源自Université de Montréal的Papyrus仓库,包含多种类型的文档,主要是多语言摘要的论文。数据集提供四种不同的配置,基于摘要的语言,允许生成法语、英语或多种语言的关键短语。

  • Papyrus-f: 从法语摘要生成法语关键短语。
  • Papyrus-e: 从英语摘要生成英语关键短语。
  • Papyrus-m: 从一个任意语言的摘要生成相同语言的关键短语(一对一语言)。
  • Papyrus-a: 从文档的多语言摘要生成相同语言的关键短语(多对多语言)。

语言

  • 主要语言: 英语, 法语
  • 其他语言: 西班牙语, 德语, 意大利语, 葡萄牙语, 阿拉伯语, 塔加洛语, 加泰罗尼亚语, 希腊语, 土耳其语, 俄语, 波兰语, 波斯语, 印度尼西亚语, 林加拉语, 瑞典语, 芬兰语, 罗马尼亚语, 韩语

数据集结构

数据集内容

配置 训练集大小 验证集大小 测试集大小
papyrus-m 20963 3040 6061
papyrus-e 10508 1539 3046
papyrus-f 10299 1488 2981
papyrus-a 11290 1638 3261

数据字段

  • doc_id: 原始文档的唯一ID。
  • title: 论文或文章的标题(标题的语言不一定与摘要/关键短语的语言匹配)。
  • input_text: 文档的摘要。
  • keyphrases: 相关关键短语。
  • lang: 摘要/关键短语的语言。

引用

@inproceedings{NEURIPS2022_f8870955, author = {Piedboeuf, Fr{e}d{e}ric and Langlais, Philippe}, booktitle = {Advances in Neural Information Processing Systems}, editor = {S. Koyejo and S. Mohamed and A. Agarwal and D. Belgrave and K. Cho and A. Oh}, pages = {38046--38059}, publisher = {Curran Associates, Inc.}, title = {A new dataset for multilingual keyphrase generation}, url = {https://proceedings.neurips.cc/paper_files/paper/2022/file/f88709551258331f9ab31b33c71021a4-Paper-Datasets_and_Benchmarks.pdf}, volume = {35}, year = {2022} }
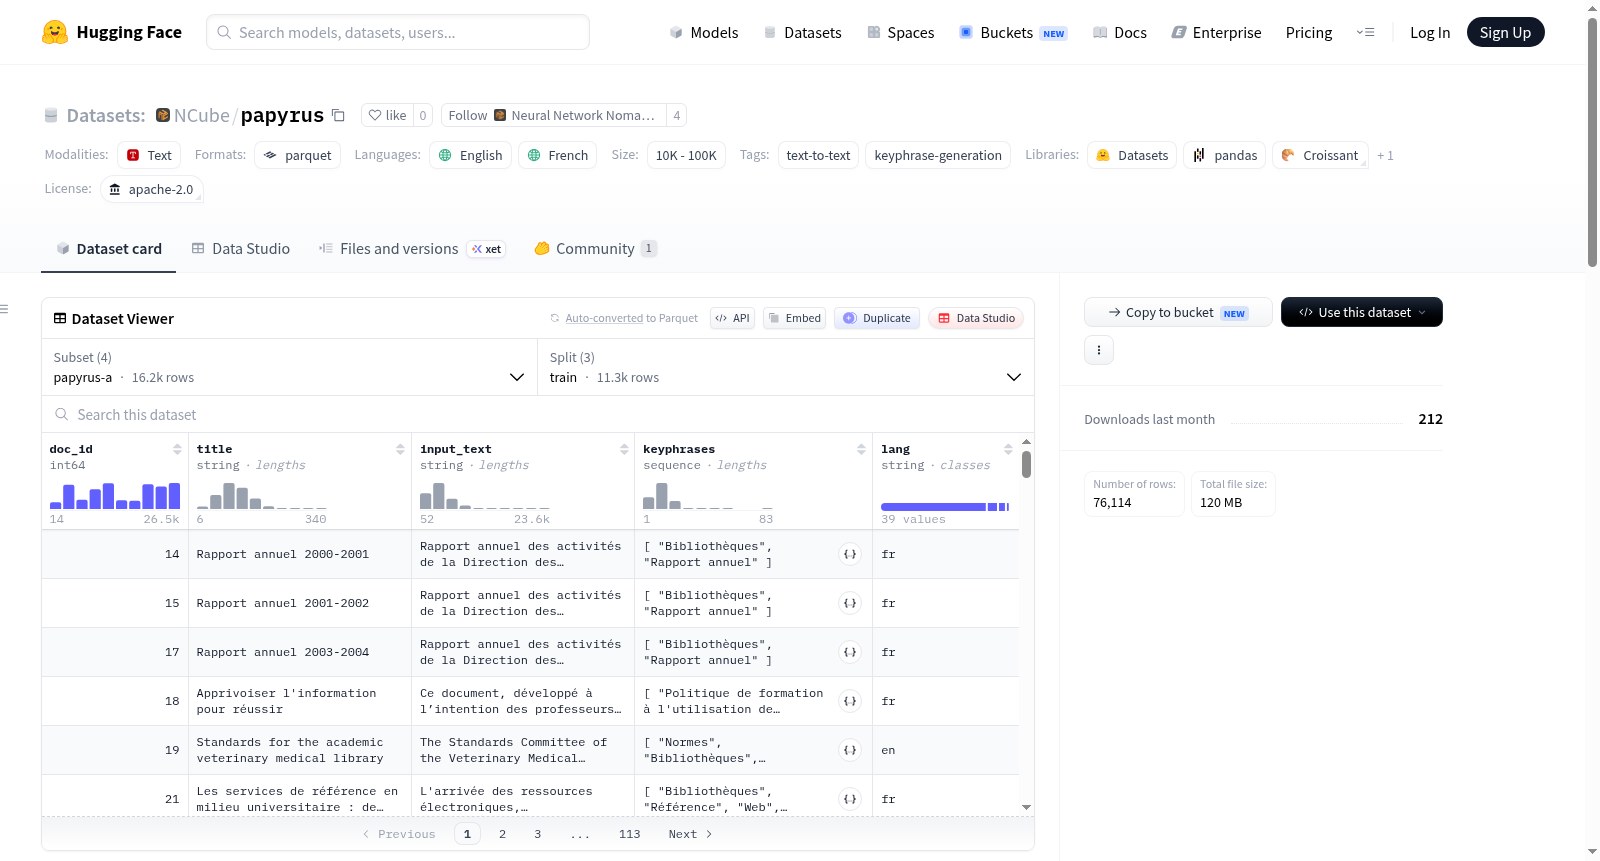
搜集汇总
数据集介绍
NCube/papyrus 数据集图片
构建方式
在自然语言处理与关键短语生成领域,高质量的多语言数据集是推动模型性能提升的关键基石。Papyrus数据集源自蒙特利尔大学的Papyrus知识库,该库汇集了多种类型的学术文献,尤其以法语和英语的论文摘要为主。构建过程中,研究者依据摘要的语言类别精心设计了四种配置:Papyrus-f聚焦法语摘要生成法语关键短语,Papyrus-e对应英语摘要生成英语关键短语,Papyrus-m支持任意单一语言摘要生成同语言关键短语,而Papyrus-a则利用同一文档的多语言摘要,实现多语言输入到多语言关键短语的生成。每个样本均包含文档标识符、标题、摘要文本、关联关键短语及其语言标签,确保了数据结构的完整性与可复用性。
使用方法
使用Papyrus数据集时,研究人员可通过HuggingFace Datasets库便捷加载,依据任务需求选择特定配置,例如`load_dataset('NCube/papyrus', 'papyrus-a')`以获取多语言版本。数据集中`input_text`字段作为模型输入,`keyphrases`字段作为生成目标,适用于序列到序列的关键短语生成任务。借助`lang`字段,用户可过滤特定语言子集进行单语言或跨语言实验。该数据集遵循Apache-2.0许可证,支持学术与非商业用途,并已配套提供基准模型与评估脚本,便于复现论文结果或探索新的多语言生成算法。建议在训练前对文本进行分词与标准化处理,以适配不同预训练语言模型的输入格式。
背景与挑战
背景概述
在自然语言处理领域,关键短语生成(Keyphrase Generation)是一项旨在从文档中自动提取或生成代表性短语的核心任务,广泛应用于信息检索、文本摘要与知识管理。然而,现有数据集多聚焦于单一语言,限制了模型在多语言场景下的泛化能力。为应对这一不足,Frédéric Piedboeuf 与 Philippe Langlais 于2022年在NeurIPS上发布了 Papyrus 数据集,依托蒙特利尔大学的 Papyrus 学术库,汇集了以法语和英语为主、涵盖近二十种语言的多类型文档摘要及其对应的关键短语。该数据集提供了四种配置:papyrus-f(法语到法语)、papyrus-e(英语到英语)、papyrus-m(单语到单语)以及 papyrus-a(多语到多语),为多语言关键短语生成研究提供了首个大规模、标准化的基准资源,显著推动了跨语言文本理解与生成技术的发展。
当前挑战
Papyrus 数据集所解决的领域挑战在于,传统关键短语生成模型在单一语言语料上表现优异,却难以应对多语言混合、语种间语义对齐以及跨语言关键短语一致性等复杂问题。多语言环境中,不同语言的句法结构、词汇密度与表达习惯差异显著,模型需同时具备语言鉴别与语义映射能力,这对序列到序列架构提出了更高要求。在数据集构建过程中,挑战同样严峻:原始 Papyrus 学术库中的文档语言分布极不均衡,法语与英语占据主导,而其他语言样本稀疏,导致低资源语种的关键短语生成任务面临严重的数据稀疏性。此外,摘要与关键短语的语言匹配并非严格一致,部分文档的标题语言与摘要语言存在错位,需人工校验与过滤以保证标注质量。这些因素共同构成了多语言关键短语生成在数据规模、语言覆盖与标注一致性上的核心瓶颈。
常用场景
经典使用场景
Papyrus数据集是面向多语言关键短语生成任务的核心基准资源,其设计植根于学术文献中摘要与关键词的语义映射关系。该数据集提供了四种配置:Papyrus-f聚焦法语摘要到法语关键短语的生成,Papyrus-e对应英语场景,Papyrus-m支持任意单语言摘要到同语言关键短语的转换,而Papyrus-a则挑战从多语言摘要中生成对应多语言关键短语的复杂任务。经典使用场景包括训练序列到序列模型(如T5、BART)以捕捉跨语言语义一致性,并在统一框架下评估模型在法语、英语及多语言混合环境中的生成质量与鲁棒性。
解决学术问题
该数据集有效填补了非英语关键短语生成领域大规模标注资源的空白,解决了传统研究因数据匮乏而过度依赖英语单语模型的局限。通过提供结构化对齐的多语言摘要-关键短语对,Papyrus使研究者得以探索跨语言知识迁移机制,并系统评估模型在低资源语言(如法语)上的泛化能力。其多配置设计(如Papyrus-a)进一步推动了多对多语言映射问题的学术探索,为理解语言间语义等价性与关键短语的跨语言一致性表征提供了实证基础,显著提升了多语言自然语言处理任务的评估严谨性。
实际应用
在现实场景中,Papyrus数据集支撑了学术文献库的自动化标引系统,例如帮助数字图书馆(如Université de Montréal的Papyrus机构库)从多语言摘要中自动提取关键短语,提升跨语言检索效率。此外,该数据集可应用于科技情报分析工具,辅助研究者快速定位多语种文献的核心主题,以及赋能教育平台中法语或双语论文的语义摘要生成。其多语言特性还适用于国际专利文本的关键词提取,促进跨区域技术趋势的自动化挖掘与知识图谱构建。
数据集最近研究
最新研究方向
Papyrus数据集的出现为多语言关键短语生成领域注入了新的活力,其核心创新在于构建了一个涵盖法语、英语及多种其他语言的学术文档语料库,突破了以往研究多集中于单一语言的桎梏。当前,该领域的前沿探索正聚焦于如何利用此类多源异构数据,提升跨语言关键短语抽取与生成的鲁棒性。特别是,结合大规模预训练语言模型(如mT5、XLM-R)进行微调,以应对低资源语言中数据稀疏性的挑战,已成为热点方向。Papyrus提供的四种配置(单语、多语映射)为系统评估不同语言策略下的生成质量提供了标准化基准,其影响力已延伸至信息检索、学术知识图谱构建等下游任务,推动了多语言自然语言处理技术在学术文献理解中的实际应用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

