
遇见数据集

mozilla-ai/gguf-jlens-artifacts

收藏
Hugging Face2026-07-17 更新2026-07-22 收录
官方服务:

资源简介:

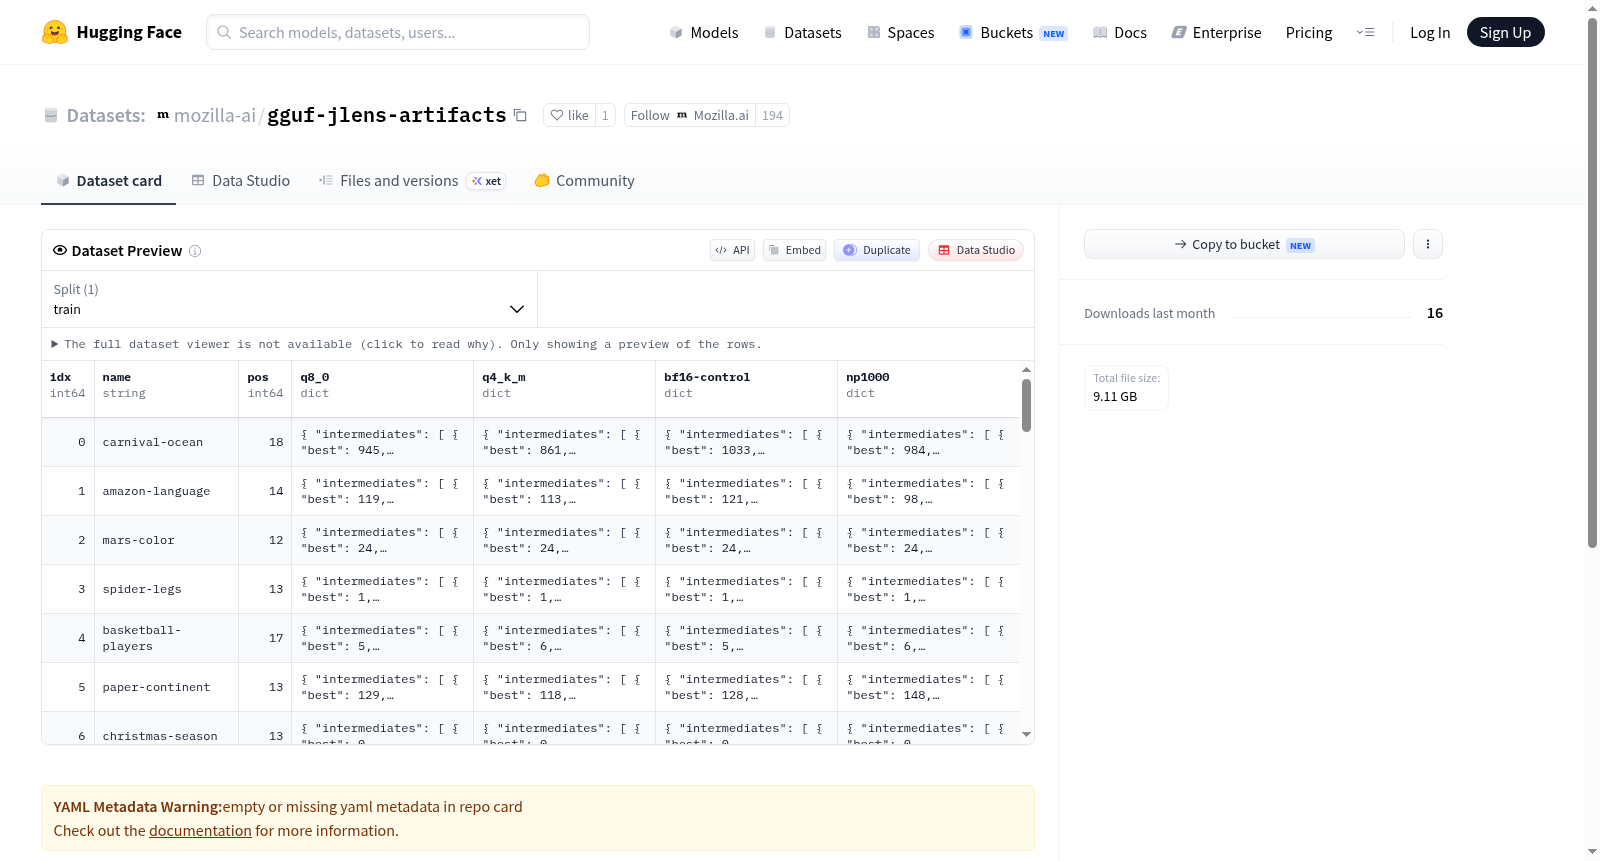
该数据集是gguf-jlens项目的重型工件集合,用于在GGUF量化的Qwen3.5-4B模型上应用Jacobian透镜分析。数据集包含三个核心目录:lenses/存储拟合的Jacobian透镜文件(*.pt)和恢复检查点(*.ckpt.pt),涵盖q8_0、q4_k_m、q3_k_m、q2_k和bf16-control等量化类型及其副本;models/包含从unsloth BF16文件本地量化的GGUF模型文件(如Q3_K_M和Q2_K);out/则包括每项排名转储(ranks/、ranks5/、ranks6/)、切片页面和拟合日志。数据集源自Apache-2.0许可的Qwen3.5-4B模型和WikiText数据,旨在支持量化模型的分析和调试。

This dataset is the heavy artifact collection of the gguf-jlens project, designed for applying Jacobian lens analysis to the GGUF-quantized Qwen3.5-4B model. It comprises three core directories: - The `lenses/` directory stores fitted Jacobian lens files (with file extensions *.pt) and recovery checkpoints (with file extensions *.ckpt.pt), covering quantization types including q8_0, q4_k_m, q3_k_m, q2_k, bf16-control and their corresponding replicas; - The `models/` directory contains GGUF model files locally quantized from unsloth BF16 files, such as Q3_K_M and Q2_K; - The `out/` directory includes per-item rank dumps with subdirectories ranks/, ranks5/, ranks6/, sliced pages, and fitting logs. This dataset is derived from the Apache-2.0 licensed Qwen3.5-4B model and WikiText dataset, and is intended to support the analysis and debugging of quantized models.
提供机构:
mozilla-ai
搜集汇总
数据集介绍
mozilla-ai/gguf-jlens-artifacts 数据集图片
构建方式
该数据集主要为gguf-jlens项目(基于GGUF量化版Qwen3.5-4B的雅可比透镜分析)提供配套的工程制品,通过将透镜拟合结果、模型量化文件与输出日志等大型二进制文件分离存储于HuggingFace仓库,以规避Git版本控制对大文件的限制。数据集包含`lenses/`目录下的已拟合雅可比透镜(.pt格式)及恢复检查点(.ckpt.pt格式),覆盖q8_0、q4_k_m、q3_k_m、q2_k等不同量化精度版本,以及bf16全精度对照组,并配有独立的-s2副本用于不相交样本验证;`models/`目录存储从unsloth提供的BF16原始文件本地量化生成的GGUF模型文件(Q3_K_M与Q2_K);`out/`目录存放逐项排序转储数据,包括ranks、ranks5、ranks6子目录及切片页面和拟合日志。数据集的构建基于Apache-2.0协议下的Qwen3.5-4B基座模型与WikiText语料,体现了对量化模型可解释性研究的工程化支撑。
特点
该数据集的核心特点在于其专注于GGUF量化大语言模型的雅可比透镜分析,提供了从低比特量化(Q2_K)到接近无损(q8_0)及全精度(bf16)对照组的多样化透镜制品,便于研究量化精度对神经网络内部表征的影响。数据集结构清晰,按功能模块分设子目录,其中lenses与checkpoint的版本控制通过-s2后缀实现不相交样本的独立副本,增强了实验的可重复性与对比性。此外,该数据集天然与gguf-jlens代码仓库协同使用,通过`python scripts/artifacts.py pull`命令即可自动恢复至本地克隆,降低了复杂工程制品的获取门槛。所有制品均衍生自开源模型与语料库,确保了学术研究的合规性。
使用方法
使用该数据集时,用户需先克隆gguf-jlens项目代码仓库,然后在仓库根目录下运行`python scripts/artifacts.py pull`命令,该脚本将自动从HuggingFace仓库下载所有制品并还原到`lenses/`、`models/`、`out/`等对应目录中。下载完成后,研究者可直接加载`lenses/`下的.pt透镜文件用于雅可比透镜的推理与可视化分析,或使用`models/`中的GGUF量化模型进行后续实验。输出目录`out/`内的排序转储文件可用于透镜拟合效果的评估与调试。建议用户参考代码仓库中的`docs/writeup.md`文档了解详细的使用流程与实验结果解读方法。
背景与挑战
背景概述
gguf-jlens-artifacts数据集诞生于大语言模型可解释性研究的前沿领域,由致力于探索量化模型内部机制的科研团队创建,旨在支持对GGUF量化后的Qwen3.5-4B模型进行雅可比透镜分析。该数据集的核心研究问题聚焦于如何通过透镜技术揭示量化过程对模型表示与决策路径的影响,从而为高效压缩模型的可信应用提供理论支撑。自发布以来,它已成为连接模型量化与机械可解释性研究的桥梁,推动了低精度部署场景下模型透明度评估的发展。
当前挑战
该数据集面临的核心挑战在于:1)量化模型(如Q3_K_M、Q2_K)因精度损失导致特征空间坍缩,使得传统可解释性方法难以直接适用,需创新透镜拟合算法以捕捉稀疏激活模式;2)构建过程中,从BF16基座模型到多种量化格式的转换需保持算子一致性,同时需规避Git大文件存储限制,通过分片镜像同步大规模权重和检查点文件,确保实验的可复现性。
常用场景
经典使用场景
在可解释人工智能的探索中,Jacobian透镜作为一种前沿的分析工具,被用于窥探大型语言模型内部的表征结构。该数据集包含了针对Qwen3.5-4B模型在不同量化精度下(如q8_0、q4_k_m、q3_k_m、q2_k及BF16对照)微调后的Jacobian透镜参数与检查点文件。研究者可借此复现对模型中间层表征的线性方向分析,揭示模型在压缩与量化条件下的知识表征变化规律,从而深化对神经网络内部运作机制的理解。
衍生相关工作
围绕该数据集已衍生出多项开创性工作。其核心产物gguf-jlens项目本身就是一个方法论创新,将Jacobian透镜机制移植到GGUF量化格式上,开创业界先河。后续研究利用这批透镜参数,深入分析了模型在低比特条件下注意力头与隐藏层之间涌现的补偿性表征,并探索了利用透镜投影进行量化噪声矫正的新路径。这些衍化成果共同构建了量化大模型可解释性研究的完整知识图谱。
数据集最近研究
最新研究方向
当前研究聚焦于大语言模型量化与可解释性的交叉前沿,gguf-jlens-artifacts数据集为Jacobian透镜在GGUF量化模型上的应用提供了关键支撑。该成果源自Qwen3.5-4B与WikiText语料的深度耦合,通过多级量化(q8_0至q2_k)与对照实验(bf16-control),系统性揭示了压缩感知下模型内部表征的退化规律。相关方向与近期AI安全热点事件紧密关联——当业界加速推进边缘端量化部署时,该数据集首次以显式透镜参数形式记录了精度损失与可解释性衰减的量化关系,为构建轻量可审计的语言智能系统奠定了实验基础,其产出物(如秩转储与拟合日志)已成为评估量化模型可解释性退化程度的基准参照。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

