
遇见数据集

MongoDB/cosmopedia-wikihow-chunked

收藏
Hugging Face2024-02-27 更新2024-03-04 收录
官方服务:

资源简介:

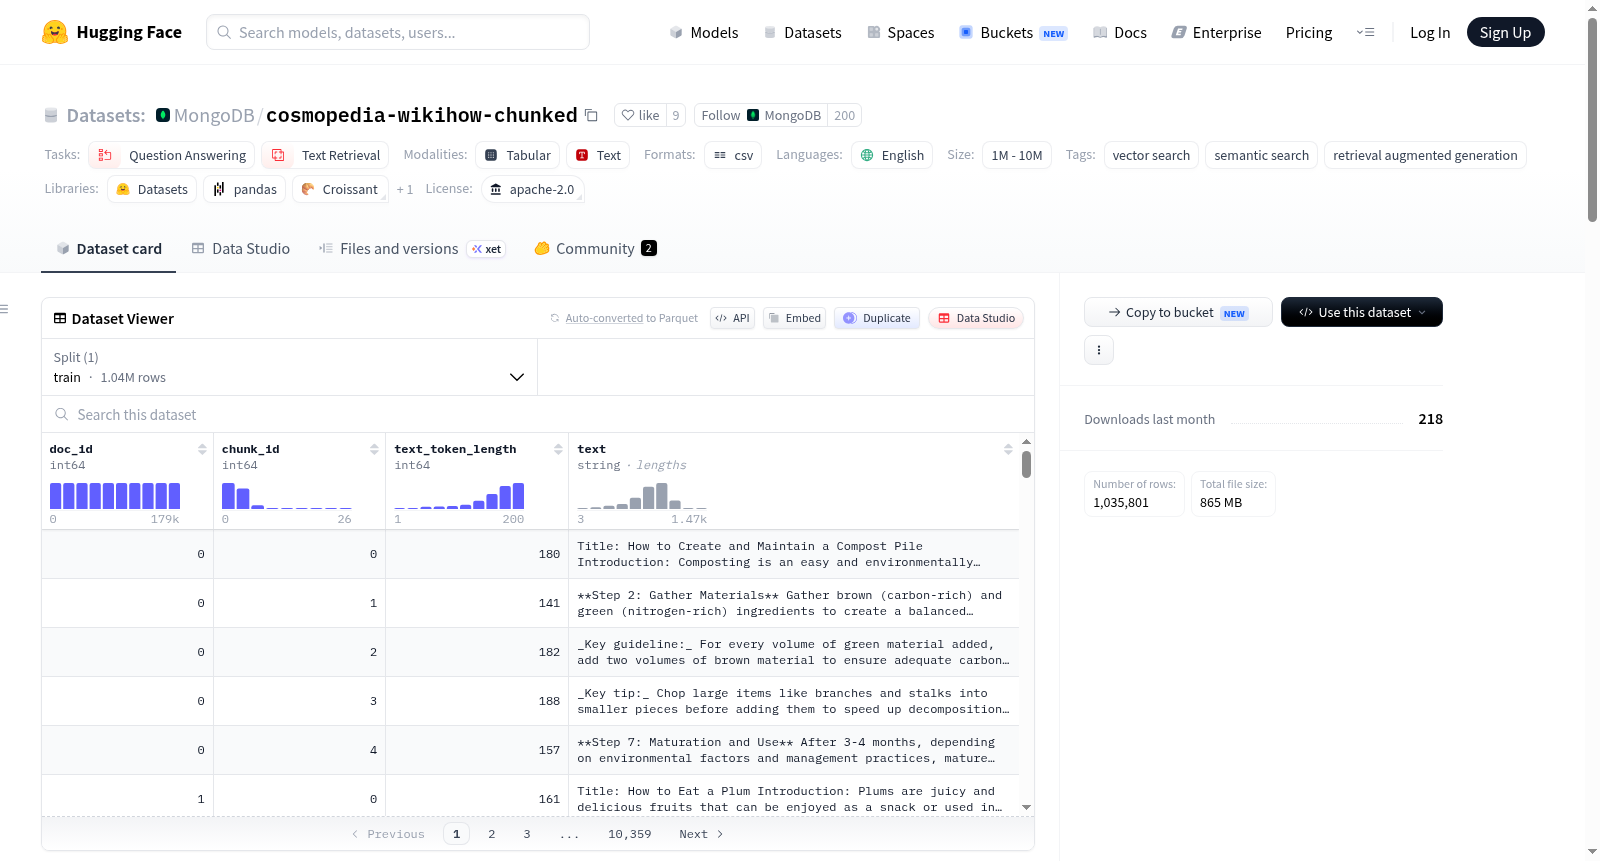
该数据集是Hugging Face整理的Cosmopedia数据集的子集的分块版本,特别使用了Wikihow文章的子集,并将每篇文章分割成不超过2个段落的块。每个记录代表一个较大的文章块,包含`doc_id`、`chunk_id`、`text_token_length`和`text`字段。该数据集可用于评估和测试嵌入模型、RAG、语义搜索的检索质量以及问答性能。

该数据集是Hugging Face整理的Cosmopedia数据集的子集的分块版本,特别使用了Wikihow文章的子集,并将每篇文章分割成不超过2个段落的块。每个记录代表一个较大的文章块,包含`doc_id`、`chunk_id`、`text_token_length`和`text`字段。该数据集可用于评估和测试嵌入模型、RAG、语义搜索的检索质量以及问答性能。

提供机构:
MongoDB
原始信息汇总

数据集概述

该数据集是从 Cosmopedia 数据集中精选的一部分 Wikihow 文章的片段版本。每个文章被分割成不超过两个段落的片段。

数据集结构

每个记录代表一个较大文章的片段,包含以下字段:

  • doc_id: 父文章的唯一标识符
  • chunk_id: 每个片段的唯一标识符
  • text_token_length: 片段文本中的标记数量
  • text: 片段的原始文本

使用场景

该数据集可用于评估和测试:

  • 嵌入模型的性能和 RAG
  • 语义搜索的检索质量
  • 问答性能

示例文档

MongoDB 中的文档应如下所示:

json { "_id": { "$oid": "65d93cb0653af71f15a888ae" }, "doc_id": { "$numberInt": "0" }, "chunk_id": { "$numberInt": "1" }, "text_token_length": { "$numberInt": "111" }, "text": "**Step 1: Choose a Location ** Select a well-draining spot in your backyard, away from your house or other structures, as compost piles can produce odors. Ideally, locate the pile in partial shade or a location with morning sun only. This allows the pile to retain moisture while avoiding overheating during peak sunlight hours.

Key tip: Aim for a minimum area of 3 x 3 feet (0.9m x 0.9m) for proper decomposition; smaller piles may not generate enough heat for optimal breakdown of materials." }
搜集汇总
数据集介绍
MongoDB/cosmopedia-wikihow-chunked 数据集图片
构建方式
该数据集源自Hugging Face团队精心策划的Cosmopedia大规模语料库,专门提取了其中Wikihow文章的子集,并进行了精细的文本分块处理。每个原始文章被切割为不超过两个段落长度的文本块,确保每个数据记录都代表一个语义相对完整的片段。数据集的每条记录包含四个核心字段:doc_id作为父文档的唯一标识,chunk_id标记每个块的独立序号,text_token_length记录文本块的词元数量,以及text字段存储原始文本内容。这种结构化的构建方式既保留了原始文档的上下文关联性,又为下游任务提供了粒度适中的处理单元。
特点
MongoDB/cosmopedia-wikihow-chunked数据集在规模上介于一百万至一千万条记录之间,覆盖了丰富的英文操作指南类知识。其最显著的特点在于文本分块的策略性设计——每个块不超过两个段落,在保持语义完整性的同时兼顾了向量检索和嵌入模型对输入长度的限制。数据集专门面向向量搜索、语义检索和检索增强生成等现代自然语言处理任务而优化,能够有效评估嵌入模型的表征能力以及RAG系统的检索质量。此外,数据采用Apache-2.0开源许可协议,便于学术研究和商业应用中的广泛使用。
使用方法
该数据集在MongoDB Atlas环境中可通过标准数据加载流程便捷使用。用户需先注册MongoDB Atlas账户获取连接URI,随后利用Hugging Face的datasets库加载数据集,并通过PyMongo驱动程序将数据批量导入指定数据库集合。示例脚本展示了以每千条记录为批次进行插入的操作模式,兼顾了数据迁移效率与系统稳定性。导入后的文档保持原始字段结构,可直接用于构建语义搜索索引、训练问答模型或评估检索系统的性能。这种无缝对接MongoDB生态的设计,使得数据集在向量数据库场景下的实验与应用尤为流畅。
背景与挑战
背景概述
MongoDB/cosmopedia-wikihow-chunked数据集诞生于检索增强生成(RAG)与语义搜索技术蓬勃发展的浪潮之中,由MongoDB与Hugging Face团队合作创建,旨在为嵌入模型评估与知识密集型问答系统提供标准化测试基准。该数据集源自Hugging Face精心构建的Cosmopedia语料库,聚焦于WikiHow领域的高质量指导性文本,通过将每篇长文分割为不超过两个段落的语义块,既保留了原始知识的完整性,又适配了向量数据库对短文本索引的天然偏好。自发布以来,它迅速成为评估向量检索性能与RAG流水线效果的标杆数据集,尤其为MongoDB Atlas等向量数据库的开发者社区提供了可复现的评测场景,深刻推动了非结构化数据检索领域的实证研究。
当前挑战
该数据集面临的核心挑战在于多维度语义粒度的平衡问题。从领域问题视角看,传统语义搜索任务往往难以区分表层关键词匹配与深层意图理解,而WikiHow的指导性文本天然包含步骤性逻辑与隐性因果关联,这使得基于简单向量相似度的检索容易忽略文本中蕴含的推理链条。在构建过程中,采用固定段落数的分块策略虽简化了工程实现,却可能割裂跨段落存在的上下文依赖,例如同一主题下的前置条件与后续操作被强制分离。此外,数据集仅保留英文文本,限制了跨语言泛化能力的验证,且文本长度差异悬殊(从数十词到数百词不等),为嵌入模型的长度鲁棒性带来了额外考验。
常用场景
经典使用场景
在信息检索与自然语言处理领域,MongoDB/cosmopedia-wikihow-chunked数据集以其精细化的文本分块特性,成为评估语义搜索与检索增强生成(RAG)系统性能的经典基准。该数据集源自Cosmopedia中Wikihow文章的子集,每篇文章被切割为不超过两个段落的分块,并保留了文档标识符、分块标识符、文本长度及原始文本等结构化字段。研究者常利用此数据集测试嵌入模型对短文本语义的捕捉能力,以及RAG系统在知识库中精准定位相关分块的效率,尤其是在需要处理步骤化、指令性内容的场景下,其分块粒度能有效模拟真实问答中的信息片段检索需求。
衍生相关工作
该数据集衍生了一系列推动检索与生成技术融合的前沿工作。基于其分块结构,研究者提出了自适应分块策略,通过动态调整段落边界以优化检索效率;同时,它被用于训练轻量级语义嵌入模型,显著提升了低资源场景下的检索速度。在RAG方向,该数据集催生了多轮对话中的上下文感知检索框架,使模型能在连续交互中保持对历史查询的记忆。此外,结合MongoDB的向量索引技术,衍生出混合搜索(稀疏+稠密)的优化方案,有效平衡了检索的精确度与召回率,为工业级知识问答系统奠定了实践基础。
数据集最近研究
最新研究方向
在检索增强生成(RAG)与语义搜索技术迅猛发展的浪潮中,MongoDB/cosmopedia-wikihow-chunked数据集因其独特的结构化分块设计,成为评估嵌入模型与向量搜索性能的标杆资源。该数据集聚焦于WikiHow文章的子集,通过将长文本拆解为不超过两个段落的语义单元,精准模拟了现实场景中知识检索的粒度需求。当前前沿研究方向集中于利用该数据集优化RAG系统的上下文召回精度,尤其是在多轮问答与长文档碎片化场景下,如何通过分块策略提升检索与生成的协同效率。此外,该数据集与MongoDB Atlas向量搜索功能的深度集成,为构建端到端的语义搜索流水线提供了标准化测试平台,推动了从学术研究到工业落地的快速转化,其影响在于加速了知识密集型应用如智能客服、教育辅助系统的智能化升级。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

