
Value-v1-NUMINA-V1-Blocks-Merged-3194-problems-step-len-filtered
收藏数据链接:
官方服务:
资源简介:
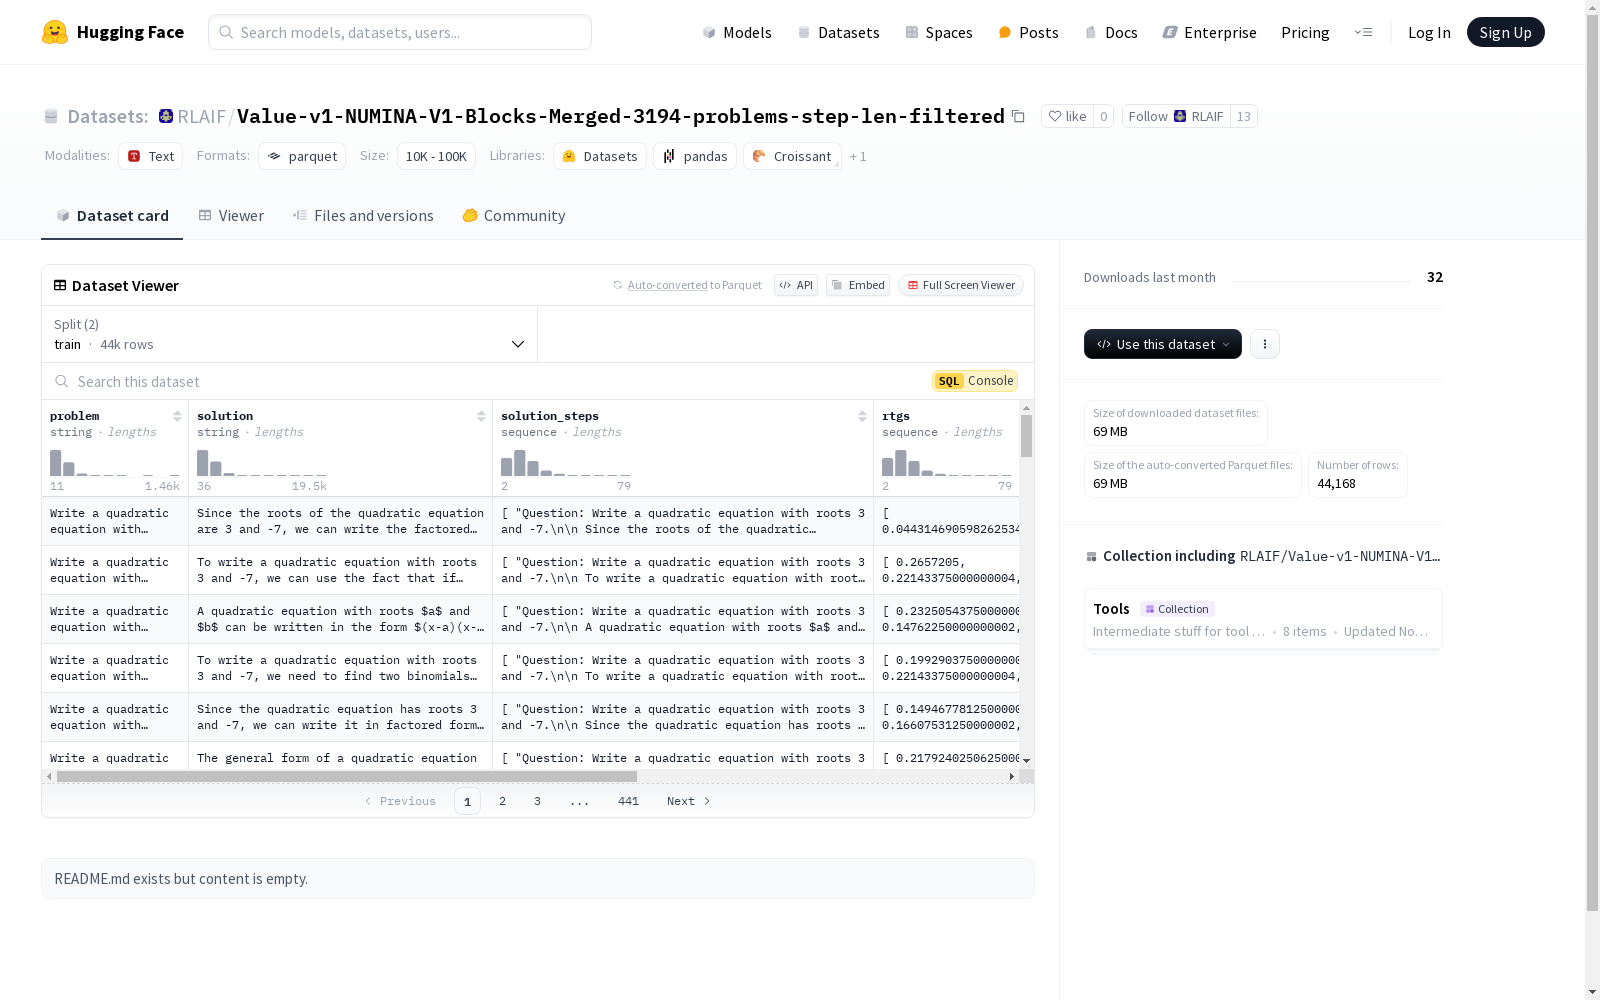
该数据集包含多个特征,如问题描述、解决方案、解决方案步骤、奖励值、未折扣奖励值、是否正确、目标答案和解决方案计数。数据集分为训练集和测试集,分别包含44011和157个样本。数据集的总大小为229707440.26323077字节,下载大小为68977537字节。
This dataset contains multiple features, including problem description, solution, solution steps, reward value, undiscounted reward value, correctness flag, target answer, and solution count. The dataset is split into training and test sets, which contain 44,011 and 157 samples respectively. The total size of the dataset is 229,707,440.26323077 bytes, and the download size is 68,977,537 bytes.
提供机构:
RLAIF创建时间:
2024-11-18
原始信息汇总
数据集概述
数据集信息
特征
- problem: 字符串类型
- solution: 字符串类型
- solution_steps: 字符串序列
- rtgs: 浮点数序列
- undiscounted_rtgs: 浮点数序列
- is_correct: 布尔类型
- target_answer: 字符串类型
- solution_counts: 浮点数类型
数据分割
- train: 包含44011个样本,大小为228859364.53198078字节
- test: 包含157个样本,大小为848075.73125字节
数据集大小
- 下载大小: 68977537字节
- 数据集总大小: 229707440.26323077字节
配置
- config_name: default
- data_files:
- train: data/train-*
- test: data/test-*
- data_files:
搜集汇总
数据集介绍
构建方式
Value-v1-NUMINA-V1-Blocks-Merged-3194-problems-step-len-filtered数据集的构建过程基于对3194个问题的深入分析与处理。每个问题均包含详细的解决方案及其步骤,同时记录了每一步的回报值(rtgs)和未折扣回报值(undiscounted_rtgs)。数据集通过严格的步骤长度过滤,确保每个问题的解决方案步骤合理且有效。最终,数据集被划分为训练集和测试集,分别包含44011和157个样本,以支持模型的训练与评估。
特点
该数据集的核心特点在于其丰富的特征表示,涵盖了问题描述、解决方案、解决方案步骤、回报值、未折扣回报值、正确性标识、目标答案以及解决方案计数等多个维度。这种多维度的特征设计使得数据集能够全面反映问题的解决过程及其效果。此外,数据集通过步骤长度过滤,确保了数据的质量与一致性,为模型提供了高质量的训练与评估基础。
使用方法
使用Value-v1-NUMINA-V1-Blocks-Merged-3194-problems-step-len-filtered数据集时,研究人员可通过加载训练集和测试集进行模型的训练与验证。数据集中的每个样本均包含完整的问题解决过程及其相关特征,便于模型学习与推理。通过分析解决方案步骤及其回报值,模型可以优化其决策过程,提升问题解决的准确性与效率。此外,数据集中的正确性标识和目标答案为模型的性能评估提供了明确的参考标准。
背景与挑战
背景概述
Value-v1-NUMINA-V1-Blocks-Merged-3194-problems-step-len-filtered数据集是一个专注于问题解决与步骤推理的数据集,旨在为人工智能领域提供丰富的训练和测试资源。该数据集由NUMINA研究团队创建,涵盖了3194个问题及其对应的解决方案、解决步骤、奖励信号等关键信息。其核心研究问题在于如何通过多步骤推理和奖励机制来提升模型在复杂任务中的表现。该数据集的出现为强化学习和序列决策领域的研究提供了重要的数据支持,推动了相关算法的发展与应用。
当前挑战
该数据集在构建过程中面临的主要挑战包括如何确保问题与解决方案的多样性和复杂性,以及如何准确标注每一步骤的奖励信号。在解决领域问题时,模型需要具备强大的多步骤推理能力,以应对复杂任务中的非线性关系。此外,数据集中的奖励信号设计也需精确反映每一步骤的贡献,这对模型的训练和评估提出了更高的要求。构建过程中,数据清洗与标注的准确性也是关键挑战,确保数据质量的同时,还需保持数据集的规模与多样性。
常用场景
经典使用场景
Value-v1-NUMINA-V1-Blocks-Merged-3194-problems-step-len-filtered数据集在教育和自动化问题解决领域具有广泛的应用。该数据集通过提供详细的问题描述、解决方案步骤以及相关的奖励信号,为研究者提供了一个理想的平台,用于开发和测试自动化问题解决算法。特别是在教育技术中,该数据集能够帮助设计智能辅导系统,通过分析学生的解题步骤和反馈,提供个性化的学习建议。
衍生相关工作
基于Value-v1-NUMINA-V1-Blocks-Merged-3194-problems-step-len-filtered数据集,研究者们已经开展了多项经典工作。这些工作主要集中在自动化问题解决算法的优化和智能教育系统的开发上。例如,一些研究利用该数据集中的奖励信号和解决方案步骤,开发了高效的强化学习算法,显著提高了自动化问题解决的准确性和效率。此外,还有一些研究基于该数据集构建了智能辅导系统,通过分析学生的解题步骤和反馈,提供个性化的学习建议,取得了显著的教育效果。
数据集最近研究
最新研究方向
在人工智能与教育技术领域,Value-v1-NUMINA-V1-Blocks-Merged-3194-problems-step-len-filtered数据集的最新研究方向聚焦于智能解题系统的优化与评估。该数据集通过提供详细的问题描述、解决方案步骤以及相关的奖励信号(rtgs和undiscounted_rtgs),为研究者提供了丰富的训练和测试资源。当前研究热点包括利用深度学习模型自动生成解题步骤,以及通过强化学习算法优化解题策略。这些研究不仅提升了智能解题系统的准确性和效率,还为教育技术中的个性化学习路径设计提供了新的思路。该数据集的应用推动了智能教育工具的创新发展,具有重要的学术价值和实际意义。
以上内容由遇见数据集搜集并总结生成


