
遇见数据集

issai/PersonaMix

收藏
Hugging Face2026-07-01 更新2026-07-22 收录
官方服务:

资源简介:

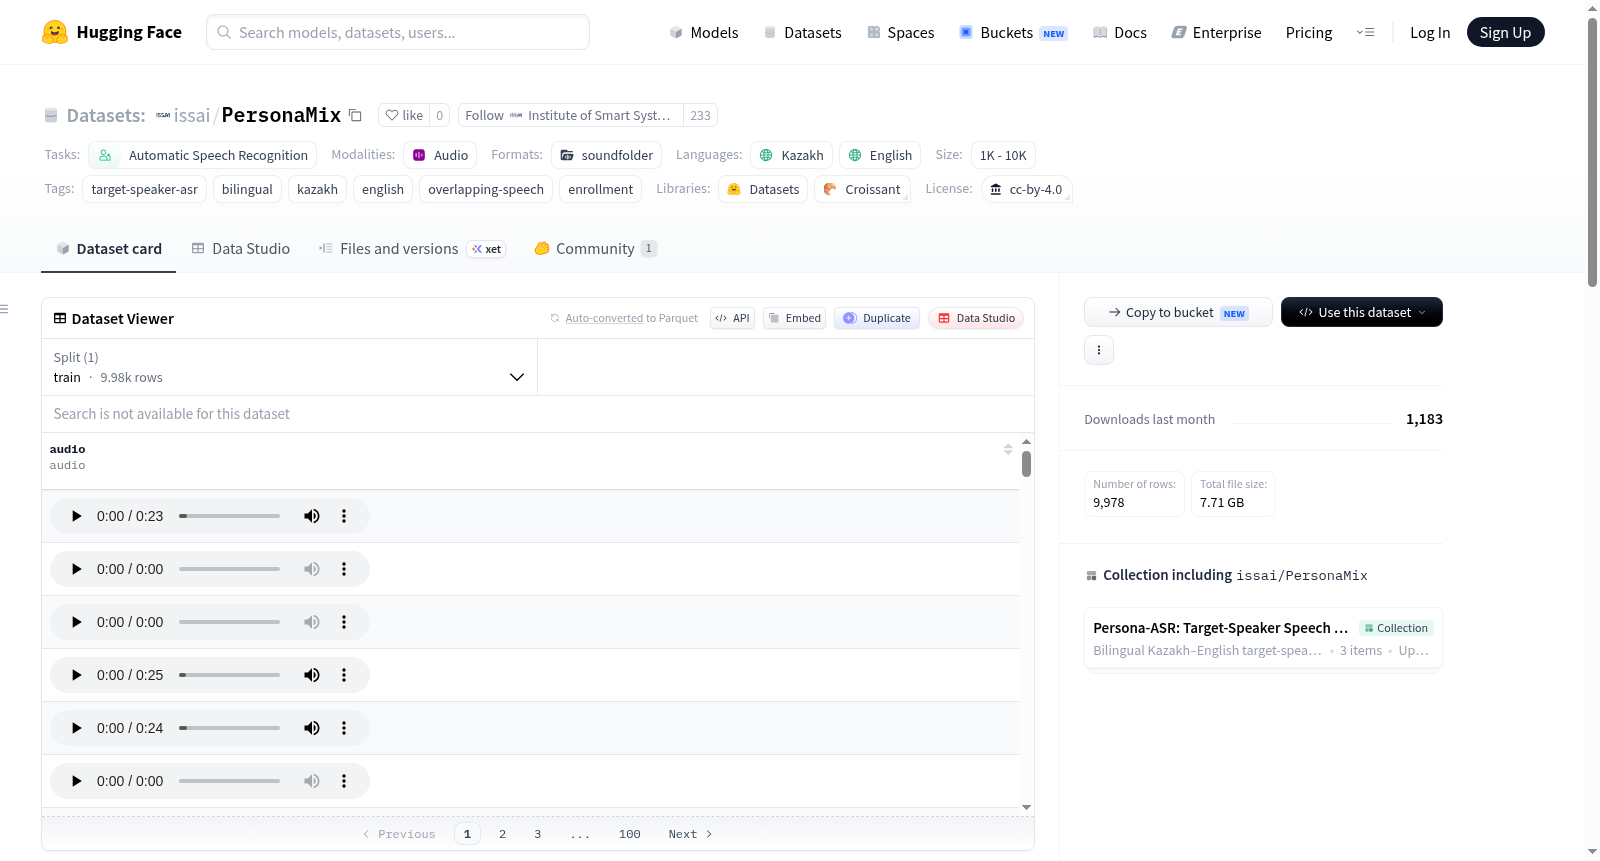
PersonaMix是一个用于目标说话人自动语音识别和目标存在检测的双语(哈萨克语-英语)基准数据集,针对重叠语音场景发布,与Persona-ASR一起发布。四位说话人(两女两男)每人用哈萨克语和英语朗读11个脚本句子。混合语音包含1-3个干扰说话人,信噪比为-3、0、+3、+6分贝,支持同语言注册(条件A)和跨语言注册(条件B);跨语言条件指在一种语言中注册说话人,并在另一种语言中转录其语音。数据集结构包括混合物目录(按条件分类)、实验JSON文件(包含评估清单,如目标说话人ASR和目标存在检测),以及源录音文件(共88个录音,涵盖所有说话人和语言)。清单字段包括混合物音频、注册音频、转录文本、样本类型、目标说话人ID、语言信息、信噪比和元数据。

PersonaMix is a bilingual (Kazakh-English) benchmark dataset for target speaker automatic speech recognition (ASR) and target presence detection, released for overlapping speech scenarios alongside Persona-ASR. Four speakers (two female, two male) each read 11 scripted sentences in both Kazakh and English. The mixed speech contains 1-3 interfering speakers, with signal-to-noise ratios (SNR) of -3, 0, +3, and +6 dB, supporting both same-language enrollment (Condition A) and cross-language enrollment (Condition B); cross-language enrollment refers to enrolling a speaker in one language and transcribing their speech in the other language. The dataset structure includes mixture directories (classified by condition), experimental JSON files (containing evaluation manifests such as target speaker ASR and target presence detection), and source audio recordings (totaling 88 recordings covering all speakers and languages). The manifest fields include mixture audio, enrollment audio, transcribed text, sample type, target speaker ID, language information, signal-to-noise ratio, and metadata.
提供机构:
issai
搜集汇总
数据集介绍
issai/PersonaMix 数据集图片
构建方式
PersonaMix数据集专为目标说话人语音识别(target-speaker ASR)与目标存在检测任务设计,构建于哈萨克语-英语双语重叠语音场景之上。数据源自四位语音提供者(两女两男),每位参与者以双语形式朗读11句脚本录音,共88条纯净语音。在混合阶段,通过叠加1至3个干扰说话人,并在−3至+6分贝信噪比区间内操控信噪比,生成具有挑战性的重叠语音。进一步区分为同语言注册(A)与跨语言注册(B)两种条件,其中跨语言注册使得说话人语音与转录语言不一致,从而引入更复杂的声学与语言变量。最终评价清单按条件、信噪比及任务类型组织为JSON格式。
特点
PersonaMix最显著的特点在于其精细控制的多维度变化体系,同时涵盖干扰说话人数、信噪比以及语言一致性。同语言与跨语言注册条件的对比设计,为研究跨语言注册对目标说话人识别与转录性能的影响提供了独特视角。数据集结构规范化,评价清单内含注册语音、混合音频、转录文本及目标存在标签等关键字段,并区分正负样例,不仅支持目标说话人ASR评估,亦兼容目标存在检测任务。这种设计使研究者能够在可控条件下系统剖析干扰强度、语言匹配性与识别难度之间的内在关联。
使用方法
使用PersonaMix时,研究者可直接访问mixtures目录下的重叠语音,以及experiment_jsons目录中的评价清单JSON文件。针对目标说话人ASR任务,建议加载*_asr.json文件,提取mixture_audio与enrollment_audio字段分别作为输入音频及注册音频,transcript字段作为参考转录,并过滤仅保留sample_type为positive的正样例。对于目标存在检测任务,则可使用*_cls.json文件,涵盖正负样例,以mixture_audio与enrollment_audio为特征,以sample_type为标签进行二分类训练与评估。各文件按条件、信噪比分组,便于分维度消融实验或跨条件性能对比。
背景与挑战
背景概述
PersonaMix数据集由IS2AI研究团队于2026年发布,专注于双语言(哈萨克语—英语)目标说话人语音识别(T-ASR)与目标存在检测任务。该数据集通过精心设计的重叠语音混合方案,为评估在嘈杂多说话人场景中提取特定目标说话人语音的能力提供了标准化基准。其核心研究问题在于解决多语种重叠语音环境下目标说话人的鲁棒识别与转录,尤其针对哈萨克语这一资源稀缺语言。PersonaMix的出现填补了双语目标说话人ASR领域的评估空白,对推动语音交互系统在真实复杂声学环境下的应用具有重要参考价值,尤其在多语言通信和智能会议系统等场景中展现出显著潜力。
当前挑战
PersonaMix面临的核心挑战包括:1)领域问题挑战——重叠语音中目标说话人的分离与识别长期受干扰说话人数量(1–3人)、信噪比(−3至+6 dB)及语言混合(同语言与跨语言)的多重影响,导致声学特征混淆与语音转写错误率升高;2)构建过程挑战——数据集构建需严格平衡说话人多样性与语言覆盖,涉及4位说话人(两男两女)分别使用两种语言朗读11句脚本,并生成多种复杂度下的重叠混合语音。跨语言条件下(如用英语注册说话人但转录其哈萨克语内容)的声学模型泛化能力成为关键瓶颈,同时确保正负样本均衡(目标存在/缺失)与不同SNR配置的完整覆盖亦增加了数据标注与标准化处理的难度。
常用场景
经典使用场景
在语音识别与多说话人交互的前沿探索中,PersonaMix作为一项精心构建的双语(哈萨克语-英语)目标说话人语音识别基准,专门服务于重叠语音场景下的核心任务。其经典使用场景聚焦于目标说话人自动语音识别(Target-Speaker ASR)与目标存在检测(Target-Presence Detection)。研究者可利用该数据集,在1至3位干扰说话人共存且信噪比从-3dB至+6dB变化的复杂声学环境中,通过提供目标说话人的注册语音,精准提取并转录其语音内容,同时判别该目标说话人是否存在于混合语音中。
解决学术问题
重叠语音下目标说话人识别与分离长期是语音处理领域的顽疾,传统单通道方法在多人同时说话时性能急剧下降。PersonaMix通过引入可控的双语、多干扰源及跨语言注册条件,系统性地解决了两个关键学术难题:一是如何在同一语言与跨语言注册条件下实现鲁棒的目标说话人ASR;二是如何在高噪声与多说话人重叠场景中准确判别目标说话人的存在与否。该数据集的意义在于为双语与跨语言场景下的说话人感知语音处理提供了标准化评测平台,推动了端到端模型在复杂声学环境中的泛化能力研究,极大促进了语音交互系统在多语言、多说话人实际部署中的理论突破。
衍生相关工作
PersonaMix的发布催生了一系列与之紧密相关的经典研究工作。其配套框架Persona-ASR即是直接基于该数据集开发的基准系统,首次将双语目标说话人识别与重叠语音处理相结合。后续众多研究借鉴其同语言与跨语言注册的对照设计思路,衍生出跨语言说话人适应、多说话人语音分离与识别联合优化、以及面向低资源语言的迁移学习等方法。此外,PersonaMix双重任务(ASR与检测)的评估范式被广泛应用于改进说话人感知的端到端模型架构,如基于注意力机制的说话人滤波网络和条件式编解码器,推动了目标说话人语音处理领域从单一识别向感知-分离-转写一体化方向的演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

