
遇见数据集

hist-dk-pos

收藏
Hugging Face2026-05-08 更新2026-05-09 收录
官方服务:

资源简介:

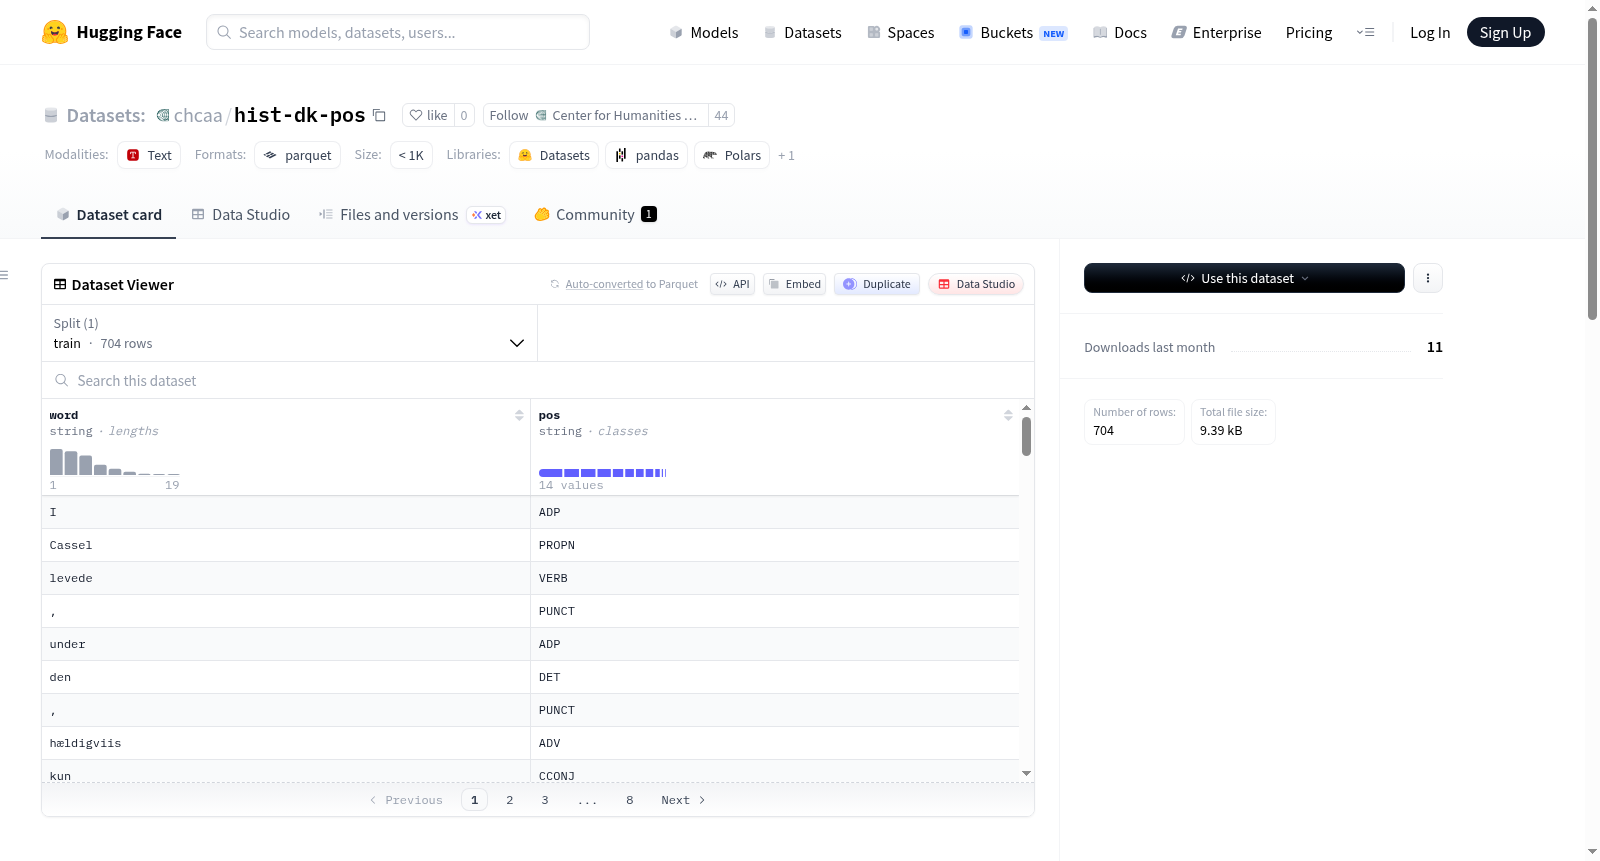
该数据集包含从1824年出版的丹麦历史报纸小说中随机选取的示例句子,文本源自Press-and-Plot数据集(索引10)。数据经过多轮词性标注处理:首先使用SpaCy的丹麦语词性标注器进行自动标注,随后由两名标注员分别手动修正,最终由第一位标注员裁定差异以确定最终标签。数据集包含704个训练样本,每个样本包含单词(word)和词性标签(pos)两个字段。数据集由奥胡斯大学人文计算中心GoldenMatrix团队策划,奥尔堡大学ENO团队处理,语言为1824年的丹麦语,采用CC0许可协议。

This dataset contains randomly sampled sentences from Danish historical newspaper novels published in 1824, with the text originating from the Press-and-Plot dataset (Index 10). The data underwent a multi-stage part-of-speech (POS) tagging workflow: firstly, automatic POS tagging was conducted using SpaCy's Danish POS tagger, followed by manual revision by two separate annotators, and finally the first annotator arbitrated discrepancies to finalize the labels. The dataset consists of 704 training samples, each including two fields: "word" and "pos". It was curated by the GoldenMatrix Team at the Center for Humanities Computing, Aarhus University, and processed by the ENO Team at Aalborg University. The dataset is in 1824-era Danish and is released under the CC0 license.

创建时间:
2026-05-08
原始信息汇总

数据集概述:hist-dk-pos

数据集地址: https://huggingface.co/datasets/chcaa/hist-dk-pos

1. 基本描述

  • 内容来源: 该数据集包含从1824年历史丹麦报纸小说中提取的示例句子,文本随机选自Press-and-Plot数据集(具体为索引10)。
  • 语言: 丹麦语(dan),年份为1824年。
  • 许可证: 丹麦报纸属于公共领域(CC0)。

2. 数据集结构

  • 特征(Features):
    • word:字符串(string),表示单词。
    • pos:字符串(string),表示词性标注(Part-of-Speech tag)。
  • 划分(Splits):
    • 仅包含 train 划分,共704个样本,占用11682字节。
  • 数据集大小: 下载大小为5014字节,数据集总大小为11682字节。

3. 标注流程

该数据集经过多轮词性标注(PoS tagging):

  1. 第一轮: 使用SpaCy的丹麦语词性标注器(模型为da_core_news_sm)进行自动标注。
  2. 第二轮: 标注员1手动审查并修正第一轮标注。
  3. 第三轮: 标注员2独立添加自己的修正标注。
  4. 最终轮: 标注员1比较两位标注员的修正结果,裁决最终标签以解决少数差异。

4. 数据集详情

  • 策展方: 奥胡斯大学人文计算中心(CHC)的GoldenMatrix项目。
  • 处理方: 奥尔堡大学的ENO项目。
  • 上传者: Pascale Feldkamp。

5. 使用示例

可以使用以下Python代码加载数据集: python from datasets import load_dataset

ds = load_dataset("chcaa/hist-dk-pos", split="train") df = ds.to_pandas() # 转换为pandas DataFrame
搜集汇总
数据集介绍
hist-dk-pos 数据集图片
构建方式
该数据集源自1824年丹麦报纸小说片段,取自Press-and-Plot数据集。标注过程采用多轮迭代策略:首先利用SpaCy的丹麦语词性标注器进行自动化标注,随后两位标注员分别独立进行人工校正,最后由首位标注员综合考虑双方意见,裁决出最终标签,从而确保标注的准确性与一致性。
特点
数据集包含704个训练样本,涵盖单词及其对应词性标签,语言为19世纪初的丹麦语。其独特之处在于结合了自动化标注与双重人工校验,有效提升了历史文本中词性标注的可靠性。数据来自丹麦报纸,属于公共领域,为历史语言学研究提供了宝贵资源。
使用方法
用户可通过HuggingFace的datasets库轻松加载该数据集,使用'load_dataset("chcaa/hist-dk-pos", split="train")'命令即可获取训练集。此外,支持将数据转换为Pandas DataFrame格式,方便后续分析与建模工作。该数据集适用于历史丹麦语的词性标注任务训练与评估。
背景与挑战
背景概述
词性标注(PoS tagging)作为自然语言处理(NLP)中的基础任务,为句法分析、信息抽取等下游应用提供了关键支撑。然而,历史语言的形态、句法及词汇演变带来了显著的领域漂移,使得现代标注工具在历史文本上表现欠佳,催生了对专门标注数据集的迫切需求。hist-dk-pos数据集由丹麦奥胡斯大学人文学计算中心(CHC)的Golden Matrix团队于近年策划,并由奥尔堡大学的ENO项目处理,核心研究问题聚焦于如何系统性地构建高质量的历史丹麦语词性标注资源。该数据集选取自Press-and-Plot语料库中1824年丹麦报纸小说片段,经过多轮人工修正与裁决,为历史丹麦语NLP提供了可靠的基准数据。其发布填补了低资源历史语言标注的空白,推动了古丹麦语语法分析与数字人文研究的融合,在计算语言学和北欧文献学领域产生了积极的影响。
当前挑战
该数据集所解决的领域核心挑战在于历史文本中词汇形态与句法规则的剧烈时间变异。1824年的丹麦语在词形屈折、拼写惯例及虚词用法上与现代丹麦语差异显著,导致SpaCy等现代词性标注器在初始自动标注阶段产生了大量系统性错误,例如对历史性动词变位和名词性后缀的误判。构建过程中的具体挑战体现在标注一致性的保障上:首先,自动标注的错误模式极其复杂,要求人工标注员具备历史语言学专业知识,而非仅依赖现代语感;其次,多轮交叉标注引入了显著的注者间变异性,需要通过逐词比对与仲裁环节来调校分歧,这一过程耗时且依赖专家经验;最后,数据集规模较小(仅704句),在保持标注粒度与涵盖罕见历史用法的平衡上存在天然局限,限制了模型的泛化能力与更广泛历史时期的直接迁移应用。
常用场景
经典使用场景
在自然语言处理与历史语言学交叉领域,hist-dk-pos数据集为19世纪初丹麦语书面语的词性标注研究提供了珍贵的基准资源。该数据集源于1824年丹麦报纸小说片段,经过多轮人工与自动标注相结合的精校流程,最终获得高质量的词性标签。其经典使用场景包括:作为历史丹麦语词性标注模型的训练集、评估现代标注工具在历史文本上的泛化能力、以及分析早期丹麦语语法特征。研究者可借助该数据集构建面向低资源历史语言的序列标注系统,或测试基于规则的标注方法在面对语言演变时的鲁棒性。
实际应用
该数据集的实际应用场景广泛分布于数字人文与文化遗产数字化领域。在丹麦国家图书馆、奥胡斯大学人文计算中心等机构中,hist-dk-pos被用于自动化古籍文本的语法解析,辅助历史报纸档案的语义检索与知识抽取。图书馆员和学者可借助基于该数据集训练的标注模型,对海量未标注历史文献进行词性标记,从而构建结构化语料库用于文学风格分析、主题建模或社会语言变迁追踪。此外,该数据集还服务于丹麦语教育领域,为历史文本教学提供自动化的语法注解工具,降低学生阅读早期丹麦语文献的认知门槛。
衍生相关工作
围绕hist-dk-pos数据集,学术界已衍生出一系列重要研究工作。其源数据源自Press-and-Plot数据集,催生了针对历史丹麦语的多任务标注模型开发,如结合词性标注与命名实体识别的联合学习方法。奥胡斯大学Golden Matrix项目利用该数据集验证了SpaCy等现代NLP工具在历史文本上的性能退化程度,并据此提出了面向低资源历史语言的迁移学习框架。此外,该数据集还成为评估跨时代词嵌入模型(如基于BERT的历史丹麦语变体)的基准测试集,推动了历史语言理解任务中预训练语言模型的适应性改进。这些衍生工作共同促进了历史计算语言学方法论的创新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

