
遇见数据集

FoodSeg103

收藏
arXiv2021-05-12 更新2024-06-21 收录
官方服务:

资源简介:

FoodSeg103是由新加坡管理大学构建的大型食品图像分割数据集,包含9490张图像,涵盖154种食材类别。该数据集通过精细标注,每张图像平均包含6种食材标签及像素级掩码,旨在支持食品营养和热量估算等健康相关应用的研究。创建过程中,研究团队进行了严格的数据筛选和标签迭代优化,确保了数据集的高质量。FoodSeg103的应用领域主要集中在食品图像的细粒度理解和分析,为食品计算领域提供了重要的基准数据集。

FoodSeg103 is a large-scale food image segmentation dataset constructed by Singapore Management University. It contains 9,490 images covering 154 ingredient categories. With fine-grained annotations, each image has an average of 6 ingredient labels paired with pixel-level masks. This dataset aims to support research on health-related applications such as food nutrition and calorie estimation. During its development, the research team conducted strict data screening and iterative label optimization to ensure its high quality. The main application areas of FoodSeg103 focus on fine-grained understanding and analysis of food images, serving as an important benchmark dataset for the field of food computing.
提供机构:
新加坡管理大学
创建时间:
2021-05-12
搜集汇总
数据集介绍
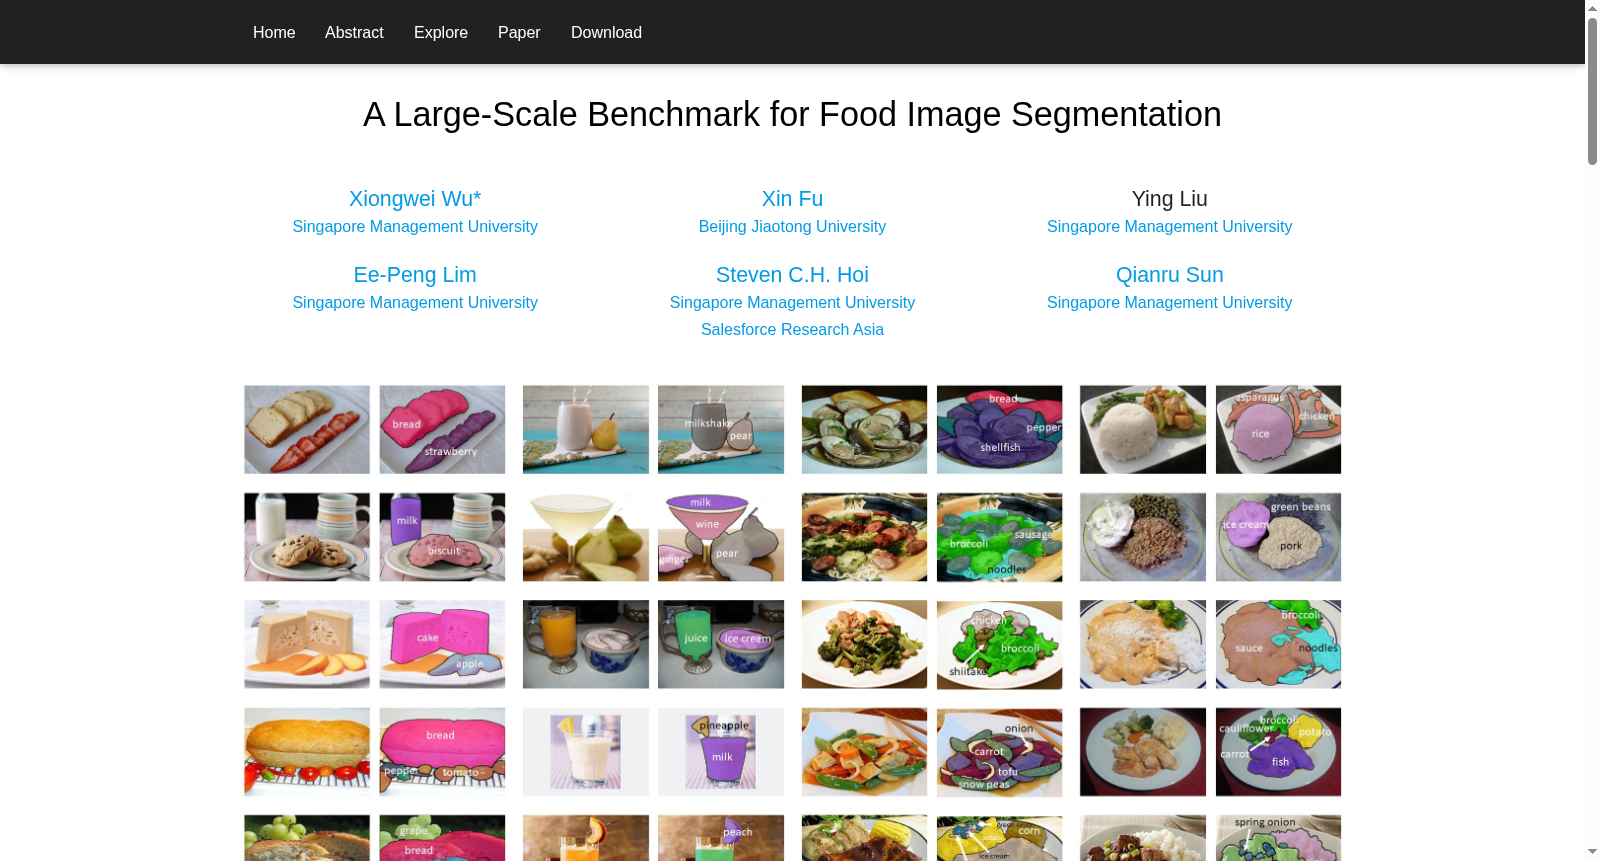
FoodSeg103 数据集图片
构建方式
FoodSeg103的构建始于从Recipe1M数据集中精选图像,该数据集包含近百万张带有烹饪说明和食材标签的食物图片。研究者首先统计了所有食材类别的出现频率,保留了最常出现的124个类别,经过迭代精炼后最终确定为103个食材类别。图像选择遵循两条准则:每张图像至少包含两种且不超过十六种食材,且这些食材需在图像中清晰可见以便标注。随后,专业标注公司为每张图像绘制了像素级的多边形掩码,标注团队在此基础上进行了三轮精炼——修正错误标签、删除出现次数少于五张图像的不常见类别、合并视觉相似的食材类别,最终形成了包含7118张图像、超过42000个掩码的FoodSeg103数据集。
特点
FoodSeg103的核心特点在于其精细的食材级别标注,每张图像平均包含六种食材的像素级掩码,这使其区别于仅提供菜品级别掩码的UECFoodPix等现有数据集。数据集覆盖了103种食材类别,可归入15个超类,如主食、肉类、蔬菜等,展现了高度的类别多样性。食材在烹饪方式影响下呈现显著的视觉变异——同一种食材在不同菜肴中可能截然不同,而不同食材却可能外观相似,这为分割任务带来了巨大挑战。此外,数据集呈现出典型的长尾分布,少数流行食材占据多数样本,而大量食材类别则数据稀疏,进一步增加了模型的泛化难度。
使用方法
FoodSeg103可作为细粒度食物图像分割的标准基准,支持多种主流语义分割框架的评估与训练。研究者可采用Dilation-based(如CCNet)、Feature Pyramid-based(如FPN)或Transformer-based(如SeTR)等方法,将图像输入编码器-解码器架构,以预测每类食材的像素级掩码。数据集默认按7:3比例划分为训练集(4983张图像)和测试集(2135张图像)。为应对食材视觉变异,可配合论文提出的ReLeM多模态预训练方法,利用Recipe1M中的食谱文本信息增强视觉表示。评估时采用mIoU、mACC等标准指标,也可利用扩展的FoodSeg154中的亚洲食物子集进行跨域泛化测试。
背景与挑战
背景概述
食物图像分割是食品计算领域的一项关键任务,对于自动估算食物卡路里与营养成分等健康相关应用具有不可或缺的作用。然而,现有数据集普遍存在细粒度标注匮乏的问题,要么仅提供粗糙的菜肴级别标签,要么样本规模有限,难以支撑精细化的食材级像素分析。为填补这一空白,新加坡管理大学的Xiongwei Wu、Qianru Sun等研究人员联合北京交通大学与Salesforce Research Asia,于2021年构建了FoodSeg103数据集。该数据集包含7,118张西式食物图像,覆盖103种食材类别,每张图像平均标注6种食材及其像素级掩膜,并进一步扩展为包含9,490张图像、154种食材的FoodSeg154。这一大规模、细粒度的基准数据集为促进食物图像语义分割研究、推动食品健康智能化分析提供了重要资源。
当前挑战
FoodSeg103所面临的挑战具有双重性。在领域问题层面,食材在不同烹饪方式下视觉差异显著,例如菠萝在荤菜与水果拼盘中外观迥异,而某些不同食材(如菠萝与土豆)却可能高度相似,导致模型难以准确区分;此外,食材类别分布天然呈现长尾特性,大量稀有类别样本稀疏,加剧了分割难度。在数据集构建过程中,挑战同样突出:图像来源Recipe1M中约1,500种食材类别多数难以从图像中清晰分割,需经过频率统计与人工筛选,最终仅保留103种;标注工作耗时约一年,需对每张图像进行像素级多边形绘制,并经历三轮精炼——纠正错误标签、删除出现次数少于5张的类别、合并视觉相似的食材(如柑橘与橙子),最终确保数据集的高质量与可用性。
常用场景
经典使用场景
FoodSeg103作为大规模、细粒度的食物图像分割基准数据集,其最经典的使用场景是推动基于深度学习的语义分割模型在食物图像领域的发展。研究者利用该数据集训练和评估各类分割算法,例如基于空洞卷积的CCNet、特征金字塔网络FPN以及视觉Transformer架构的SeTR。通过提供103类食材的像素级标注掩膜,FoodSeg103使得模型能够精确识别和定位食物图像中的多种食材,从而为后续的精细化食物分析奠定坚实基础。
衍生相关工作
FoodSeg103的发布催生了一系列具有影响力的衍生工作。其中最具代表性的是多模态预训练方法ReLeM,它巧妙利用食谱中的文本信息(如食材名称和烹饪步骤)增强视觉分割模型的表现,显著提升了CCNet等基线方法的性能。此外,后续研究探索了将Swin Transformer、PVT等新型架构应用于食物分割,并验证了在跨领域场景(如亚洲食物数据集)中的迁移能力。这些工作共同构建了食物图像理解的研究生态,推动了多模态学习与细粒度分割的交叉融合。
数据集最近研究
最新研究方向
在食品计算领域,FoodSeg103数据集的出现为细粒度食品图像分割研究提供了关键支撑,推动该方向从粗粒度的菜品分类迈向像素级食材解析的前沿。当前研究热点聚焦于利用多模态预训练策略(如ReLeM)融合食谱文本信息与视觉表征,以应对食材因烹饪方式不同而呈现的高变异性。该数据集与近期健康监测、智能营养评估等热点事件紧密关联,其精细的食材级标注为自动化热量估算与膳食分析提供了可靠的基准平台。FoodSeg103不仅促进了基于卷积网络与视觉Transformer的分割模型在复杂食品场景下的性能提升,还通过跨域评测揭示了食品图像分割相较于通用语义分割的独特挑战,对推动计算机视觉在健康科技领域的实际落地具有深远意义。
相关研究论文
  • 1
    A Large-Scale Benchmark for Food Image Segmentation新加坡管理大学 · 2021年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

