dev_set_v2_a3_rl_laion_nemotron_gym_agent_calendar_80_8B_20260826_073022
收藏资源简介:
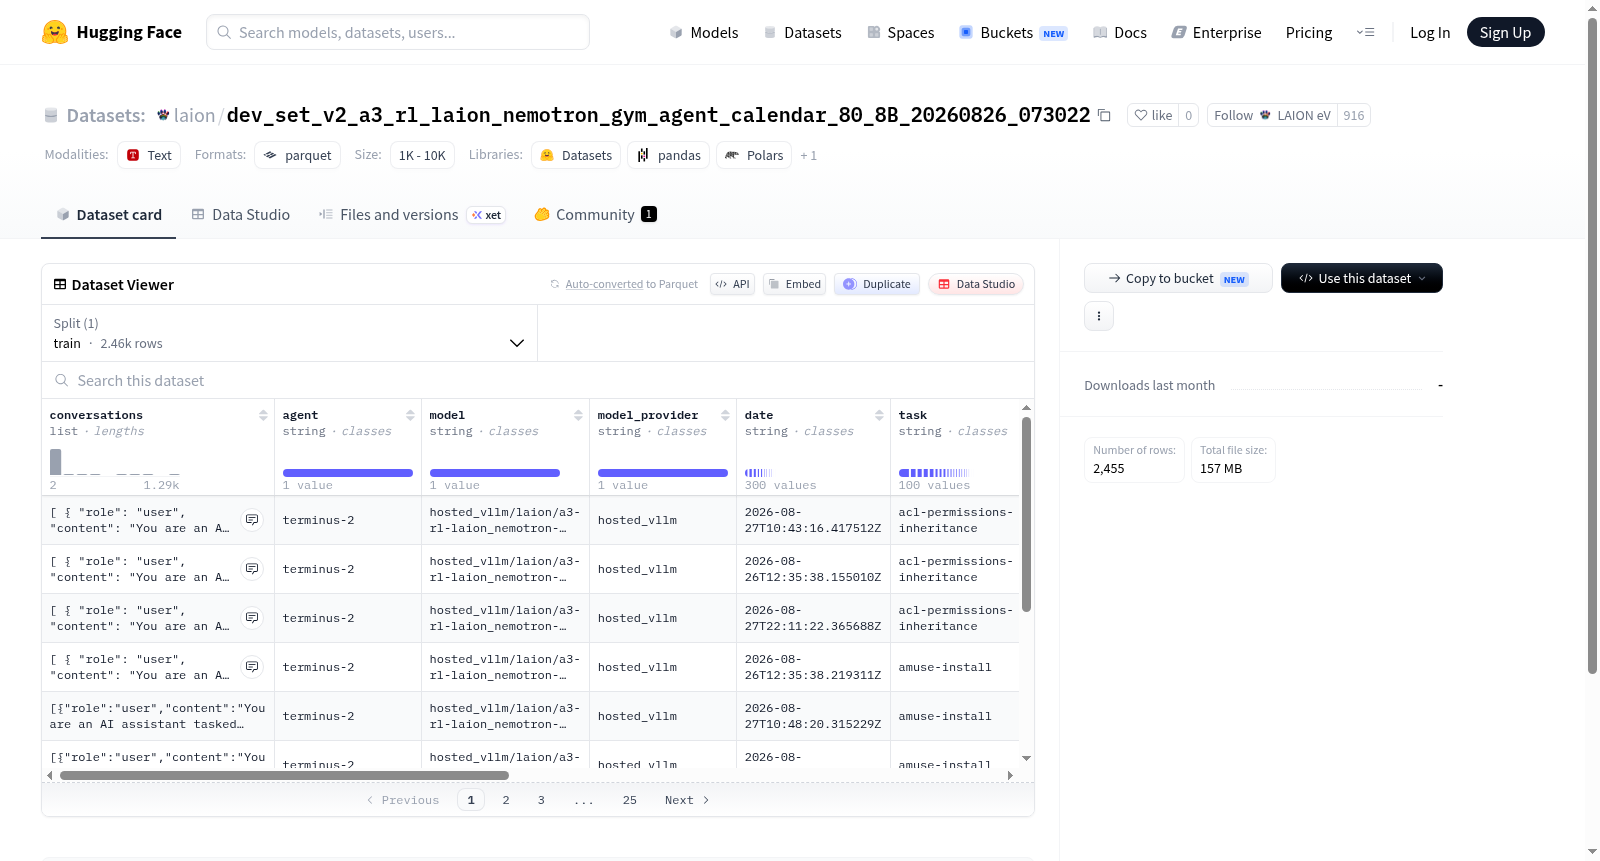
该数据集包含多轮对话交互记录,每条样本包含对话历史(conversations,每条消息有角色role和内容content)、智能体(agent)名称、使用的模型(model)及其提供商(model_provider)、日期(date)、任务(task)、轮次(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及追踪来源(trace_source)。数据集仅包含训练集,共2455个样本,总大小约180MB。适用于训练和评估对话系统、智能体行为分析、模型输出验证等任务。
This dataset contains multi-turn dialogue interaction records, with each sample including conversation history (conversations, each message has role and content), agent name, model used and its provider (model_provider), date, task, episode, run_id, trial_name, result, verifier_output, and trace_source. The dataset only contains a training set, with a total of 2455 samples and a total size of approximately 180MB. It is suitable for training and evaluating dialogue systems, agent behavior analysis, and model output verification.
数据集概述
该数据集名为 laion/dev_set_v2_a3_rl_laion_nemotron_gym_agent_calendar_80_8B_20260826_073022,由 LAION 发布,主要用于训练或评估具备日历操作能力的智能体(Agent)模型。数据集围绕 80 个日历任务场景构建,配合 8B 规模的 Nemotron 模型进行强化学习(RL)数据采集,可视为一个面向智能体日历应用的开发集(dev set)。
主要特性
- 数据类型:对话式训练数据,每条样本包含多轮对话(conversations),以及智能体行为、模型输出、任务结果等丰富的元信息。
- 适用场景:智能体(Agent)任务,具体聚焦于日历(Calendar)相关操作,适合用于指令微调、RLHF 或评估智能体任务执行能力。
- 数据规模:训练集包含 2,455 条样本,总大小约 180.9 MB(下载压缩后约 156.9 MB)。
数据字段说明
每条样本包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
列表(含 role 和 content 两个子字段) |
多轮对话历史,role 表示角色(如用户/助手),content 为对话内容 |
agent |
字符串 | 智能体标识或名称 |
model |
字符串 | 使用的模型名称(如 8B 模型) |
model_provider |
字符串 | 模型提供方 |
date |
字符串 | 数据日期 |
task |
字符串 | 任务描述或标识 |
episode |
字符串 | 强化学习的 episode 编号 |
run_id |
字符串 | 运行批次 ID |
trial_name |
字符串 | 试验名称 |
result |
字符串 | 任务执行结果 |
verifier_output |
字符串 | 验证器输出(用于评估任务是否正确) |
trace_source |
字符串 | 数据来源追踪标识 |
文件划分
- 默认配置(default):仅包含
train划分,数据文件路径为data/train-*(通配符形式,表示多个分片文件)。 - 数据总量为 2,455 条样本,所有数据在
train划分中。
使用建议
该数据集适合用于:
- 智能体模型的指令微调或强化学习训练(特别针对日历任务)。
- 评估智能体在对话场景中的任务完成能力及验证结果。
- 结合
verifier_output字段可进行奖励建模或自动评测。
注意:以上信息均来源于数据集页面提供的 README 内容,未包含额外推测或外部信息。