NYTK/alpaca_hu_2k
收藏资源简介:
该数据集是斯坦福Alpaca提示的匈牙利语翻译子集,专为微调大型语言模型以遵循指令并回答匈牙利语问题而设计。它包含2000个翻译和100个本地化的提示,结构包括指令、输入、输出、标识符和类别标签。该数据集由HUN-REN匈牙利语言学研究中心语言技术研究小组创建,采用CC-BY-NC 4.0许可。
该数据集是斯坦福Alpaca提示的匈牙利语翻译子集,专为微调大型语言模型以遵循指令并回答匈牙利语问题而设计。它包含2000个翻译和100个本地化的提示,结构包括指令、输入、输出、标识符和类别标签。该数据集由HUN-REN匈牙利语言学研究中心语言技术研究小组创建,采用CC-BY-NC 4.0许可。
数据集卡片 for Alpaca-Hu-2k
数据集详情
数据集描述
该数据集是首个用于微调大型语言模型的匈牙利语指令遵循语料库,由斯坦福Alpaca语料库的一部分翻译和本地化开发而成。它包含2000个翻译和100个本地化提示,旨在训练模型遵循指令的行为。语料库结构包括指令、输入和预期输出,辅以标识符和类别标签。该资源旨在提高语言模型在匈牙利语任务上的性能,对匈牙利计算语言学和LLM训练具有重要贡献。
- 由以下机构策划: HUN-REN匈牙利语言学研究中心,语言技术研究小组(Noémi Ligeti-Nagy 和 Zijian Győző Yang)
- 语言(NLP): hu
- 许可证: CC-BY-NC 4.0
用途
该数据集主要用于微调LLM,使其能够遵循指令和回答问题。此外,它还为研究人员和开发人员提供了宝贵的资源,旨在为匈牙利市场创建更具上下文和文化意识的AI应用。
数据集结构
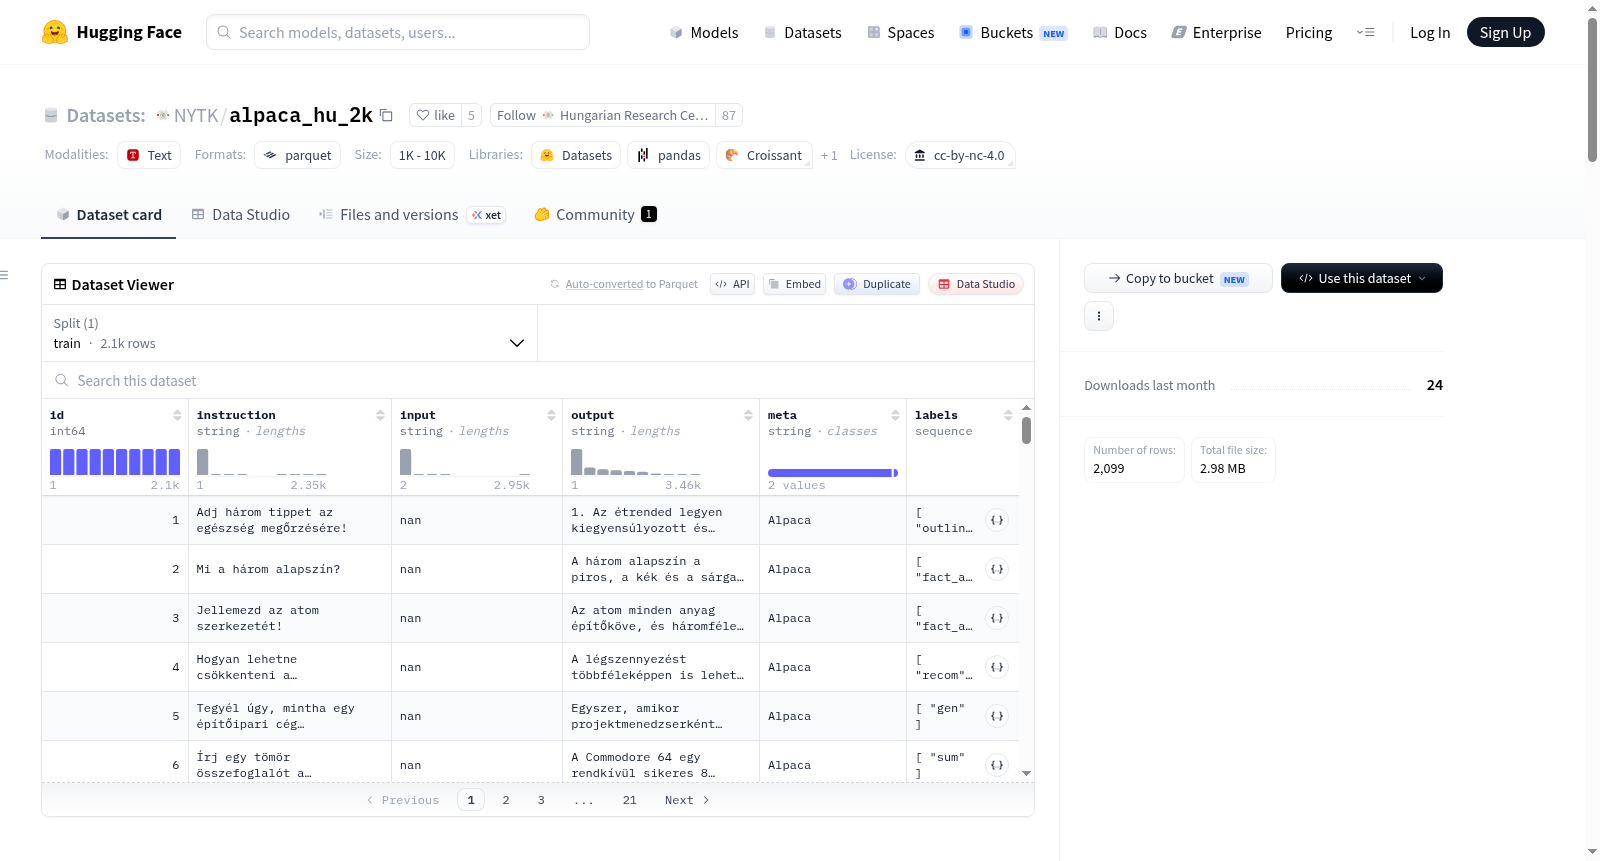
我们的语料库遵循斯坦福Alpaca数据集的结构,并在原始字段(即id、instruction、input和output)的基础上增加了labels和meta字段,以实现全面的指令遵循模型。
- id: 实例的唯一ID
- instruction: 指令或问题
- input: 输入数据或上下文,可选
- output: 答案或解决方案
- labels: 类别标签(见下表)
- meta: 关于段落来源的信息:"Alpaca"或"localized"
在语料库中,每个段落都被分配了类别标签,以便轻松识别主题。这些标签及其描述如下,用于对内容进行分类,从计算和分类到代码解释和翻译。每个段落可以属于一个或多个类别,便于有针对性的分析和数据组织。
| 标签 | 描述 |
|---|---|
| calc | 计算 |
| class | 分类(包括情感分析) |
| code_exp | 代码解释 |
| code_gen | 代码生成 |
| code_konv | 代码转换 |
| corr | 纠正 |
| design | 设计 |
| fact_ans | 事实回答 |
| gen | 表述 |
| info_ext | 信息提取 |
| keywords | 关键词提取 |
| outline | 概述 |
| quest_gen | 问题生成 |
| recom | 推荐 |
| rephrase | 改述 |
| search | 搜索 |
| sum | 总结/提取 |
| trans | 翻译 |
数据集创建
源数据
数据来自斯坦福Alpaca项目的52k提示。我们随机选择了2000个提示进行翻译。
注释
在注释指南中,我们优先考虑匈牙利语的流畅性和正确性,而不是严格忠实于原始英语文本,旨在提供适合语言模型训练的连贯和准确的翻译。主要关注提供有效、事实和相关的回答,而不是直接翻译,强调适应匈牙利语境和文化特定内容,并省略或部分翻译不可翻译的段落,如代码。此外,我们将高度专业化的提示保留下来,这些提示在翻译上存在挑战,并为每个提示添加类别标签,以便更好地分类和信息检索。
注释过程
英语提示翻译成匈牙利语的过程分为多个阶段,首先将总提示数分成每组一百个的小组。然后使用MemoQ翻译支持软件处理这些小组,该软件通过Google Cloud Translation API进行初步机器翻译。该软件确保了非可翻译元素(如标识符、标签和元数据)的一致性和准确性,这些元素存储在术语数据库中以进行质量控制。
后期编辑由Eötvös Loránd大学人文学院翻译和口译系的二年级硕士生进行,重点是达到接近人工翻译的标准,同时特别注意内容的准确性和文化相关性。每个学生的第一批翻译都由专业校对员进行审核,以确保质量和提供反馈。
后期编辑后,提示从MemoQ导回其原始格式,保持与源语言版本相同的布局。参与该项目的学生报告了积极的经验,指出该项目对他们的发展以及熟悉翻译支持软件的机会的贡献。然而,他们也强调了提示主题多样性带来的挑战,有时使得内容验证比语言审查更耗时。
注释者
后期编辑由Eötvös Loránd大学人文学院翻译和口译系的二年级硕士生进行。
引用
如果您使用此资源或其任何部分的文档,请引用:
Yang, Z. Gy. and Szlávik, Sz. and Ligeti-Nagy, N. (2024), Magyar nyelvű utasításkövető korpusz építése Stanford Alpaca promptok fordításával és lokalizálásával [Building a Hungarian instruct-following corpus by translating and localizing Stanford Alpaca prompts]. In: Berend., G. and Gosztolya, G. and Vincze, V. (eds), XX. Magyar Számítógépes Nyelvészeti Konferencia. Szeged, Szegedi Tudományegyetem. 243--255.
@inproceedings{yang-alpaca-promtps-hu, title = "{Magyar nyelvű utasításkövető korpusz építése Stanford Alpaca promptok fordításával és lokalizálásával [Building a Hungarian instruct-following corpus by translating and localizing Stanford Alpaca prompts]}", author = "Yang, Zijian Győző and Szlávik, Szilárd and Ligeti-Nagy, Noémi", booktitle = "XX. Magyar Számítógépes Nyelvészeti Konferencia.", year = "2024", address = "Szeged", publisher = "Szegedi Tudományegyetem", pages = "243--255" }