
cjiao/goldengoose-gumbel_combined_gradsim_tau1.00-25grp
收藏数据链接:
官方服务:
资源简介:
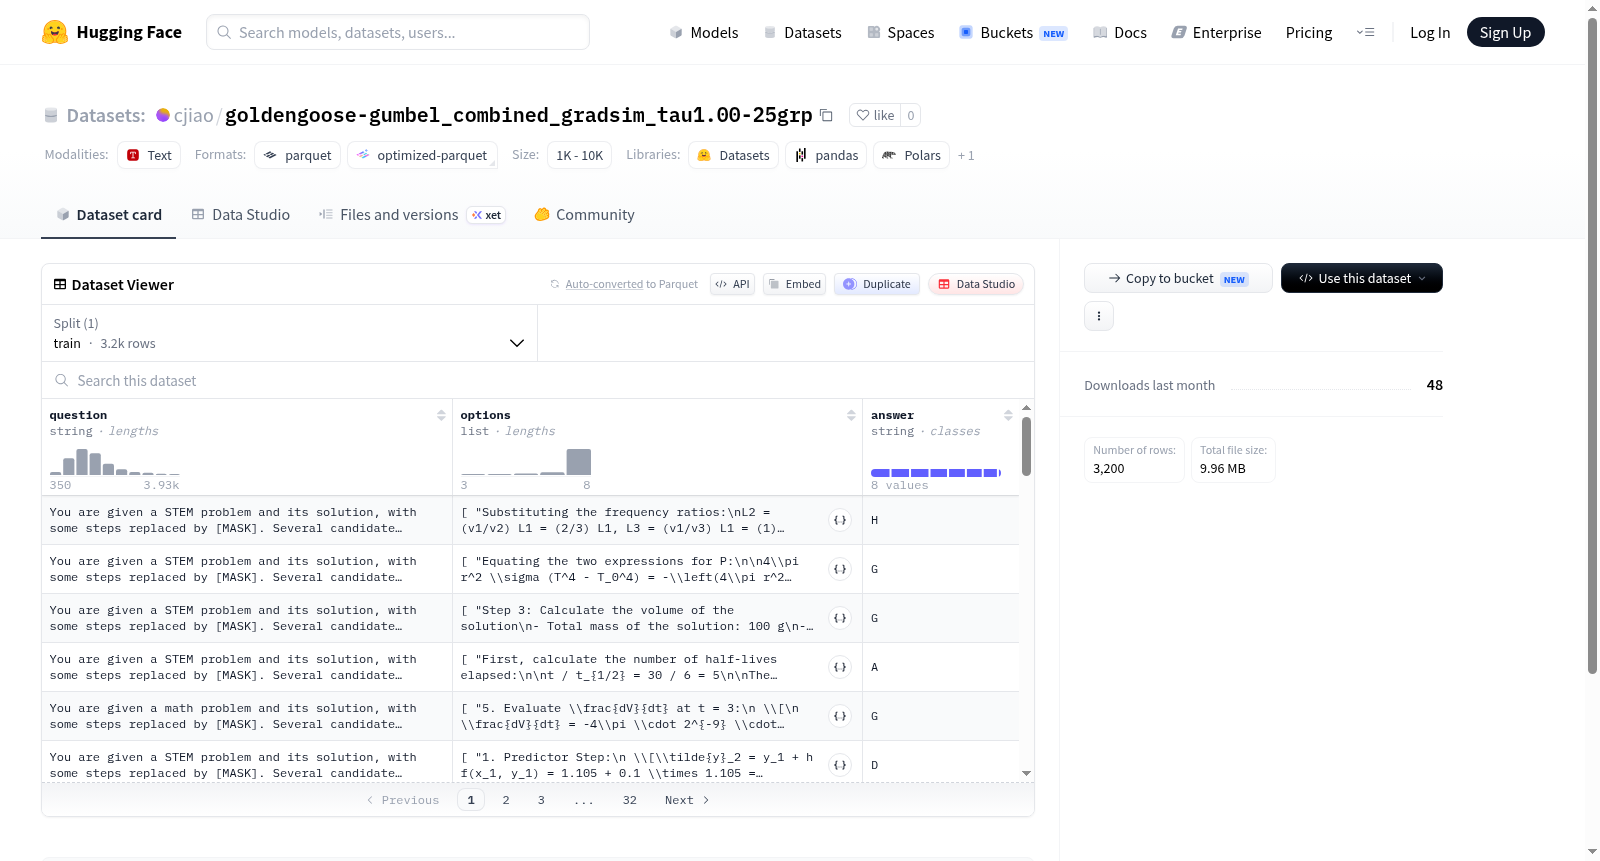
该数据集包含3200个训练样本,每个样本由问题(question)、选项列表(options)和正确答案(answer)组成,适用于问答或选择题任务。
This dataset contains 3200 training examples, each consisting of a question, a list of options, and the correct answer, suitable for question answering or multiple-choice tasks.
提供机构:
cjiao搜集汇总
数据集介绍
构建方式
该数据集基于goldengoose-gumbel系列任务构建,通过结合梯度相似性与温度系数为1.00的Gumbel采样策略,从原始数据中精选出25个分组,形成规模为3200条样本的训练集。每条样本包含问题、选项列表与标准答案三个字段,数据以Parquet格式存储于HuggingFace仓库,下载大小约9.96 MB,确保了高效的数据加载与复用。
特点
数据集具备鲜明的高质量筛选特性:采用梯度相似性度量与Gumbel软松弛技术,在温度参数1.00下构建多样性与难度平衡的样本分组。3200条训练样本覆盖了不同复杂度的问答场景,选项列表为字符串数组,支持多选逻辑,答案字段提供明确标注,便于监督学习与评估。
使用方法
用户可通过HuggingFace datasets库直接加载,使用默认配置即可获取完整训练集。加载后,数据集以字典形式提供'question'、'options'和'answer'字段,适用于文本分类、多项选择推理等任务的训练与验证。无需额外预处理,即可无缝集成至PyTorch或TensorFlow训练流水线中。
背景与挑战
背景概述
该数据集名为goldengoose-gumbel_combined_gradsim_tau1.00-25grp,其名称暗示了通过Gumbel-Softmax采样与梯度相似性度量(GradSim)相结合的方式生成,并设定了温度参数τ=1.00及25个分组。数据集创建于近年,可能源自于自然语言处理或机器推理领域的前沿研究机构,旨在探索如何通过组合结构化生成方法提升模型在复杂问题求解上的表现。其核心研究问题聚焦于利用梯度信息优化离散化推理过程,以应对多选题等需要细致区分选项的任务。尽管规模较小(仅含3200条训练样本),但该数据集在特定研究方向上具有独特价值,尤其为评估生成式模型在受限选项下的推理能力提供了基准,并可能推动对采样策略与梯度信号结合的研究进展。
当前挑战
该数据集面临的挑战首先体现在领域问题上:其核心任务为结合上下文的问题与选项进行精准作答,这要求模型具备超越简单模式匹配的语义理解与逻辑推理能力,尤其在选项高度相似或需要隐含知识推断时,模型易陷入混淆。其次,构建过程中存在显著难点:利用Gumbel-Softmax进行离散化采样虽有助于梯度传递,但温度参数τ的选取直接影响样本多样性与松弛程度,过小的τ可能导致梯度方差过大,过大的τ则易模糊离散边界,需精细调参;同时,与GradSim结合的梯度相似性计算在处理长序列或多分组时计算成本高昂,且需避免相似度度量引入偏差。此外,有限样本量(3200条)可能引发过拟合或泛化不足,需依赖数据增强或正则化策略加以缓解。
常用场景
经典使用场景
该数据集作为多模态与推理增强型问答任务的基准资源,其经典使用场景聚焦于评估和提升语言模型在复杂选择题式推理中的表现。数据集包含3,200道精心构造的训练样本,每一条数据由问题、候选选项与标准答案三元组构成,天然适配于多项选择问答(MCQA)框架。研究者通常将其作为微调或指令调优的素材,以检验模型在面对多选项知识推理时的决策能力与鲁棒性。
解决学术问题
该数据集致力于弥合当前大语言模型在细粒度逻辑推理与选项交互理解之间的鸿沟。通过提供经过梯度匹配与温度系数调控(τ=1.00)策略处理的高质量样本,有效解决了传统数据集在选项语义均衡性与噪声控制方面的不足。其意义在于为学界提供了一个可控的推理难度基准,促使研究者深入探索模型如何从候选答案中识别细微语义差异,推动理解推理中“反事实推理”与“选项间语义干扰”等核心难题。
衍生相关工作
基于该数据集的特点,衍生出一系列旨在提升模型推理稳健性与选项解耦能力的经典工作。研究者提出了诸如“选项对比预训练”策略,利用数据集的25分组(25grp)结构设计组对比学习目标;以及“梯度平滑干预”技术,通过模拟tau参数调整来增强模型对噪声选项的免疫性。另外,该数据集还被用于验证“反事实推理增强”算法,证实了其在提升多种架构(如LLaMA、Falcon)在复杂选项任务上的泛化性能。
以上内容由遇见数据集搜集并总结生成


