
gifteval-iid
收藏官方服务:
资源简介:
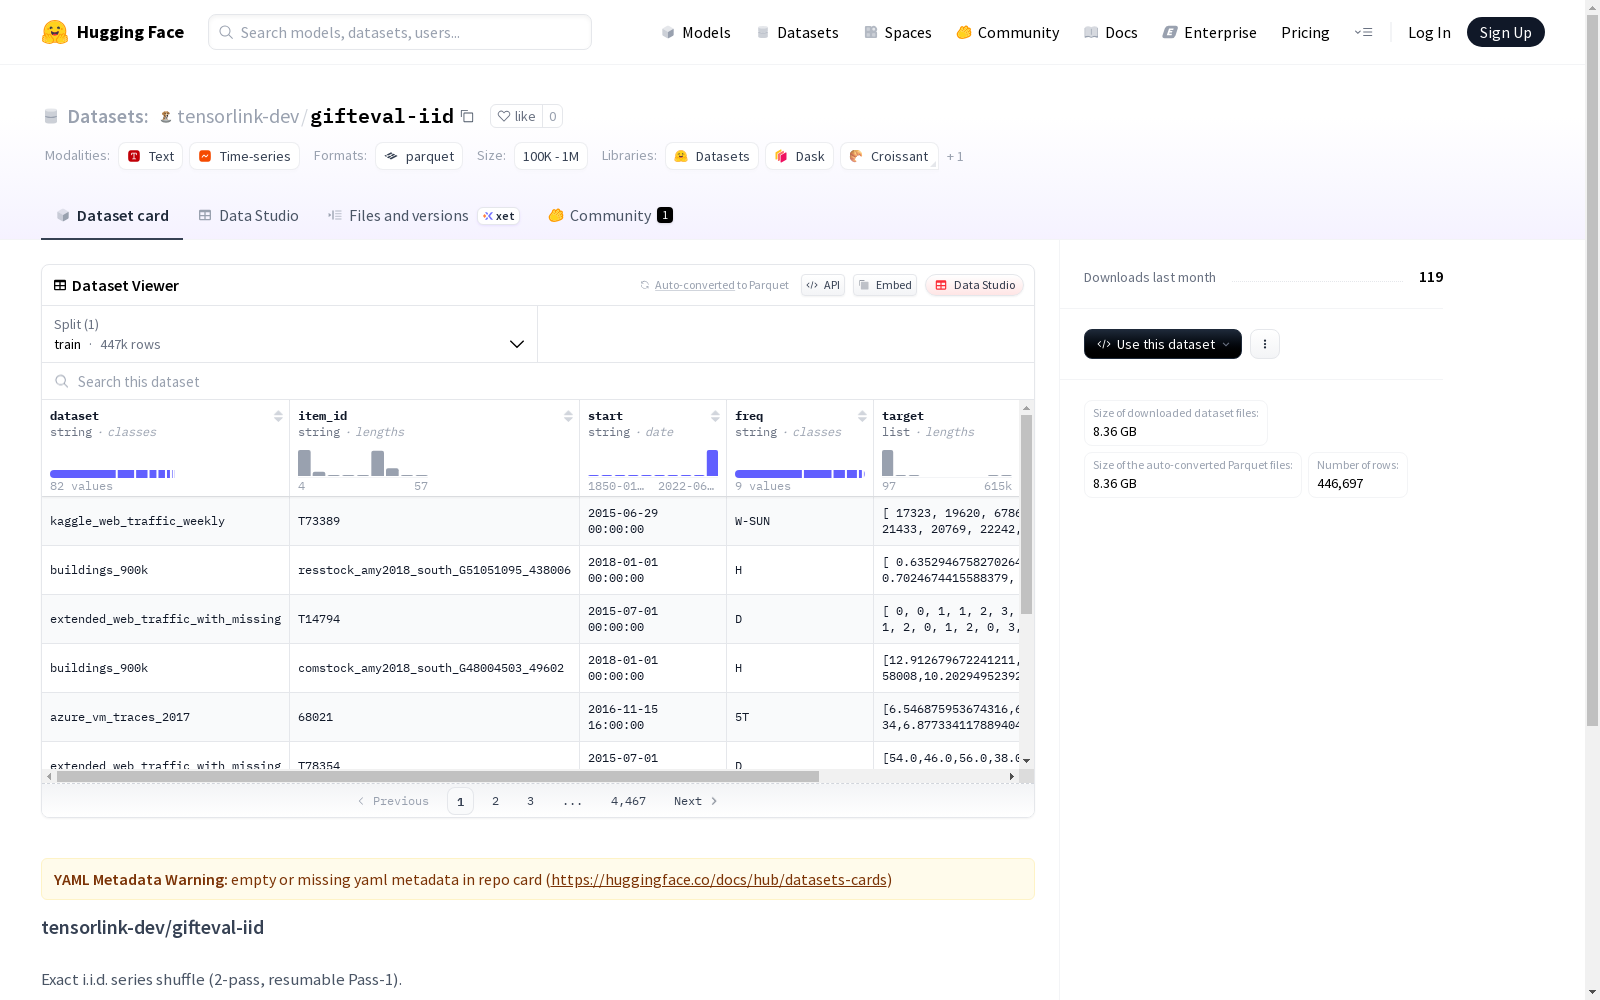
该数据集是一个 Exact i.i.d. 系列的洗牌数据集,采用两遍处理方式,第一遍可恢复。数据集被分为256个桶,目标聚合方式是取第一个元素,每个分片的最终行数是200000,桶部分使用snappy压缩,最终数据使用zstd压缩(压缩级别为1)。
This dataset is an exact i.i.d. shuffled dataset implemented via a two-pass processing workflow, where the first pass is reversible. The dataset is divided into 256 buckets, with the target aggregation strategy being to take the first element. The final number of rows per shard is 200,000. The buckets are compressed using the snappy compression algorithm, while the final dataset is compressed with zstd at compression level 1.
创建时间:
2025-10-28
原始信息汇总
数据集概述
基本信息
- 数据集名称: tensorlink-dev/gifteval-iid
- 描述: 精确独立同分布序列混洗(2-pass,可恢复Pass-1)
技术参数
- 桶数量(N_BUCKETS): 256
- 目标聚合方式(TARGET_AGG): first
- 每个分片最终行数(FINAL_ROWS_PER_SHARD): 200000
- 桶分区压缩(BUCKET_PART_COMPRESSION): snappy
- 最终压缩(FINAL_COMPRESSION): zstd(level=1)
搜集汇总
数据集介绍
构建方式
在数据科学领域,构建高质量数据集是确保模型泛化能力的关键。gifteval-iid数据集采用精确的独立同分布序列重排方法,通过两阶段处理流程实现数据均匀分布。第一阶段为可恢复的预处理,将数据划分为256个存储桶,并应用snappy压缩算法优化存储效率。第二阶段以目标聚合策略聚焦首个元素,最终每个分片包含20万行数据,并采用zstd压缩技术(级别1)确保数据完整性与访问速度。
特点
该数据集的核心特征体现在其严格的独立同分布设计上,通过多层级技术保障数据一致性。存储桶分区机制结合高效压缩算法,既降低了存储开销,又维持了数据序列的统计稳定性。分片规模经过精确计算,平衡了处理效率与内存需求,而可恢复的预处理流程为大规模数据操作提供了容错能力,使其特别适合需要高可靠性实验的机器学习场景。
使用方法
对于研究者而言,该数据集的使用需遵循其分布式架构特性。用户可直接加载预处理后的分片数据,利用内置压缩协议快速解压。在模型训练过程中,建议保持原始数据划分策略以维持分布特性,同时通过标准数据管道接口实现流式读取。该设计支持跨平台部署,用户可根据计算资源灵活调整并发处理规模,确保实验过程与数据集设计哲学的高度契合。
背景与挑战
背景概述
在数据科学与机器学习领域,数据集的构建与处理对于模型训练至关重要。gifteval-iid数据集由tensorlink-dev团队开发,专注于实现精确的独立同分布序列重排,采用两阶段处理流程并支持第一阶段的断点续传。该数据集通过256个分桶策略和首目标聚合机制,结合snappy压缩算法与zstd一级压缩技术,旨在提升数据处理的效率与可靠性,为序列建模和分布式计算研究提供标准化基准。
当前挑战
gifteval-iid数据集致力于解决序列数据中的独立同分布问题,其核心挑战在于确保数据重排的严格一致性,避免模型训练因分布偏差而性能下降。构建过程中,团队需克服大规模数据分桶与压缩的技术难题,包括优化分桶策略以减少计算开销,以及平衡压缩效率与数据完整性,这些挑战直接影响了数据集的可用性与泛化能力。
常用场景
经典使用场景
在数据工程与机器学习领域,gifteval-iid数据集通过精确的独立同分布序列重排机制,为模型训练提供了高度规范化的数据流。其经典应用体现在构建可复现的基准测试环境,支持研究者对算法在均匀分布数据上的性能进行严格评估,尤其在需要控制数据依赖性的实验中发挥核心作用。
解决学术问题
该数据集有效解决了机器学习中因数据序列偏差导致的模型过拟合问题。通过两阶段分桶压缩与分片优化,确保了数据样本的严格独立性,为研究泛化能力、训练稳定性提供了理想实验基底。这种技术路径显著提升了分布式训练场景下数据加载效率与模型收敛的可解释性。
衍生相关工作
基于该数据集的技术范式,衍生出多项关于数据流水线优化的经典研究。包括动态分桶策略改进、多模态数据混合采样框架,以及面向边缘计算的轻量级分片协议,这些工作持续推动着分布式机器学习基础设施的演进与创新。
以上内容由遇见数据集搜集并总结生成


